
Это вторая из пяти статей цикла про SAP Commerce Order Management. Первая, Процессы Order Management, которые никогда не завершаются по таймауту, была про движок процессов под OMS и про десять мест, где заказ ждёт сигнала извне. Эта статья спускается на уровень ниже, к шагу, который решает, откуда поедет товар.
Цикл посвящён механике работы в рантайме и проектным решениям по конфигурации, то есть уровню ниже прикладных руководств на SAP Help Portal. Если механизм там хорошо описан, я даю ссылку вместо пересказа и трачу место на то поведение, в котором приходится разбираться при настройке.
О коде в этой статье
Фрагменты Java ниже — это иллюстративная реконструкция: упрощённый пересказ алгоритма с переименованными переменными и свёрнутыми ветками, цель которого — показать, что делает расчёт. Это не воспроизведение какой-либо реализации, и читать их стоит как схемы. С фрагментами Spring, ImpEx и XSD иначе: это конфигурационные файлы из поставки, и я цитирую их как есть, ведь конфигурационный файл для того и существует, чтобы его читали и меняли.Выбор точки отгрузки — это задача о назначениях
Покупатель заказывает три товара. Ритейлер держит запасы в национальном распределительном центре, четырёх региональных складах и двухстах магазинах, которые одновременно работают как точки фулфилмента. Что-то должно решить, какая физическая точка отгружает какую позицию, и от этого решения зависит бо́льшая часть затрат и бо́льшая часть клиентского опыта дальше по цепочке.
Между чем приходится выбирать, в отрасли хорошо известно:
- Стоимость и скорость доставки. Ближе — дешевле и быстрее, но до определённого предела. Зональные тарифы перевозчиков делают «ближе» ступенчатой функцией, а не плавной, поэтому ближайшая точка не всегда самая дешёвая.
- Число посылок. Две посылки вместо одной примерно удваивают стоимость доставки и стабильно снижают удовлетворённость. Ради того, чтобы заказ уехал целиком, часто стоит проехать намного дальше.
- Здоровье запасов. Отгрузка из точки с самым глубоким запасом защищает сеть от будущих out-of-stock. Отгрузка из точки, которая вот-вот уценит товар, распродаёт залежавшиеся остатки. Эти две цели тянут в разные стороны, и какая из них нужна, зависит от категории.
- Персонал. Магазину, у которого сегодня уже сорок заданий на отбор, не стоит давать сорок первое, даже если он ближе всех.
- Бизнес-приоритет. Флагманский магазин, 3PL-оператор с контрактными обязательствами по объёму, склад, который компания собирается закрыть.
Подходы к объединению этих критериев выстраиваются в спектр. На простом конце — упорядоченные списки правил («сначала магазин самовывоза, потом региональный склад, потом РЦ»): о них легко рассуждать, но их трудно оптимизировать. Посередине — простое аддитивное взвешивание: каждый кандидат получает оценку по каждому критерию, оценки нормализуются к общей шкале, умножаются на веса и суммируются. На сложном конце — полноценные солверы, где сорсинг формулируется как задача смешанного целочисленного программирования по всему заказу и решается на минимум общей стоимости. Так работают крупные OMS-продукты, сделанные специально для ритейла.
SAP Commerce использует простое аддитивное взвешивание по четырём критериям, с весами, настраиваемыми для каждого base store. Для коммерческой платформы это разумный выбор, а дальше в статье разобрано, как это взвешивание ведёт себя на практике.
Как устроен шаг сорсинга
Сорсинг читает заказ и запасы и выдаёт план, ничего не записывая. Отдельный шаг аллокации превращает план в консайнменты и события по запасам; о нём будет следующая статья.
Шаги по порядку:
- Позиции заказа группируются. Позиции, которые должны ехать вместе (сейчас это позиции с общей точкой самовывоза), образуют один контекст сорсинга.
- Собираются и фильтруются склады-кандидаты.
- Для контекста выбирается стратегия сорсинга.
- Стратегия ранжирует кандидатов по fitness и распределяет количества.
- Если нераспределённые количества остались, запускается следующая стратегия, если отработавшая стратегия не помечена как терминальная.
Шаг 2 выполняется в два отдельных этапа, и при чтении Spring-конфигурации это легко пропустить: этапы лежат в разных пакетах, и только у одного из них в названии есть «sourcing».
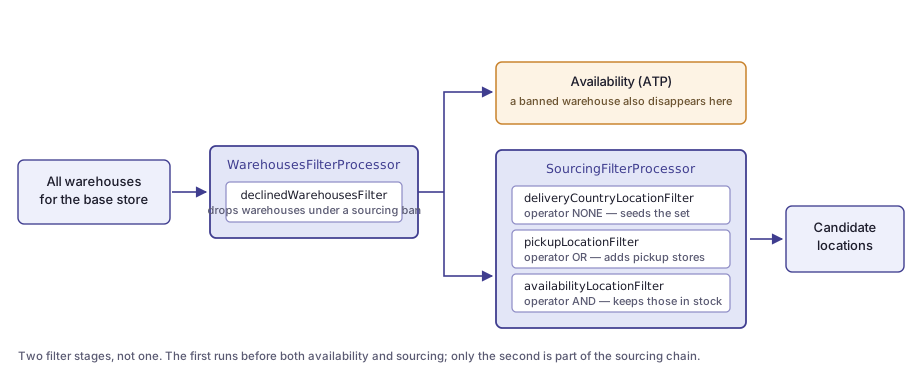
Внешний этап — WarehousesFilterProcessor из пакета warehouse.filter. Эталонный шаблон
даёт ему единственный фильтр:
<bean id="defaultWarehousesFilterProcessor"
      class="...warehouse.filter.WarehousesFilterProcessor">
  <property name="filters">
    <list>
      <ref bean="declinedWarehousesFilter"/>
    </list>
  </property>
</bean>
DeclinedWarehousesFilter убирает склады, на которых сейчас действует SourcingBan. Бан
создаётся, когда склад отклоняет консайнмент; длительность для причины «слишком загружен»
задаётся свойством и по умолчанию равна одному дню:
warehousing.ban.toobusy.days=1Этот процессор подключён ещё и к стратегии выбора складов, которой пользуется расчёт доступности. Склад, отклонивший консайнмент, выпадает не только из отбора кандидатов, но и из расчёта ATP, и витрина видит бан как снижение доступности. Нужно ли вам это, зависит от сети. В сети из десяти складов эффект трудно заметить, а при двух складах бан на время своего действия вдвое снижает доступность. Если вы хотите, чтобы баны сорсинга оставались внутри сорсинга, это изменение в одну строку.
Внутренний этап — SourcingFilterProcessor, и его фильтры комбинируются через операции над
множествами, а не выполняются простой цепочкой:
<bean id="sourcingFilterProcessor"
      class="...sourcing.filter.SourcingFilterProcessor">
  <property name="filters">
    <list>
      <ref bean="deliveryCountryLocationFilter"/>
      <ref bean="pickupLocationFilter"/>
      <ref bean="availabilityLocationFilter"/>
    </list>
  </property>
</bean>
Каждый фильтр объявляет filterResultOperator:
| Фильтр | Оператор | Действие |
|---|---|---|
deliveryCountryLocationFilter |
NONE |
заполняет множество складами, обслуживающими страну доставки |
pickupLocationFilter |
OR |
добавляет (объединением) склад за выбранной точкой самовывоза |
availabilityLocationFilter |
AND |
пересекает со складами, где товар действительно есть |
Первый фильтр в списке должен использовать NONE, потому что объединять пока не с чем.
Это требование к порядку подразумевается конфигурацией, но не проверяется ею, поэтому если
вы вставляете собственный фильтр в начало списка, дайте ему NONE, а оператор перенесите
на фильтр, который раньше был первым.
Расчёт fitness
Когда множество кандидатов готово, ранжирование — это один вложенный цикл по матрице.
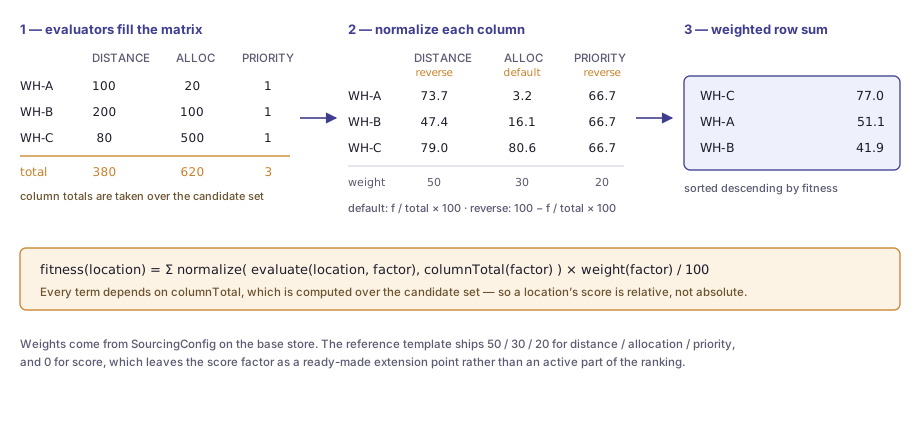
В эталонном шаблоне четыре фактора, у каждого есть evaluator, который выдаёт сырое число, и нормализатор, который переводит его в диапазон 0–100:
| Фактор | Вес по умолчанию | Сырое значение | Normalizer |
|---|---|---|---|
DISTANCE |
50 | километры до адреса доставки | reverse |
ALLOCATION |
30 | суммарное доступное количество по товарам группы | default |
PRIORITY |
20 | Warehouse.priority, целое число |
reverse |
SCORE |
0 | Warehouse.score, double |
default |
Веса хранятся в SourcingConfig, привязанном к base store, то есть задаются для каждого
base store отдельно и меняются в рантайме без деплоя. В руководствах SAP и в проектных
шаблонах встречаются и другие примерные раскладки; значение имеет то, что записано в вашей
собственной строке SourcingConfig, а любое значение по умолчанию — лишь отправная точка.
SCORE поставляется с весом 0: фактор полностью подключён, но бездействует, пока
проект не начнёт заполнять Warehouse.score из какого-нибудь внешнего показателя
эффективности.
Оба нормализатора умещаются в одну строку:
// иллюстрация
double normalizeDefault(double value, double columnTotal) {
    if (Double.isNaN(value) || Double.isNaN(columnTotal)) {
        return 0d;
    }
    return value / columnTotal * 100d;
}

// иллюстрация
double normalizeReverse(double value, double columnTotal) {
    if (Double.isNaN(value) || Double.isNaN(columnTotal)) {
        return 0d;
    }
    return 100d - value / columnTotal * 100d;
}
«Default» означает «больше — лучше», «reverse» — «меньше — лучше». Расстояние и приоритет используют обратную форму, поэтому приоритет 1 ранжируется выше приоритета 5.
И само ранжирование:
// иллюстрация
double[][] matrix = new double[locations][factors];
double[] columnTotal = new double[factors];

// проход 1 - оценка с накоплением суммы по каждому столбцу
for (int l = 0; l < locations; l++) {
    for (int f = 0; f < factors; f++) {
        matrix[l][f] = evaluatorFor(f).evaluate(location(l));
        columnTotal[f] += matrix[l][f];
    }
}

// проход 2 - нормализация по столбцу, затем взвешивание и сумма
for (int l = 0; l < locations; l++) {
    double fitness = 0d;
    for (int f = 0; f < factors; f++) {
        double norm = normalizerFor(f)
                .normalize(matrix[l][f], columnTotal[f]);
        fitness += norm * weightOf(f) / 100d;
    }
    result[l] = withFitness(location(l), fitness);
}

sortDescendingByFitness(result);
Чтобы добавить фактор, нужны новый бин evaluator, запись в мапе и столбец весов. В следующих двух разделах разобраны свойства этой формулировки, из-за которых на реальных данных получаются неожиданные результаты.
Fitness зависит от набора кандидатов
Нормализация делит на сумму по столбцу среди кандидатов, участвующих в этом запуске. Поэтому оценка точки — это доля от столбца, и она меняется, когда меняется набор кандидатов.
Чаще всего этого не видно, потому что добавление или удаление кандидата масштабирует все оценки в столбце на один и тот же множитель, и порядок сохраняется. Всё меняется, когда суммы двух факторов сдвигаются в разной пропорции: разрыв между двумя точками в одном столбце сокращается быстрее, чем в другом.
Возьмём заказ из двух позиций по пять единиц, который обрабатывает NoSplittingStrategy;
она ищет одну точку, способную покрыть всё.
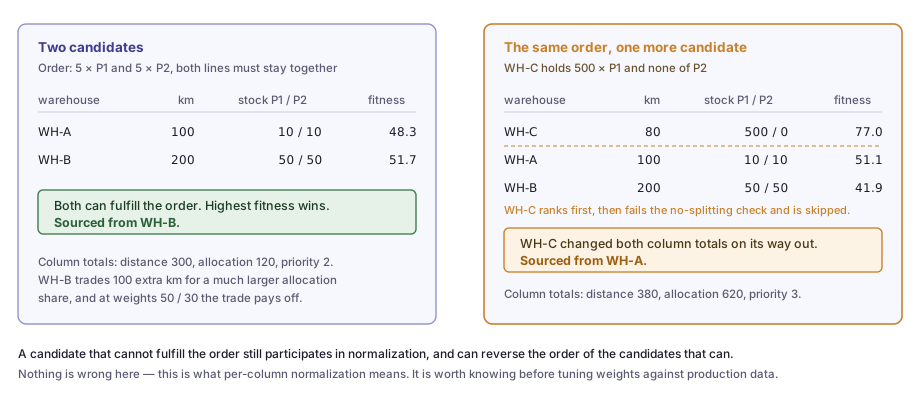
При двух кандидатах побеждает WH-B: он на 100 км дальше, но запас у него в пять раз больше, и при весах 50 / 30 преимущество по аллокации перевешивает штраф за расстояние.
Теперь в набор кандидатов попадает третий склад. WH-C находится рядом и держит 500 единиц первого товара и ни одной второго, так что выполнить этот заказ в одиночку он не может. Стратегия проранжирует его, обнаружит, что проверку на отсутствие разбиения он не проходит, и пропустит. Но в обе суммы по столбцам он уже внёс вклад: небольшой в расстояние и очень большой в аллокацию. Разрыв по аллокации между A и B сжимается гораздо сильнее, чем разрыв по расстоянию, и теперь побеждает WH-A.
Так работает нормализация по столбцам в любой модели простого аддитивного взвешивания, и это влияет на то, как такую модель настраивать.
Подбор весов по агрегированным продакшен-данным менее надёжен, чем кажется, потому что одни и те же веса дают разное ранжирование в зависимости от того, сколько кандидатов прошло фильтры для конкретного заказа. При настройке фиксируйте набор кандидатов и меняйте по одному фактору за раз.
Фильтры тоже участвуют в оценке. Фильтр, который отсекает неправдоподобного кандидата,
улучшает ранжирование всех остальных, поэтому ужесточить SourcingFilterProcessor дешевле,
чем перебалансировать веса.
Если относительная оценка вашему бизнесу не подходит, можно написать собственный
FitnessNormalizer, который переводит сырое значение в абсолютную шкалу (например, километры
относительно фиксированного потолка в 500 км), и зарегистрировать его в fitnessNormalizerMap
для нужных факторов. Нормализатор получает сумму по столбцу и вправе её игнорировать.
Как работает фактор расстояния
Значение — это расстояние по дуге большого круга в километрах, вычисленное по формуле
гаверсинусов с радиусом Земли 6372,8 км. Дороги и время в пути оно не учитывает. В плотной
городской застройке и везде, где мешают реки, горы или границы, ошибка систематическая и
всегда в одну сторону. Проекты, которым это важно, обычно заменяют DistanceEvaluator на
реализацию, которая обращается к сервису маршрутизации и агрессивно кеширует, ведь evaluator
вызывается для каждого кандидата при каждой попытке сорсинга.
Чтобы вычислить расстояние, у адреса доставки должны быть координаты. Их записывает
GeocodeShippingAddressAction — шаг процесса заказа, который выполняется непосредственно
перед сорсингом и полностью пропускается для заказов с самовывозом. Он делегирует работу
бину geoServiceWrapper.
Эталонная реализация за этим алиасом — заглушка, которая возвращает координаты для любого адреса и никогда не сообщает об ошибке:
<alias alias="geoServiceWrapper"
       name="defaultCommerceMockGeoWebServiceWrapper"/>
<bean id="defaultCommerceMockGeoWebServiceWrapper"
      class="...storelocator.impl.CommerceMockGeoWebServiceWrapper">
  <property name="baseStoreService" ref="baseStoreService"/>
  <property name="countryIsoGPSLocationMap"
            ref="countryIsoGPSLocationMap"/>
</bean>
В countryIsoGPSLocationMap девять стран — CN, JP, US, GB, GG, IM, JE, DE, CA — плюс
DEFAULT с широтой 0 и долготой 0. Любой адрес в стране из списка геокодируется в одну и ту
же фиксированную точку этой страны; любой адрес в остальном мире — в Гвинейский залив.
Получается, что на свежеустановленной системе фактор расстояния измеряет расстояние от
каждого склада до одной из десяти фиксированных точек на Земле. Все заказы с доставкой в одну
и ту же страну дают одинаковое ранжирование по расстоянию независимо от реального адреса. Для
демо и интеграционных тестов этого достаточно, а подключение настоящего геокодера —
задокументированный и несложный шаг: замена алиаса на GoogleMapsServiceWrapper занимает две
строки. Я упоминаю это потому, что до такой замены результаты сорсинга выглядят вполне
правдоподобно, и её легко отложить на потом, а затем потратить день на выяснение, почему
ближайший магазин никогда не выигрывает.
Одна отсутствующая координата выключает весь фактор
Второе свойство расстояния касается и всех остальных факторов.
DistanceSourcingLocationPopulator записывает в расстояние null в пяти разных случаях:
у заказа нет адреса доставки; у склада нет точки обслуживания; у точки обслуживания нет
адреса; у адреса заказа нет широты или долготы; у точки обслуживания нет широты или долготы.
В каждом случае пишется строка уровня INFO, и обработка идёт дальше.
// иллюстрация
if (deliveryAddress == null) {
    log.info("no delivery address; distance is null");
    target.setDistance(null);
    return;
}
PointOfServiceModel pos = posSelection.get(order, warehouse);
if (pos == null || pos.getAddress() == null) {
    log.info("no usable point of service; distance is null");
    target.setDistance(null);
    return;
}
// ... проверки широты и долготы устроены так же ...
target.setDistance(haversine(posLat, posLon, addrLat, addrLon));
DistanceEvaluator превращает этот null в Double.NaN. Первый проход добавляет каждое
сырое значение в сумму по столбцу, так что одного NaN достаточно, чтобы вся сумма по
столбцу стала NaN. Второй проход передаёт эту сумму нормализатору, а тот возвращает 0,
если любой из аргументов — NaN, причём для каждой строки, включая те, где расстояние
корректное.
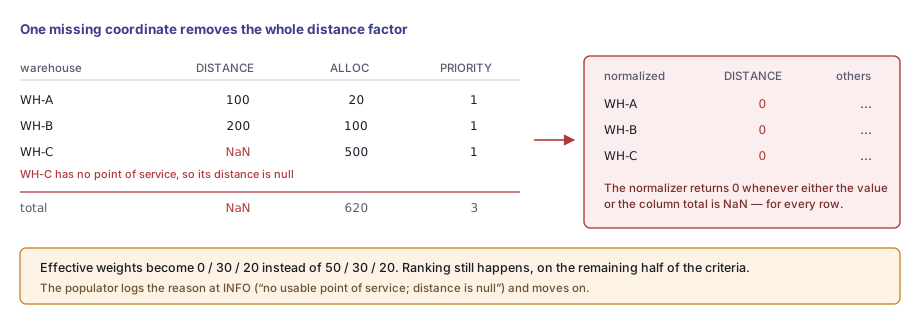
Фактические веса становятся 0 / 30 / 20. Сорсинг по-прежнему выдаёт правдоподобный ответ с обычным выводом в лог, но для этого заказа расстояние больше не учитывает. Для этого достаточно одного распределительного центра без привязанной точки обслуживания или одного магазина, адрес которого импортировали без координат.
Тот же механизм действует и для других факторов. Warehouse.priority — это Integer без
значения по умолчанию, поэтому у склада, созданного через ImpEx без явного приоритета, там
null, и он убирает фактор приоритета из каждого заказа, в котором участвует как кандидат.
У Warehouse.score значение по умолчанию 0, так что с ним безопаснее, но проект, который
заполняет его из внешнего источника, может снова получить ту же дыру.
На проекте, который полагается на сорсинг, я бы добавил в пайплайн деплоя проверку данных:
у каждого склада, который может стать кандидатом сорсинга, есть точка обслуживания с
координатами и непустой приоритет. Ещё я бы добавил собственные evaluator'ы, которые вместо
NaN подставляют заданное запасное значение (большое расстояние для неизвестной точки,
средний приоритет для незаданного), чтобы пробел в данных ухудшал оценку одного кандидата, а
не выключал целый критерий.
Фактор аллокации измеряет глубину запаса
AllocationFitnessEvaluator суммирует по всем позициям заказа в контексте сорсинга доступное
в точке количество товара каждой позиции:
// иллюстрация
double evaluate(SourcingLocation location) {
    long total = 0L;
    for (AbstractOrderEntryModel entry : contextEntries(location)) {
        Long available = location.getAvailability()
                                 .get(entry.getProduct());
        total += (available == null) ? 0L : available;
    }
    return (double) total;
}
Это мера глубины запаса в паре с нормализатором default, то есть больше — лучше. С точки зрения бизнеса это значит «предпочитай точку, где товар закончится с наименьшей вероятностью», и для сети, где длинный хвост лучше сохранять, чем распродавать, это обоснованное значение по умолчанию.
Название наводит на другую мысль, поэтому скажу прямо: фактор не измеряет, какую часть заказа точка может покрыть, и не измеряет, сколько останется нераспределённым. Точка с 1000 единиц получает оценку намного выше, чем точка ровно с теми 10, которые нужны заказу, хотя обе покрывают заказ полностью. Суммирование по позициям вместо минимума даёт тот же эффект: точка с большим запасом одного товара и нулём другого может обойти точку, где есть понемногу всего.
Правильная ли это цель — вопрос бизнеса, и ответ зависит от категории. Если вам нужно
покрытие, а не глубина, изменение небольшое и изолированное: собственный evaluator,
возвращающий нераспределённый остаток и зарегистрированный в fitnessEvaluatorMap под ключом
ALLOCATION:
// иллюстрация - меньше значит лучше, поэтому при регистрации
// ставьте в пару нормализатор reverse
double evaluate(SourcingLocation location) {
    long shortfall = 0L;
    for (AbstractOrderEntryModel entry : contextEntries(location)) {
        long needed = unallocatedQuantity(entry);
        long available = availabilityOf(location, entry);
        shortfall += Math.max(0L, needed - available);
    }
    return (double) shortfall;
}
Evaluator'у, у которого меньше значит лучше, нужен нормализатор reverse, а
fitnessNormalizerMap индексируется по фактору, поэтому меняйте обе записи вместе, иначе
фактор инвертируется. Именно здесь чаще всего ошибаются с собственными факторами:
инвертированный фактор не бросает исключение и ставит худшего кандидата на первое место.
Стратегии сорсинга и флаг terminal
Стратегия сорсинга решает, как ранжированные кандидаты превращаются в назначения. Эталонный шаблон поставляет три стратегии.
NoSplittingStrategy ранжирует кандидатов и берёт первого, кто может полностью покрыть
каждую позицию группы. Если такого нет, она ничего не назначает и помечает результат как
неполный.
// иллюстрация
List<SourcingLocation> ranked = fitnessService.sortByFitness(ctx);
ranked.stream()
      .filter(loc -> coversEveryLine(ctx.getOrderEntries(), loc))
      .findFirst()
      .ifPresent(best -> ctx.getResult().getResults()
              .add(resultFactory.create(ctx.getOrderEntries(), best)));
ctx.getResult().setComplete(isFullyAssigned(ctx));
NoRestrictionsStrategy проходит по ранжированному списку и забирает из каждой точки
сколько может, пока заказ не будет покрыт. Это жадный проход без глобальной цели, и число
посылок получается как следствие ранжирования.
Две стратегии выполняются последовательно, сначала NoSplittingStrategy, — так эталонный
шаблон выражает принцип «лучше одна посылка, но можно и несколько». Если для вашего бизнеса
важнее всего, чтобы заказ уехал целиком, учтите, что у этого предпочтения нет веса: оно
выражено только порядком в списке. Проекту, которому нужен настраиваемый компромисс, нужна
стратегия, явно назначающая стоимость разбиению.
PickupStrategy обслуживает click-and-collect. Её выбирает маппер, а не позиция в
списке:
<bean id="pickupSourcingStrategyMapper"
      class="...strategy.mapper.impl.PickupSourcingStrategyMapper">
  <property name="strategy" ref="pickupSourcingStrategy"/>
</bean>
Маппер срабатывает, когда у каждой позиции контекста есть deliveryPointOfService. Логика
после этого тривиальна, потому что точку покупатель уже выбрал сам.
Ещё в бине задано свойство, которое другие стратегии оставляют по умолчанию:
<bean id="defaultSourcingPickupStrategy"
      class="...sourcing.strategy.impl.PickupStrategy"
      parent="abstractSourcingStrategy">
  <property name="posSelectionStrategy" ref="posSelectionStrategy"/>
  <property name="terminal" value="true"/>
</bean>
terminal="true" останавливает цепочку стратегий. Если в выбранном магазине товара не
хватает, стратегия назначает то, что есть, помечает контекст как неполный, и больше никакая
стратегия не запускается. Заказ с самовывозом никогда не перенаправляется в другую точку.
Я считаю это правильным поведением по умолчанию: покупатель, который выбрал магазин, чтобы
прийти туда, не хочет, чтобы его заказ без спроса отправили откуда-то ещё.
Но это значит, что частичное выполнение самовывоза становится вопросом бизнес-процесса, а не сорсинга. Остаток лежит нераспределённым, пока кто-то или что-то на него не отреагирует, и решить, что именно (уведомить и ждать, предложить разбиение, перевести остаток в доставку), нужно в проектном чек-листе. Эталонный шаблон оставляет это открытым, и при запуске с неизменённым шаблоном это легко упустить.
Чек-лист перед запуском
Проектные решения из этой статьи:
| Область | Что решить |
|---|---|
| Геокодирование | заменить заглушку; проверить, что координаты попадают в адреса, а не в точки стран |
| Данные складов | у каждого кандидата есть точка обслуживания с координатами и непустой приоритет |
| Запасные значения факторов | собственные evaluator'ы возвращают заданное значение вместо NaN |
| Веса | задать SourcingConfig для каждого base store по своей модели затрат, а не по значениям по умолчанию |
Семантика ALLOCATION |
убедиться, что вам нужна именно глубина запаса, а не покрытие |
| Баны сорсинга | решить, должен ли отклонивший склад выпадать ещё и из ATP |
| Фильтры | ужесточить SourcingFilterProcessor, ведь фильтры влияют не только на состав кандидатов, но и на оценки |
| Нехватка при самовывозе | определить, что происходит с остатком, когда в магазине самовывоза не хватает товара |
| Стоимость разбиения | если число посылок важно, задать ему явную стоимость, а не полагаться на порядок стратегий |
Большая часть этого — изменения конфигурации или небольшие бины; сам движок можно оставить как есть.
Следующая статья цикла (не знаю, как скоро..): доступность к продаже без резервирования. Расчёт ATP собирается через рефлексию из элемента формулы, чьи булевы свойства сопоставляются с именами методов DAO, а количества, определяющие состояние заказа (allocated, shipped, pending, unallocated), — динамические атрибуты, и это напрямую сказывается на всех, кто пытается строить по ним отчёты в SQL.
Discussion
Powered by GitHub Discussions — sign in with a GitHub account to join the conversation.