
Это первая из пяти статей цикла про SAP Commerce Order Management. Цикл написан на основе установки 2211 и посвящён механике работы в рантайме и проектным решениям, которые лежат на уровень ниже обзорных руководств на SAP Help Portal. Там, где что-то уже хорошо описано в официальной документации, я даю ссылку, а не пересказываю.
Начать я хочу с ожидания, потому что именно в ожидании заказы и умирают.
О коде в этой статье
Фрагменты Java ниже — это иллюстративная реконструкция: пересказ, цель которого — показать, что делает движок, с намеренно упрощёнными именами и структурой. Это не воспроизведение какой-либо реализации, и читать их стоит как схемы. С фрагментами ImpEx и XSD иначе: это конфигурационные файлы из поставки, и я цитирую их как есть, ведь весь смысл определения процесса в том, что его можно прочитать и изменить.Заказ почти всё время простаивает
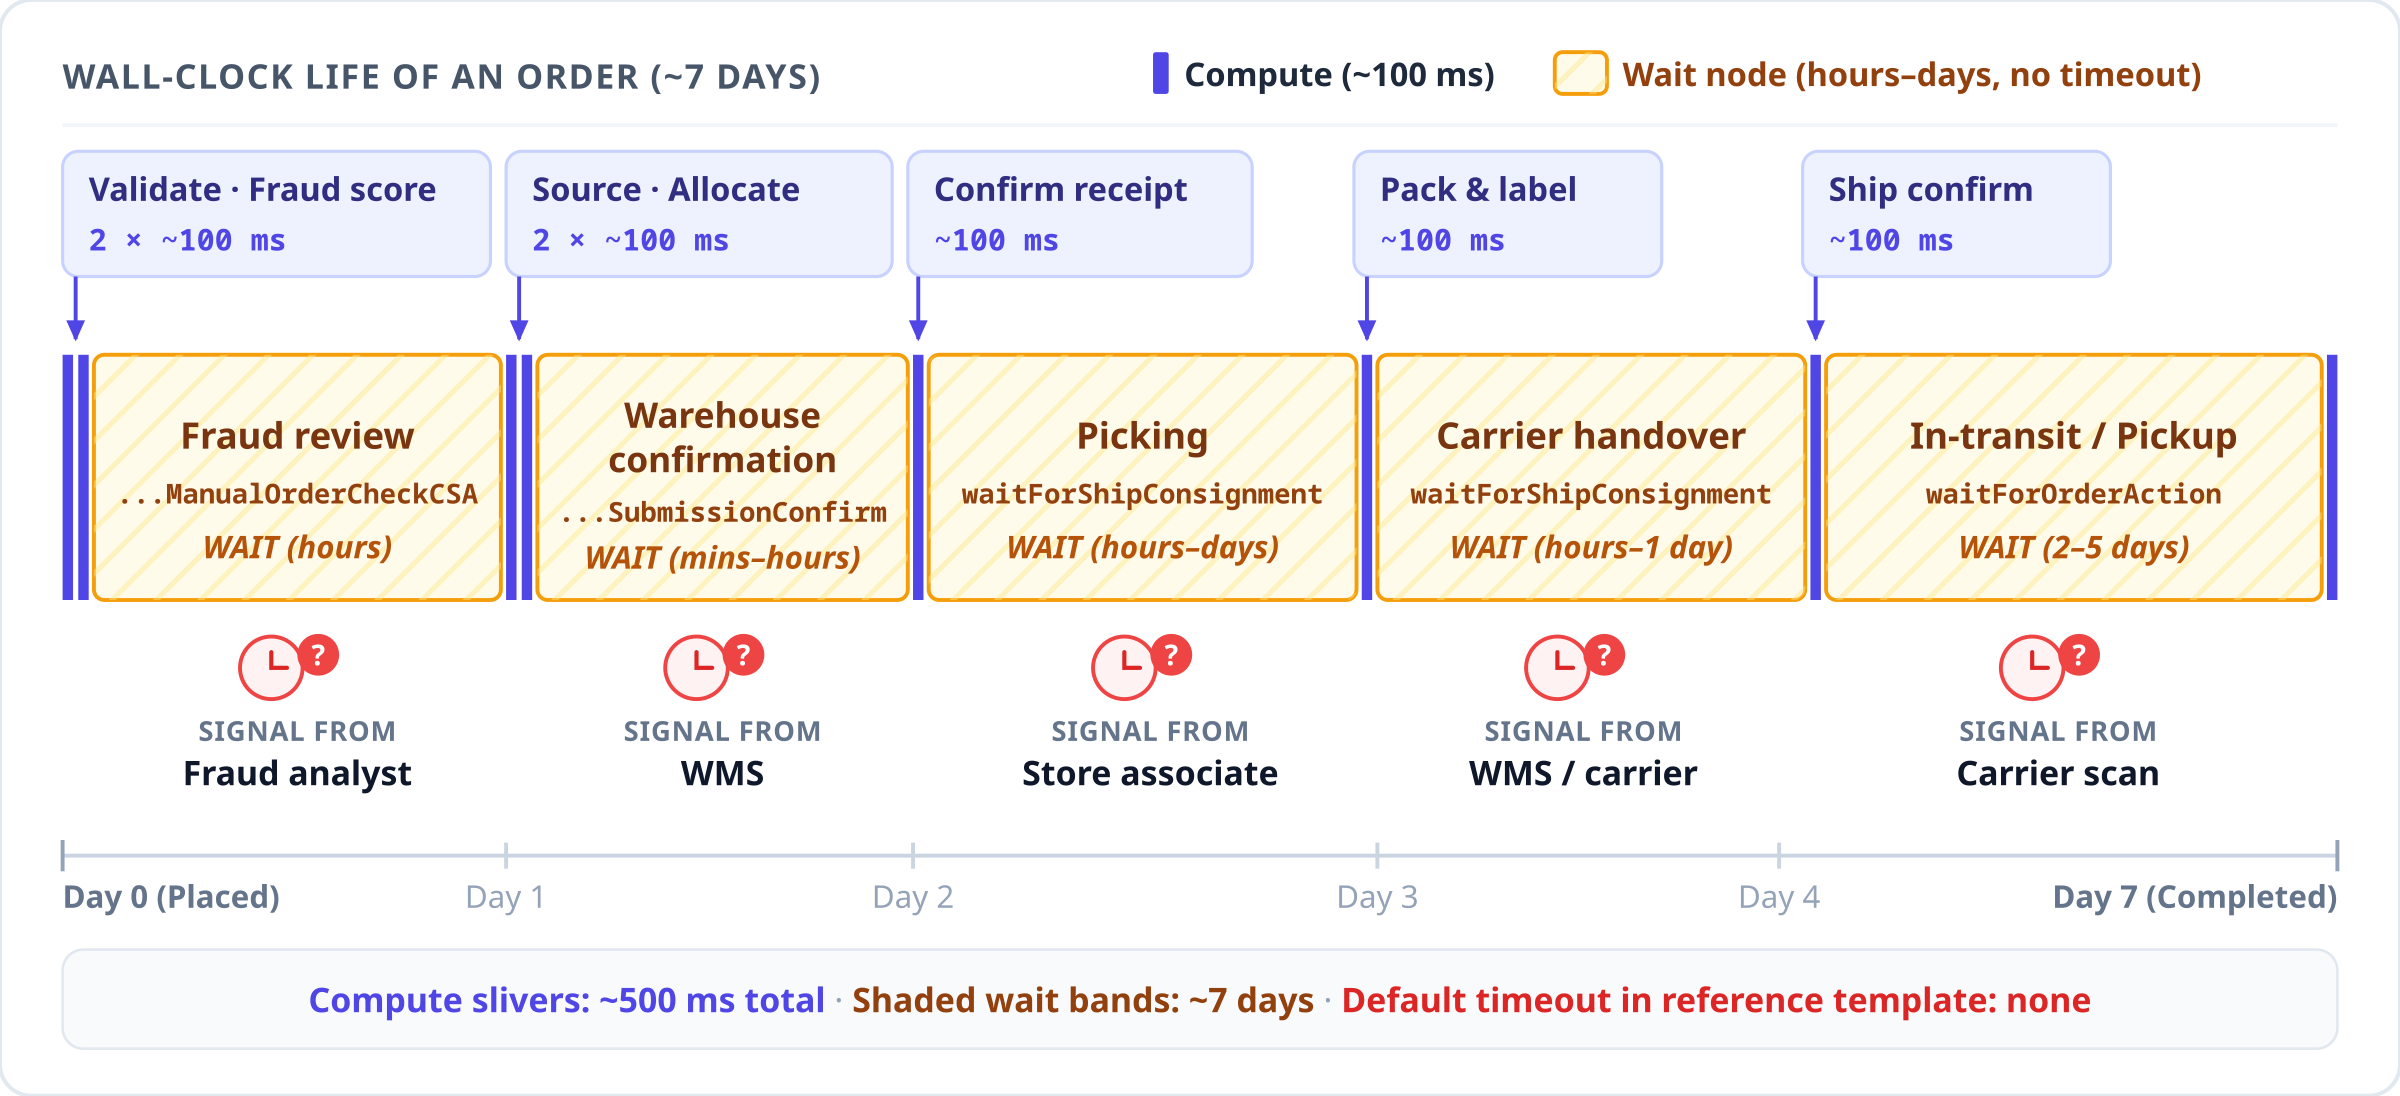
Возьмите любую систему управления заказами, в любом продукте, и измерьте, на что уходит реальное время. Расчёт цены, проверка на фрод, запрос остатков и выбор склада вместе занимают несколько сотен миллисекунд. Всё остальное — ожидание: пока фрод-аналитик посмотрит на помеченный заказ, пока склад подтвердит, что получил лист отбора, пока сборщик соберёт заказ, пока перевозчик заберёт посылку, пока покупатель дойдёт до магазина, пока возвращённая посылка доедет до депо, пока платёжный шлюз проведёт возврат денег.
Поэтому коммерческая платформа должна моделировать долгоживущее состояние, которое продвигается по внешним сигналам. Это инженерная задача другого рода, чем обработка запросов, и ломается она по-другому. Преобладают два сценария отказа:
Сигнал так и не приходит. Интеграция со складом теряет сообщение, продавец уходит в отпуск с одиннадцатью назначенными на него заданиями на сборку, внешняя система фулфилмента отвечает 200 OK и потом обо всём забывает. Заказ стоит в корректном, согласованном и навсегда неподвижном состоянии. Ничего не сломано так, чтобы это заметила хоть одна проверка работоспособности.
Сигнал приходит в форме, которую процесс не принимает. Событие срабатывает, но с payload, которого определение не знает, или сразу с двумя противоречащими друг другу указаниями. Теперь процессу приходится выбирать: проигнорировать событие, упасть или угадать.
Отраслевая практика здесь давно устоялась, и её стоит проговорить явно, потому что она
даёт нам точку отсчёта. В BPMN есть граничные события таймера: к состоянию прикрепляются
часы, и, когда время выходит, токен покидает состояние по другому пути. Temporal и похожие
движки durable execution дают workflow.await(timeout) с явным дедлайном на каждом
блокирующем вызове. В архитектурах на сообщениях используют dead-letter-очереди и политику
повторной доставки. И почти все, независимо от движка, в итоге приходят к одному и тому же
операционному артефакту: дашборду или отчёту со списком заказов, которые не меняли
состояние N часов, сгруппированных по состоянию, в котором они застряли.
Общее во всём этом то, что моделируется само отсутствие события. У него есть длительность, пункт назначения и владелец.
Как SAP Commerce моделирует ожидание
Order Management работает на движке процессов платформы, том же, на котором построены письма с подтверждением заказа и B2B-процессы согласования. Здесь важны три процесса, и это отдельные бизнес-процессы с отдельными жизненными циклами:
| Процесс | Область | Чем создаётся |
|---|---|---|
order-process |
заказ целиком | оформление заказа |
consignment-process |
одно отправление | аллокация |
return-process |
одна заявка на возврат | создание заявки на возврат |
Первое, что стоит знать: эти три определения не скомпилированы в расширение. Они —
данные. Каждое из них — это ImpEx-файл, который вставляет DynamicProcessDefinition,
где атрибут content содержит XML процесса:
INSERT_UPDATE DynamicProcessDefinition;code[unique=true];active;content
;order-process;true;"<?xml version='1.0' encoding='UTF-8'?>
<process xmlns='http://www.hybris.de/xsd/processdefinition'
         start='checkOrder' name='order-process'
         processClass='...OrderProcessModel'>
...
</process>"
Лежат они в yacceleratorordermanagement/resources/impex/, по файлу на процесс. Значит,
форма жизненного цикла заказа на вашем проекте — это строка в таблице базы данных, а не
изменение кода, и для всей остальной статьи это важно: каждый пункт чек-листа ниже
закрывается правкой этой строки.
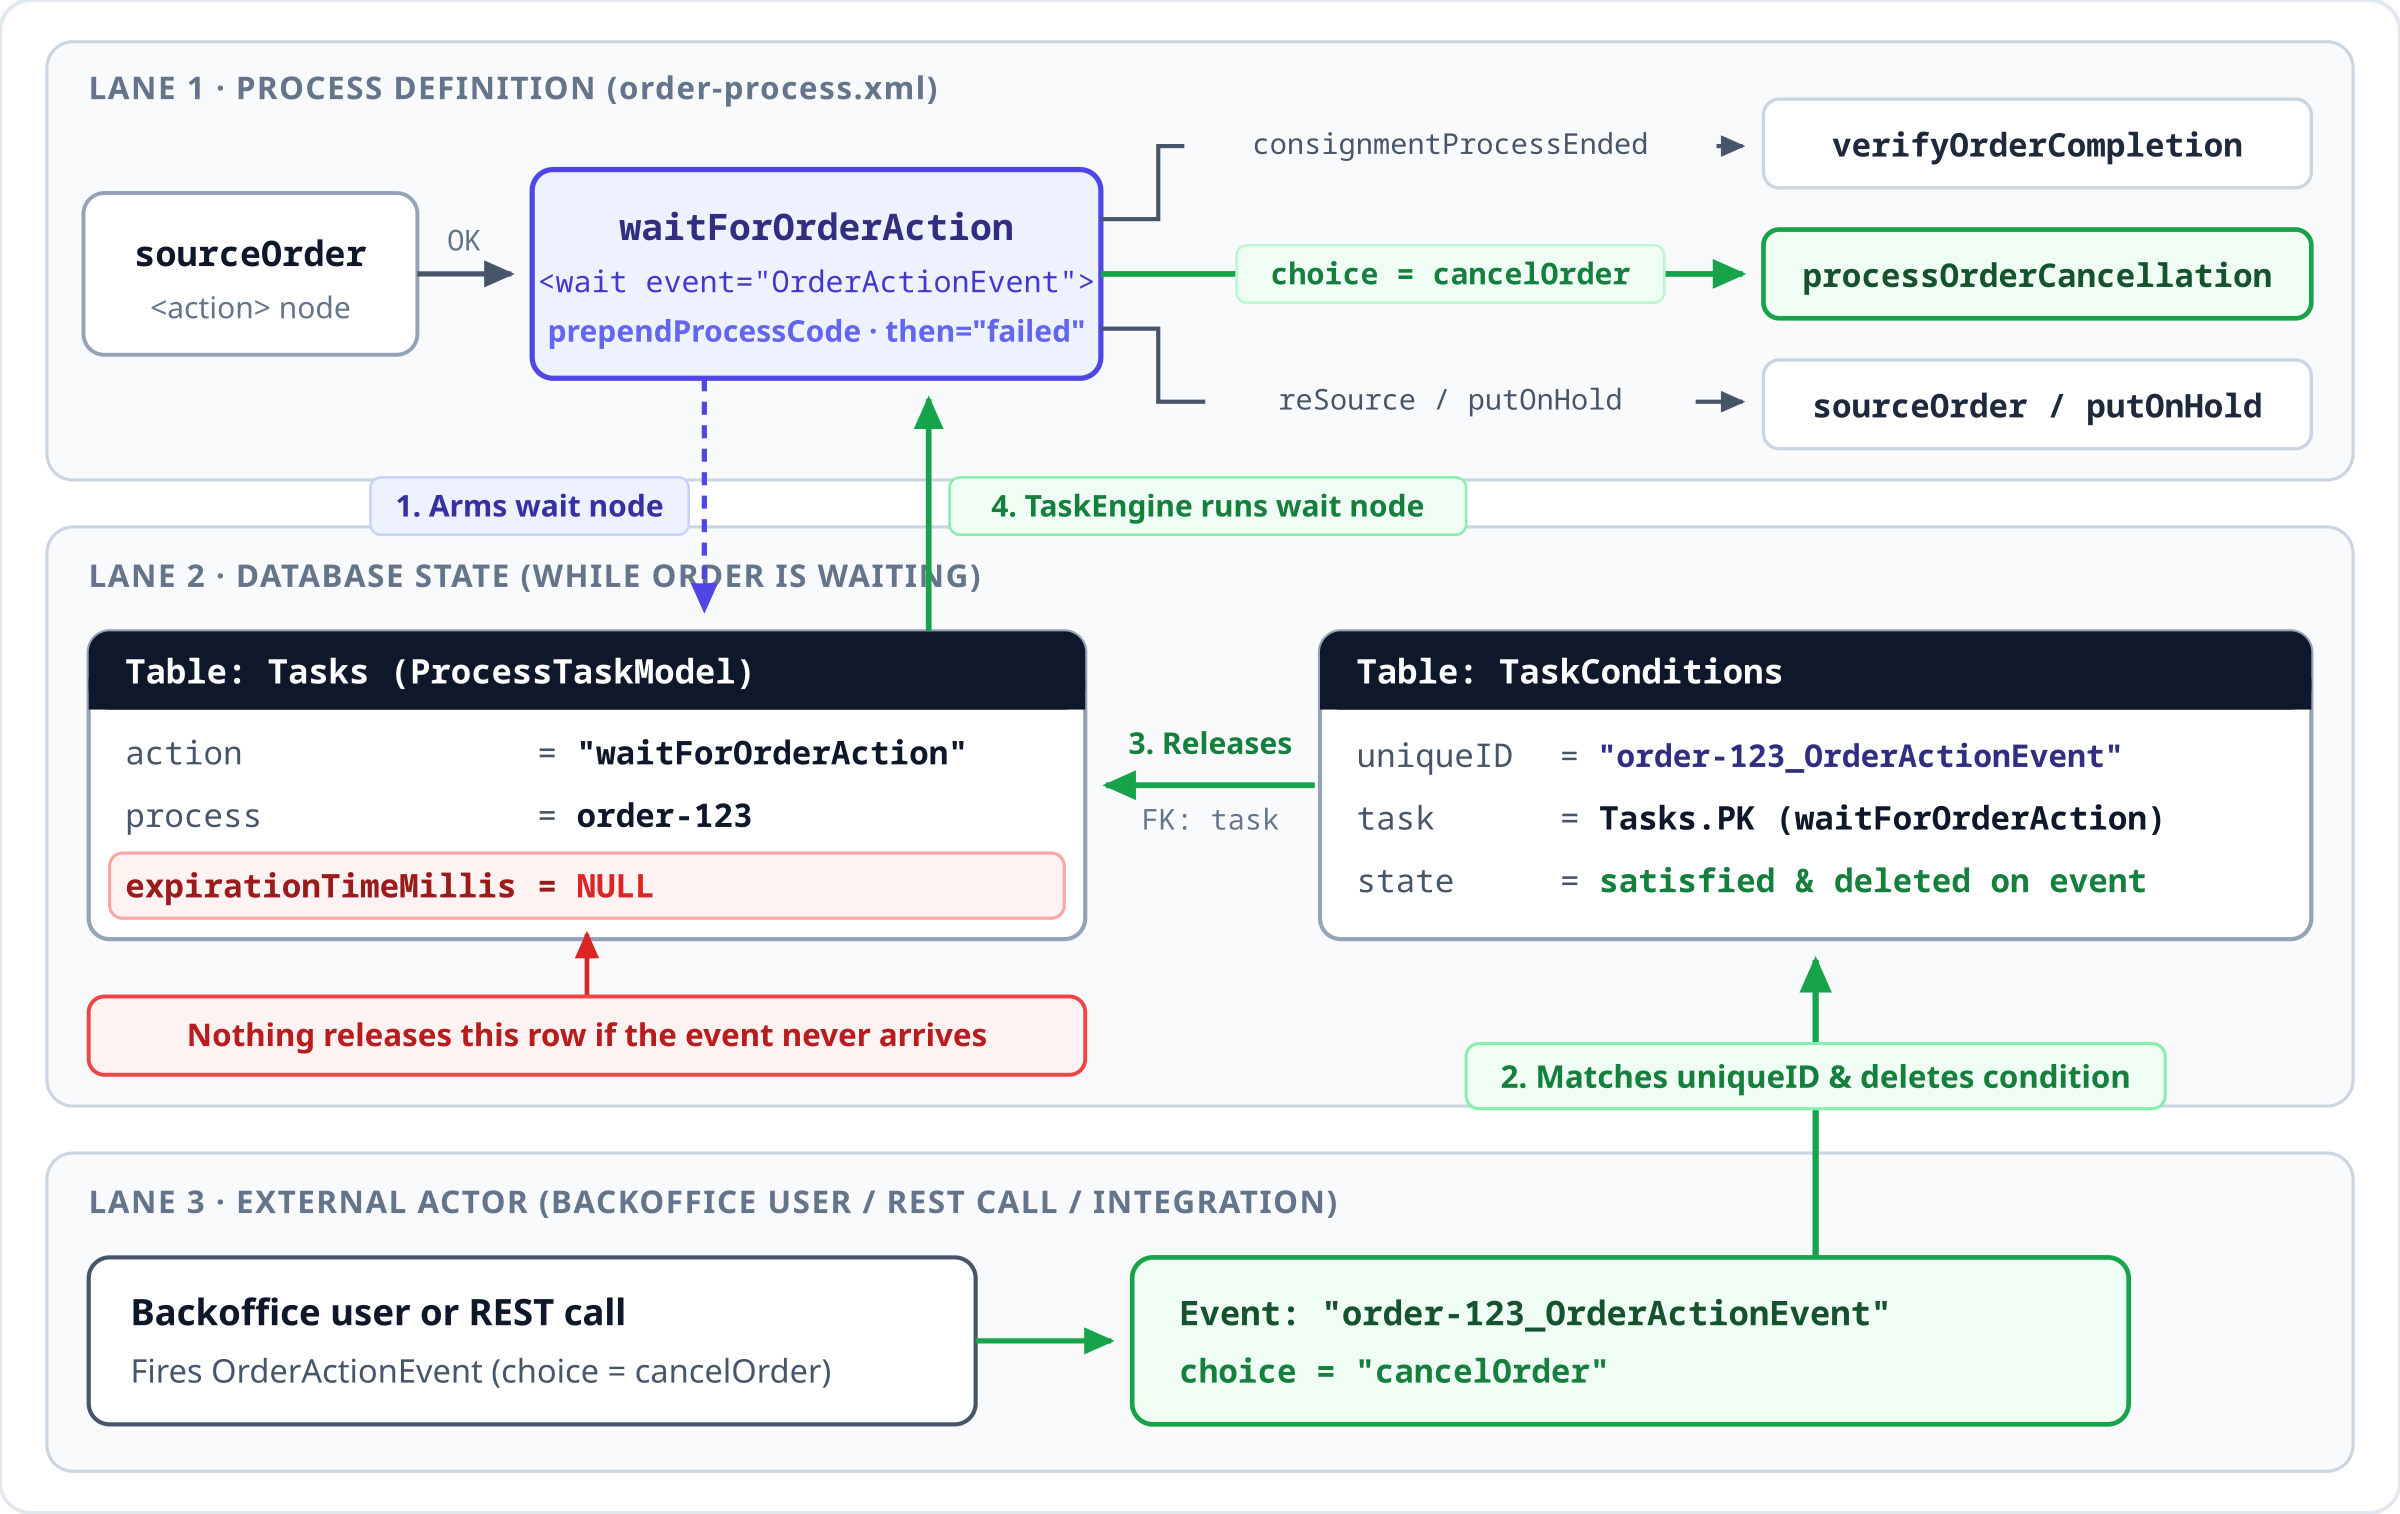
Узел типа <wait> приостанавливает процесс, пока не сработает именованное событие.
Реализация небольшая, и в ней стоит разобраться, потому что она объясняет и сценарии отказа,
и способ их исправить. Когда процесс доходит до узла ожидания, движок создаёт задачу
с прикреплённым к ней условием и возвращает управление. Реконструкция:
// иллюстрация
void trigger(BusinessProcessModel process) {
    ProcessTaskModel task = new ProcessTaskModel();
    task.setRunnerBean("taskRunner");
    task.setAction(nodeId);
    task.setProcess(process);

    TaskConditionModel condition =
        modelService.create(TaskConditionModel.class);
    String code = evaluateEventName(eventExpression, process);
    if (prependProcessCode) {
        code = process.getCode() + "_" + code;
    }
    condition.setUniqueID(code);
    task.setConditions(Set.of(condition));

    // <- ветка, о которой эта статья
    if (timeout.isConfigured()) {
        task.setExpirationTimeMillis(timeout.getExpirationTime());
    }
    taskManager.scheduleTask(task);
}
Получается, ожидающий заказ — это строка в Tasks, связанная со строкой в TaskConditions,
у которой uniqueID равен имени события, которое слушает процесс. Срабатывание события
выполняет это условие; затем движок задач подхватывает задачу, и процесс идёт дальше. Никто
ничего не опрашивает, никто не держит поток, и перезапуск ноды ничего не меняет, потому что
всё состояние лежит в базе данных. С точки зрения надёжности это очень хорошая схема.
Имя события проходит через Groovy
Одна деталь в этой реконструкции заслуживает внимания, потому что её легко пропустить и она часто удивляет тех, кто впервые замечает её в профайлере.
Имя события в узле ожидания не используется буквально. Его оборачивают в кавычки и вычисляют как выражение Groovy, где в области видимости есть процесс и его контекстные параметры. Именно поэтому в определении процесса отправления можно написать так:
<wait id='waitForPreFulfillmentProcessToFinish'
      then='processConsignmentPreFulfillment'
      prependProcessCode='false'>
  <event>${process.code}_ProcessConsignmentPreFulfillmentEvent</event>
</wait>
${process.code} — это плейсхолдер GString, который разрешается в момент, когда узел
ожидания взводится. Так ожидание связывают с одним конкретным исходящим вызовом, а не
с процессом целиком: в имя события можно подставить всё, что достижимо из процесса или его
контекстных параметров, поэтому кастомная интеграция может взвести ожидание, которое
выполнит только её собственный колбэк.
Обратная сторона в том, что каждый вход в узел ожидания запускает скриптовый движок, даже для
константной строки вроде CSAOrderVerified. На высоконагруженной установке это складывается
в заметный объём работы Groovy, и на это стоит посмотреть, если движок задач загружен сильнее,
чем можно было бы ожидать при таких объёмах.
Десять мест, где заказ ждёт
Вот полный список, вычитанный из трёх поставляемых определений процессов. Я привожу его целиком, потому что сам список и есть аргумент.
| # | Процесс | Узел ожидания / событие | Чего ждёт |
|---|---|---|---|
| 1 | order | waitForManualOrderCheckCSACSAOrderVerified |
пока человек снимет пометку о фроде с заказа |
| 2 | order | waitForOrderActionOrderActionEvent |
любого действия на уровне заказа в течение всей его жизни |
| 3 | consignment | waitForPreFulfillmentProcessToFinish${process.code}_ProcessConsignmentPreFulfillmentEvent |
отчёта от кастомного шага перед фулфилментом |
| 4 | consignment | waitForConsignmentSubmissionConfirmation${process.code}_ConsignmentSubmissionConfirmationEvent |
подтверждения получения от внешней системы фулфилмента |
| 5 | consignment | waitForShipConsignmentConsignmentActionEvent |
сборки, упаковки, отгрузки, отмены или переаллокации |
| 6 | consignment | waitForPickupConsignmentConsignmentActionEvent |
того же для отправления с самовывозом |
| 7 | return | waitForConfirmOrCancelReturnActionConfirmOrCancelRefundEvent |
пока оператор одобрит или отклонит возврат |
| 8 | return | waitForGoodsActionApproveOrCancelGoodsEvent |
пока товар физически приедет и будет принят |
| 9 | return | waitForFailCaptureActionFailCaptureActionEvent |
пока человек решит, что делать с неудавшимся возвратом денег |
| 10 | return | waitForFailTaxReverseActionFailTaxReverseEvent |
пока человек решит, что делать с неудавшимся сторно налога |
Каждое из них — вполне законное место для ожидания. Заказ на проверке на фрод действительно
должен стоять там, пока кто-нибудь на него не посмотрит. Отправление действительно должно
стоять в waitForShipConsignment, пока склад что-нибудь не сделает.
Вопрос в том, что будет, если никто так ничего и не сделает.
Как «никогда» выглядит за квартал
Чтобы перевести это в цифры, я смоделировал небольшой бизнес: около 2100 отправлений в день,
70% из них идут из распределительного центра, работающего в две смены шесть дней в неделю,
30% отгружаются из магазинов, открытых с 10:00 до 20:00 и закрытых по воскресеньям. Время
сборки берётся из реалистичных распределений по рабочим часам, и небольшая доля отправлений
так и не получает свой ConsignmentActionEvent: 0,3% для РЦ (потерянное сообщение), 1,0% для
магазинов (продавец, который так и не открыл задание). Вместе это примерно одно отправление
из двухсот. График показывает, сколько отправлений стоит в waitForShipConsignment каждый
час в течение 90 дней.
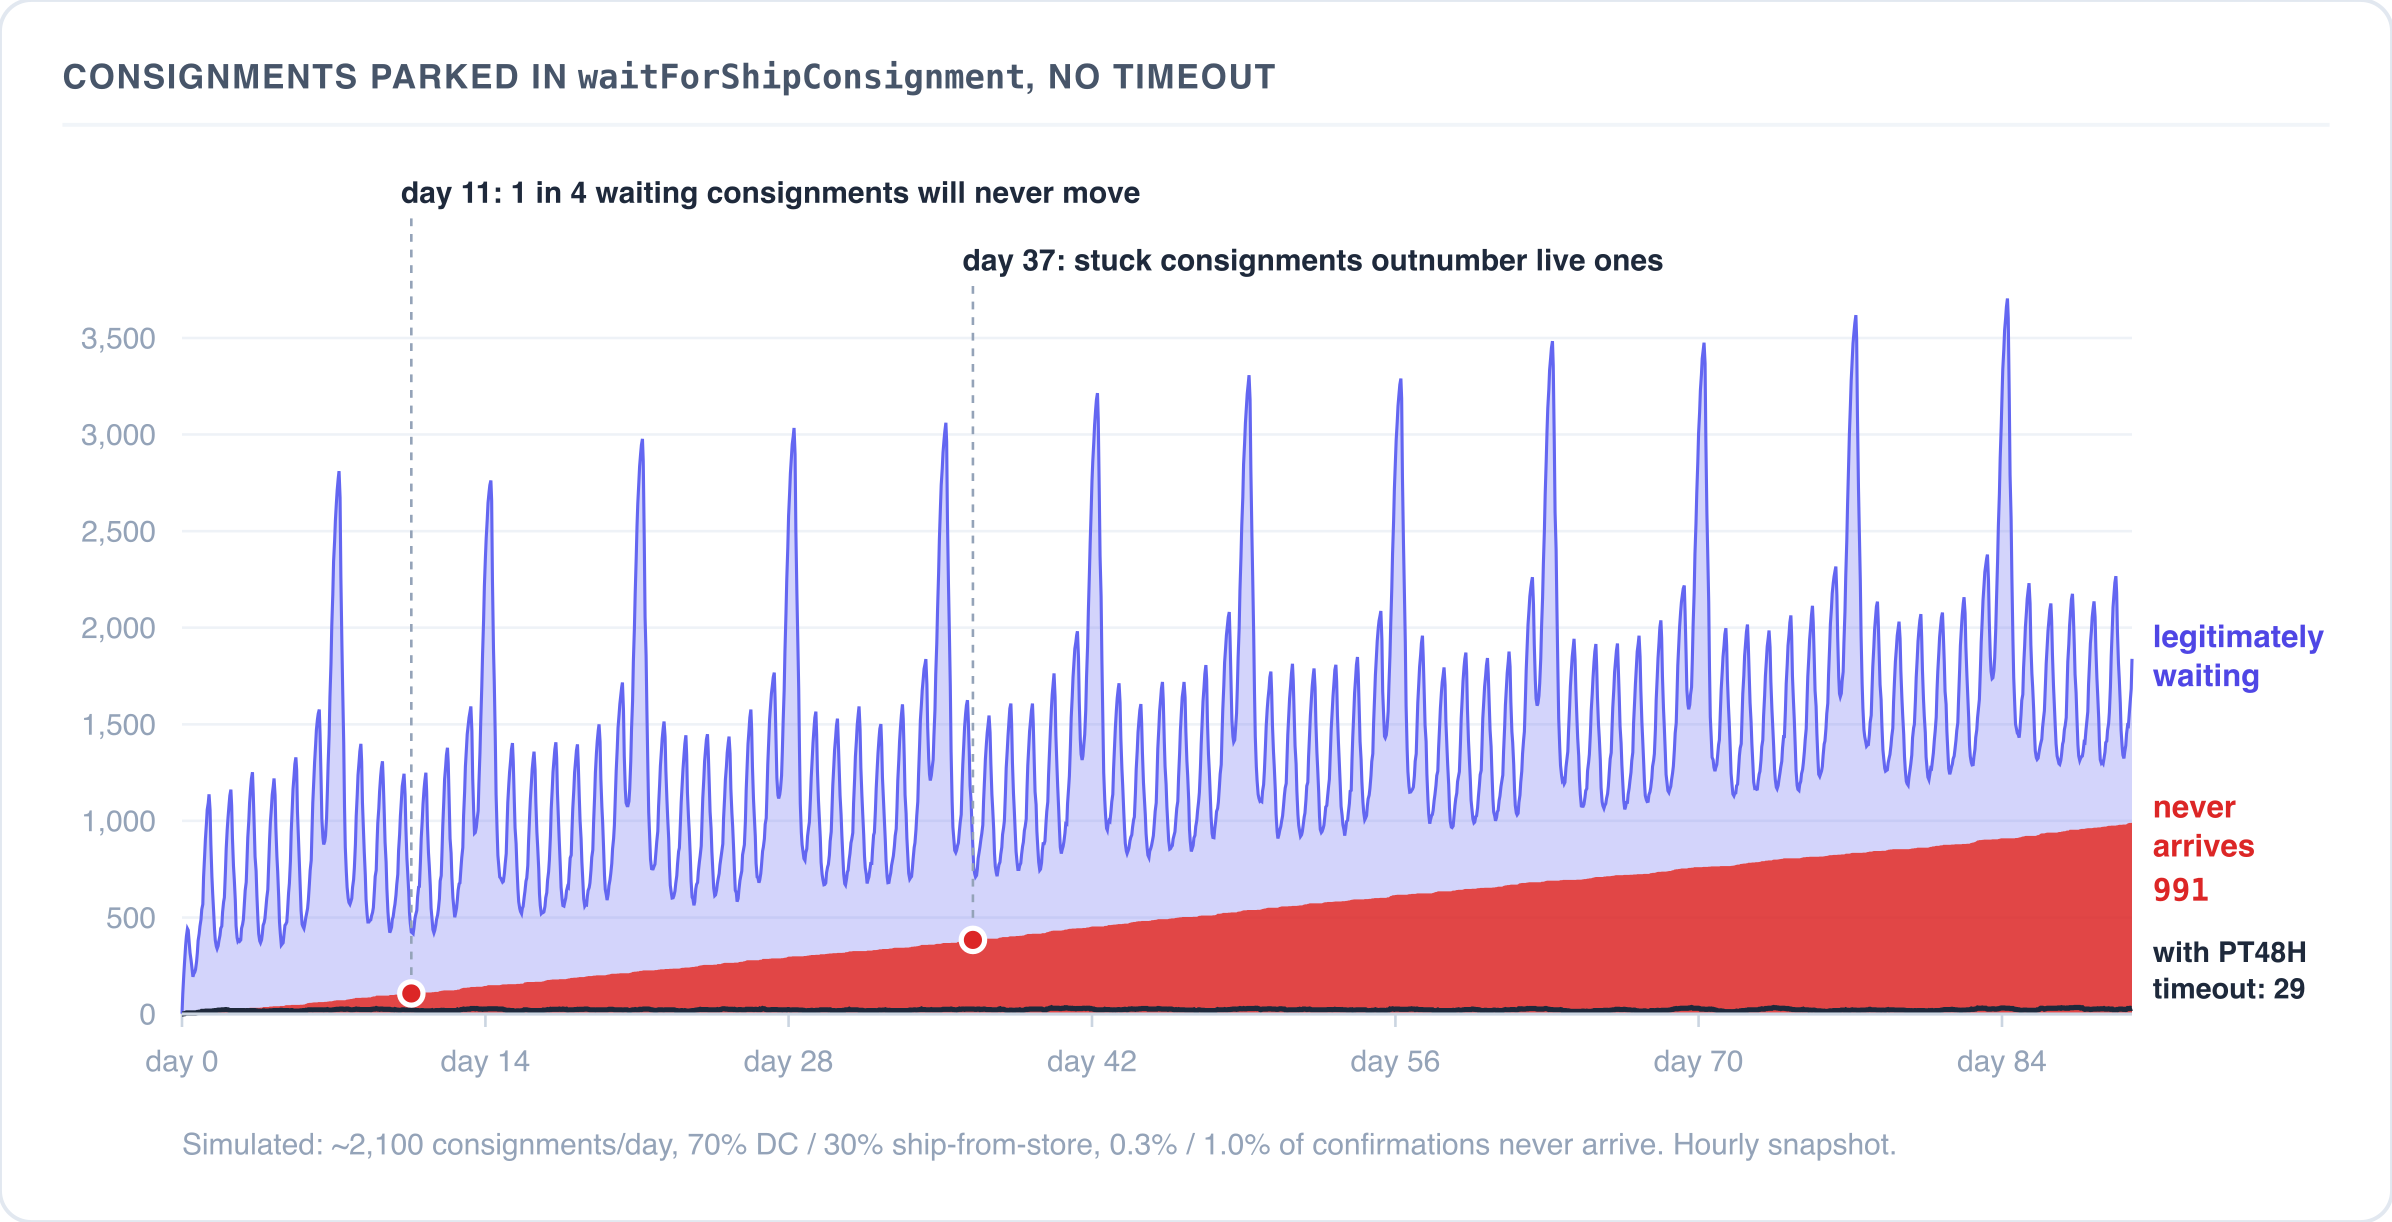
Застрявшие прибавляются стабильно по одиннадцать в день и никуда не уходят, так что к 90-му дню их 991. Это простая арифметика. Моделирование добавляет к ней другое: насколько хорошо они прячутся. Легитимная часть каждую неделю колеблется примерно в восемь раз, с пиком в ночь на понедельник, когда магазины закрыты. На таком фоне бэклог, растущий на одиннадцать в день, не виден как тренд ни на одном графике «заказов в работе». И всё же к 11-му дню четверть ожидающих отправлений не сдвинется уже никогда, а к 37-му дню застрявших больше, чем живых. Никакая ошибка не пишется в лог, и ни одна задача не падает. Движок процессов делает ровно то, что написано в определении.
Тёмная линия внизу — та же модель с таймаутом в 48 часов, который отклоняет отправление и заново подбирает для него источник. Число застрявших в любой момент остаётся ниже 35, потому что каждое потерянное отправление уходит через два дня и его место занимает следующее.
Атрибут timeout и почему он оставлен на усмотрение проекта
Схема определения процесса поддерживает дедлайны. Из
platform/ext/processing/resources/processengine/processdefinition.xsd:
<complexType name="timeout">
  <annotation>
    <documentation>
      Allow to configure timeout for the wait node
    </documentation>
  </annotation>
  <attribute name="delay" type="duration" use="required">
    <annotation>
      <documentation>
        Delay after which wait will be timed out
      </documentation>
    </annotation>
  </attribute>
  <attribute name="then" type="tns:name" use="required">
    <annotation>
      <documentation>Transition on timeout</documentation>
    </annotation>
  </attribute>
</complexType>
delay — это XSD duration, то есть PT4H или P2D. then — узел, на который нужно перейти,
когда время истечёт. Реализация узла ожидания объявляет SupportsTimeout, а ветка, которую
мы видели выше, выставляет задаче expirationTimeMillis, если таймаут настроен. Затем
обработка истечения срока в движке задач снова обращается к узлу, и тот направляет процесс
в цель таймаута. Механизм полный и существует уже много лет.
В эталонных определениях процессов, которые поставляются с Order Management, ни один из десяти узлов ожидания из коробки не настраивает таймаут.
Это легко проверить на свежей установке: grep -c timeout по ImpEx-файлам с определениями
процессов возвращает ноль. Из коробки нет ни заранее настроенного SLA на проверку на фрод,
ни дедлайна для несобранного отправления. Пока проект их не добавит, внешняя система
фулфилмента, которая приняла отправление и так и не подтвердила его, оставляет узел 4
взведённым бессрочно, а неудавшееся списание при возврате денег паркует возврат в узле 9,
пока не вмешается оператор.
Как поведение платформы по умолчанию это совершенно логично. SAP не может знать, какой у вас
SLA на проверку на фрод — тридцать минут или четыре дня, а эталонный таймаут, срабатывающий
в произвольный момент, был бы хуже, чем отсутствие таймаута, потому что двигал бы заказы так,
что бизнес не понимал бы почему. Поставляемые определения в yacceleratorordermanagement —
это стартовый шаблон, а дедлайны — ответственность проекта. И всё же, поскольку таймауты живут
в схеме нижележащего движка процессов, а не на виду в руководствах по Order Management, команды
часто выкатывают эталонные определения в прод как есть и задумываются о дедлайнах только тогда,
когда интеграция со складом впервые молча перестаёт присылать подтверждения.
Как выглядит разумный набор дедлайнов, целиком зависит от бизнеса, но общая форма предсказуема:
| Узел ожидания | Правдоподобный дедлайн | Разумный пункт назначения |
|---|---|---|
| проверка на фрод | часы | эскалация в очередь второй линии или автоотмена |
| подтверждение от внешнего фулфилмента | минуты | повторная отправка, затем отклонение и повторный подбор источника |
| несобранное отправление | время отсечки магазина | отклонить отправление, чтобы источник подобрали заново в другом месте |
| товар по возврату не получен | окно возврата плюс запас | отменить возврат |
| неудавшееся списание при возврате денег | часы | уведомить финансовый отдел |
Столбец с пунктом назначения важнее столбца с задержкой. Таймаут, который ведёт в узел end,
— это способ тихо терять заказы. Таймаут, который ведёт в действие, создающее видимую запись
об исключении или запускающее существующий путь «отклонить и подобрать заново», превращает
тихую остановку в задачу, у которой есть владелец.
Со столбцом задержки сложнее, чем кажется, и причина в XSD. delay — это XSD duration,
которая измеряет время по часам. Бизнес-дедлайн вроде «времени отсечки магазина»
измеряется по календарю, а в процессе отправления один и тот же узел ожидания обслуживает
все склады, какой бы календарь у них ни был. Если прогнать ту же модель с фиксированной
задержкой на waitForShipConsignment, видно, что это значит:
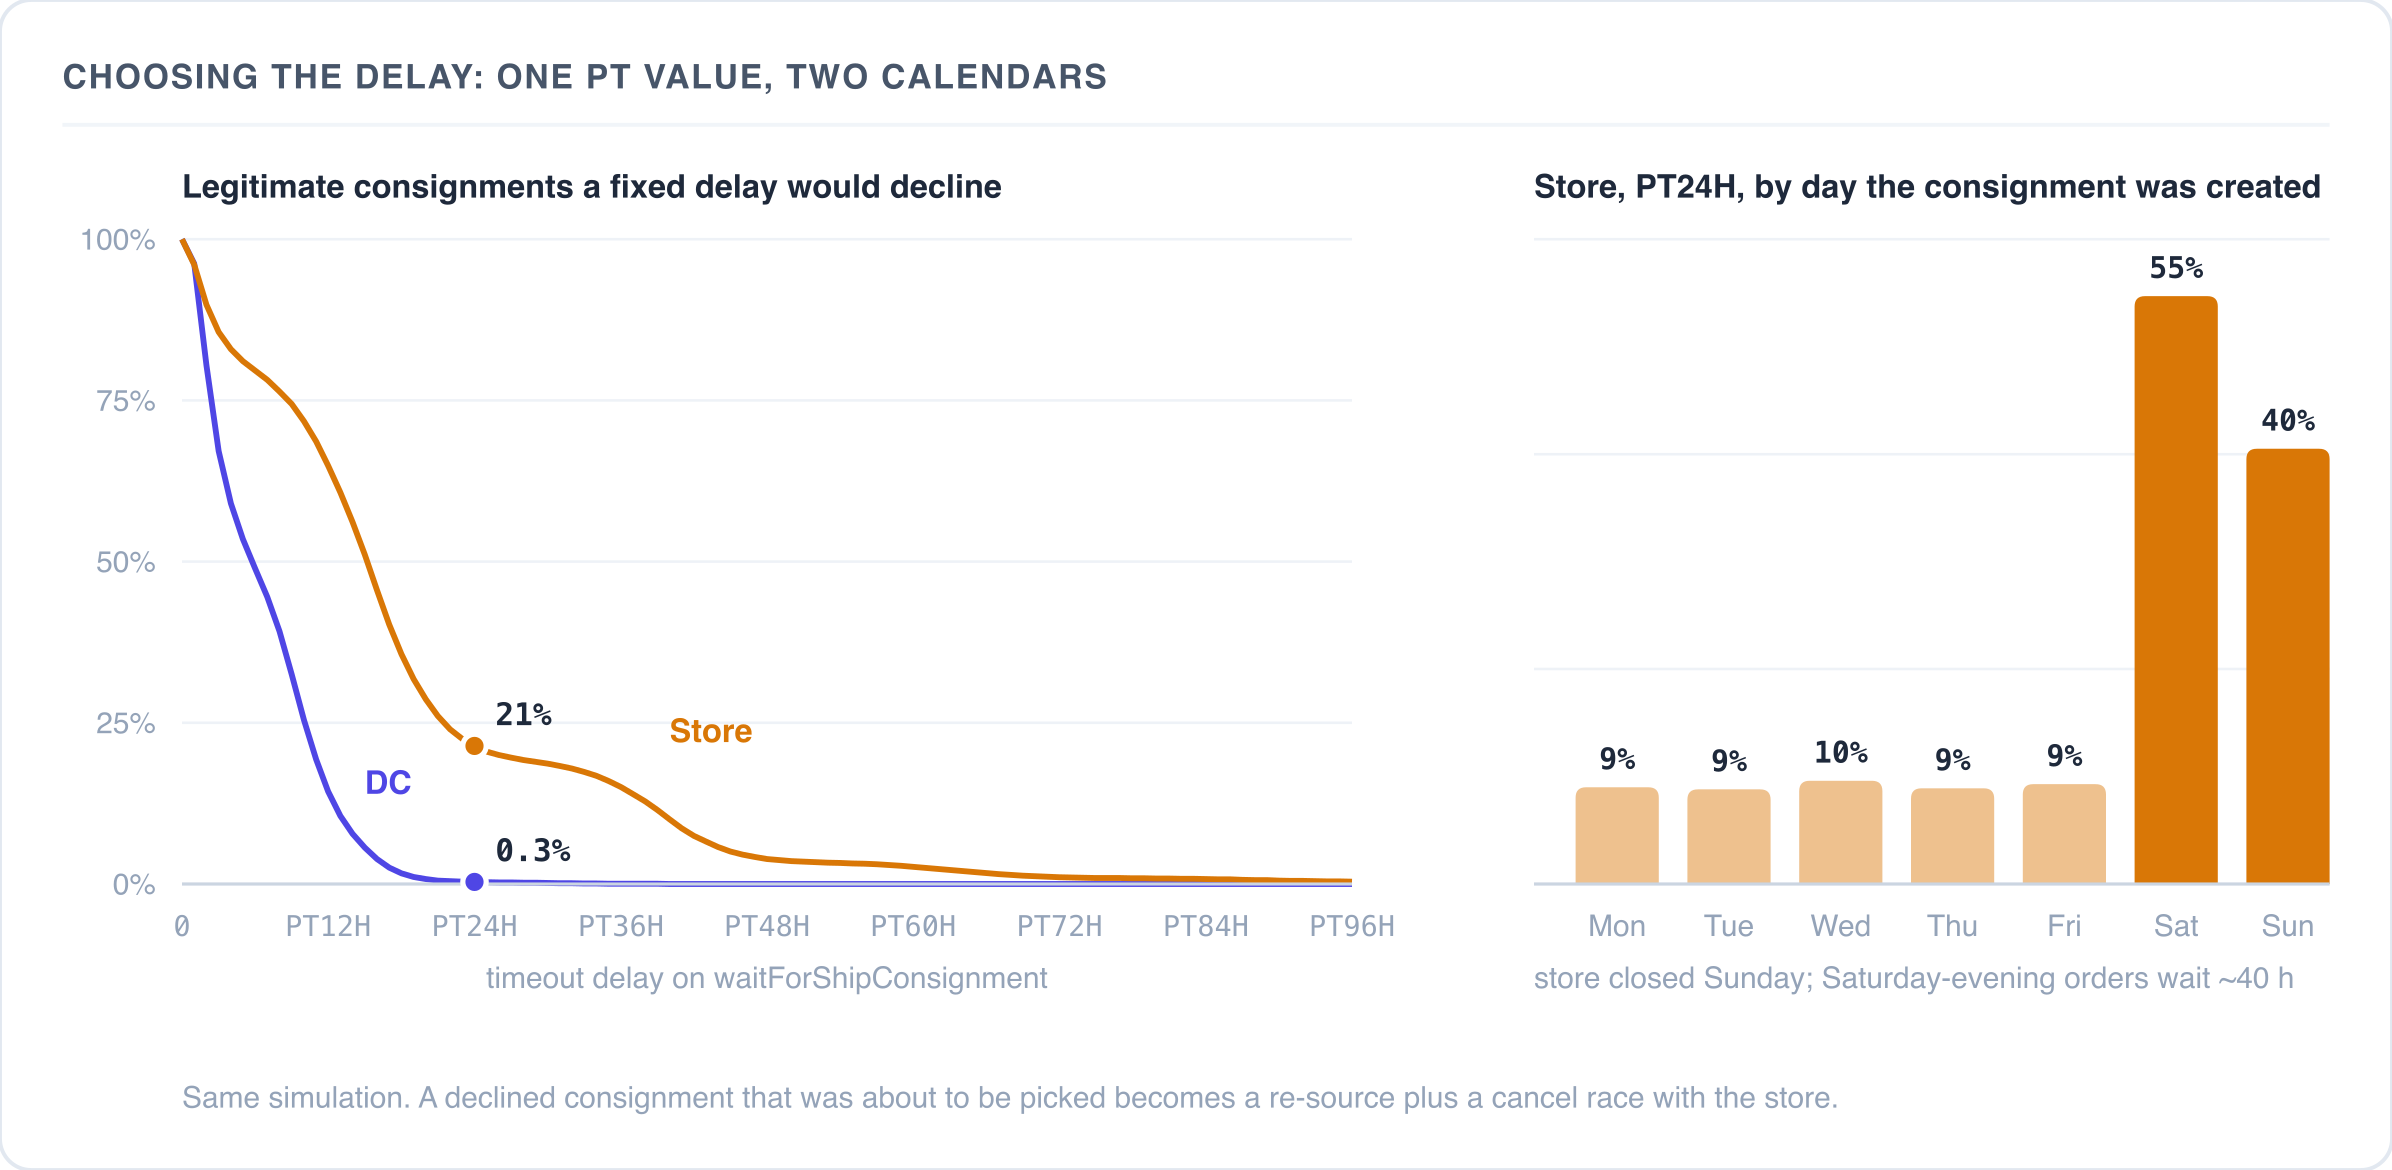
PT24H звучит щедро, и для РЦ так и есть: таймаут истёк бы только у 0,3% здоровых
отправлений. Для магазинов то же значение отклоняет 21% отправлений, которые были бы собраны.
Среднее скрывает картину. С понедельника по пятницу отклоняется около 9%, в основном вечерние
заказы, которые ждут следующего открытия. В субботу — 55%, потому что заказ, сделанный
в субботу после закрытия магазина, ждёт утра понедельника около 40 часов. Каждое такое ложное
отклонение заново подбирает источник для заказа, который шёл по плану, и запускает гонку
с продавцом, который, возможно, собирает его прямо сейчас. Чтобы ложных отклонений в магазинах
было меньше 1%, задержку приходится поднять примерно до PT72H. А это три дня тишины,
прежде чем кто-то узнает об отправлении из РЦ, потерянном в первый же час.
Практичный выход — считать таймаут не дедлайном, а интервалом проверки. Поставьте короткую задержку и направьте таймаут в действие, которое измеряет возраст отправления в рабочих часах его склада. Это действие возвращает процесс в узел ожидания, если бизнес-дедлайн ещё не прошёл, и отклоняет отправление, если прошёл. Тогда календарная логика живёт в Java, где ей и место, а XSD duration задаёт только то, как часто выполняется проверка.
Как разрешаются then и choice
У каждого узла ожидания есть обязательный атрибут then, и при чтении определений его
естественно воспринимать как следующий узел по умолчанию. На деле правило строже, и разница
проявляется в интеграционном коде.
События можно отправлять с choice — именованной веткой. Процесс заказа пользуется этим активно:
<wait id='waitForOrderAction' prependProcessCode='true' then='failed'>
  <case event='OrderActionEvent'>
    <choice id='consignmentProcessEnded' then='verifyOrderCompletion'/>
    <choice id='cancelOrder' then='processOrderCancellation'/>
    <choice id='cancelled' then='success'/>
    <choice id='reSource' then='sourceOrder'/>
    <choice id='putOnHold' then='putOrderOnHold'/>
  </case>
</wait>
Логика разрешения, реконструкция:
// иллюстрация
String nextNode(NodeExecutionContext ctx) {
    if (!ctx.hasAnyChoice()) {
        return then; // choice не передан -> атрибут 'then'
    }
    Set<String> choices = ctx.getChoices();
    if (choices.size() > 1) {
        throw new IllegalStateException(
            "multiple choices are not supported");
    }
    String next = this.choices.get(choices.iterator().next());
    if (next == null) {
        throw new IllegalStateException(
            "choice was not declared in the process definition");
    }
    return next;
}
Несколько следствий для всех, кто отправляет эти события из кода.
Если отправить OrderActionEvent по заказу без choice, процесс заказа сразу уходит
в конечный узел failed, который выставляет процессу состояние FAILED и останавливает его.
Интеграция, которая подталкивает заказы, отправляя событие и не указывая choice, завершает
процесс. Строка заказа остаётся, отправления остаются, оркестрация — нет.
Если отправить его с choice, которого нет в определении, внутри task runner возникает
IllegalStateException. Задача падает, процесс не продвигается, а узел ожидания заново
не взводится. Теперь заказ застрял так, что это выглядит точно так же, как «событие так
и не пришло»; отличить одно от другого можно только по стектрейсу в логе.
Если отправить его сразу с двумя choice, возникает то же исключение. На это легко нарваться, если строить универсальный интеграционный эндпоинт «применить вот эти изменения состояния».
Узлы ожидания отправлений справляются с этим изящнее, и их приём стоит перенять:
<wait id='waitForShipConsignment' prependProcessCode='true'
      then='waitForShipConsignment'>
then указывает на сам узел. ConsignmentActionEvent без choice заново взводит ожидание,
а не роняет процесс. Отправление остаётся там, где было, и для идемпотентного подталкивания
это ровно то, что нужно. Намеренна ли эта асимметрия между процессом заказа и процессом
отправления, сказать не могу, но если вы всё равно правите определение заказа, направить его
then в специальное действие «неожиданное событие», а не в failed, ничего не стоит
и убирает острый угол.
Как найти застрявшие заказы
Раз ожидающий процесс — это строка, его можно найти запросом. Нужные таблицы — Tasks
(ProcessTask наследует Task и делит с ним таблицу), TaskConditions и Processes.
Оговорка, незнание которой обойдётся вам в час отладки: Task.expirationDate
и TaskCondition.expirationDate — динамические атрибуты, вычисляемые в Java, и в базе
данных их нет. Хранимая колонка — expirationTimeMillis. Очевидный FlexibleSearch по
expirationDate сделает не то, что вы хотите.
Рабочая отправная точка на нативном SQL, чтобы вывести ожидающие процессы по возрасту и по узлу, в котором они ждут:
SELECT t.p_action                      AS wait_node,
       COUNT(*)                        AS stuck_count,
       MIN(p.createdTS)                AS oldest
FROM   tasks t
JOIN   processes p ON p.PK = t.p_process
WHERE  t.p_expirationtimemillis IS NULL
AND    p.createdTS < DATEADD(hour, -24, GETDATE())
GROUP  BY t.p_action
ORDER  BY stuck_count DESC;
Функцию работы с датами поправьте под свою базу данных. На выходе получается тот самый
операционный артефакт, о котором я говорил в начале, — заказы, которые не двигались N часов,
сгруппированные по состоянию, в котором они застряли, — и если вы ещё не сделали для этого
отдельное представление в Backoffice или алерт, этот запрос — самый быстрый способ его
получить. Один раз прогнать его на данных, похожих на продовые, обычно поучительно:
waitForShipConsignment, как правило, доминирует, а в длинном хвосте и прячутся баги
интеграций.
Важно и то, когда его запускать. В смоделированном квартале выше 24-часовой запрос, запущенный в четверг в 09:00, возвращает 939 отправлений, которые не сдвинутся уже никогда, и 54 просто медленных. Запущенный в понедельник в 09:00, он возвращает 903 застрявших и 605 здоровых — это магазинные заказы с выходных. При том же пороге, который в середине недели даёт чистую картину, после выходных 40% выдачи — шум. Если запрос питает алерт, запускайте его в середине недели или измеряйте возраст в рабочих часах, как это делает действие по таймауту выше.
Как менять определение под работающими заказами
Чтобы добавить таймаут, нужно отредактировать ImpEx с определением процесса и импортировать его заново. Сама правка ничем не примечательна:
<wait id='waitForManualOrderCheckCSA' then='orderManualChecked'
      prependProcessCode='true'>
    <event>CSAOrderVerified</event>
    <timeout delay='PT4H' then='escalateFraudReview'/>
</wait>
где escalateFraudReview — бин действия, который вы пишете сами. Обратите внимание, что узлу
теперь нужен настоящий пункт назначения: таймаут, указывающий на действие, которое только пишет
в лог, — это способ пометить проблему как решённую, оставив её нерешённой.
Самое интересное начинается с версионирования, потому что ведёт оно себя не так, как подсказывает модель данных.
Работающий BusinessProcess хранит имя определения и версию определения, с которой
он стартовал, и движок разрешает каждый следующий узел по этой паре. Пока это похоже на
обычное версионирование процессов: меняете определение, а уже запущенные экземпляры
продолжают работать по той схеме, с которой стартовали.
На практике такой изоляции нет, потому что вторую версию никто никогда не создаёт.
DynamicProcessDefinition.version — это Long со значением по умолчанию 0, с уникальным
индексом по (code, version, active), а провайдер проверяет, что на один code приходится
не больше одной активной строки. Поставляемый ImpEx объявляет code[unique = true] и вообще
не содержит колонки version, поэтому каждый повторный импорт обновляет на месте одну и ту же
строку — версию 0. Каждый когда-либо запущенный заказ привязан к версии 0, а версия 0 —
это то, что вы импортировали последним.
Переключение определяется кэшем, а не деплоем. ProcessDefinitionsCache — это мапа на уровне
JVM с ключом (name, version); определение, которое уже в ней есть, отдаётся из памяти, а база
данных опрашивается только при промахе. Если сложить эти два факта, получается реальное
поведение при изменении определения процесса:
- уже запущенные процессы действительно подхватывают новое определение, потому что они
разрешаются в версию
0, а версия0поменялась у них под ногами; - подхватывают они его, когда кэш на ноде заполнится в следующий раз, а на практике это значит после перезапуска, так что изменение вступает в силу при деплое, а не при импорте;
- ноды кластера, которые перезапускаются в разное время, выполняют разное содержимое для одной и той же версии процесса, пока идёт раскатка.
Обычно это безвредно, потому что большинство правок добавляют узлы, а не удаляют их. Вред
появляется, когда заказ припаркован в узле ожидания, которого в новом содержимом больше нет:
поиск узла бросает NoSuchNodeException, и заказ застревает с исключением, в котором назван
узел, уже удалённый вами из файла, на который вы смотрите.
Если нужна настоящая изоляция, её придётся построить самому: вставить новую строку с явно указанной,
более высокой version, переключить active и оставить старую строку на месте, чтобы уже
запущенные процессы по-прежнему могли по ней разрешаться. Ни один ImpEx в поставке этого
не демонстрирует, и, пожалуй, поэтому так почти никто не делает.
Что в итоге
Движок процессов под Order Management — это добротная инфраструктура: надёжная, переживающая перезапуски, определяемая данными и вполне способная выражать дедлайны. Эталонные определения Order Management оставляют эти дедлайны ненастроенными, чтобы их задал проект, — а значит, пока вы их не добавите, у десяти точек, где заказ передаёт управление человеку или внешней системе, нет никакой страховочной сетки. Это обязательный пункт чек-листа для каждого внедрения, и его можно целиком закрыть из ImpEx.
Следующая статья цикла: как SAP Commerce выбирает склад. Движок сорсинга оценивает склады-кандидаты взвешенной суммой по матрице — на бумаге стройная модель, но относительная нормализация в ней приводит к неочевидным последствиям для того, как на практике ведут себя наборы кандидатов.
Discussion
Powered by GitHub Discussions — sign in with a GitHub account to join the conversation.