
Це перша з п'яти статей циклу про SAP Commerce Order Management. Цикл написано на основі інсталяції 2211, і він зосереджений на механіці роботи в рантаймі та проєктних рішеннях, що лежать на рівень нижче за оглядові посібники на SAP Help Portal. Там, де щось уже добре описано в офіційній документації, я даю посилання, а не переказую.
Почати я хочу з очікування, бо саме в очікуванні замовлення й помирають.
Про код у цій статті
Фрагменти Java нижче — це ілюстративна реконструкція: переказ, написаний для того, щоб показати, що робить рушій, з навмисно спрощеними назвами та структурою. Вони не відтворюють жодної реалізації, і читати їх варто як схеми. З фрагментами ImpEx та XSD інакше: це конфігураційні файли з поставки, і я цитую їх як є, адже весь сенс визначення процесу в тому, що його можна прочитати й змінити.Замовлення майже весь час простоює
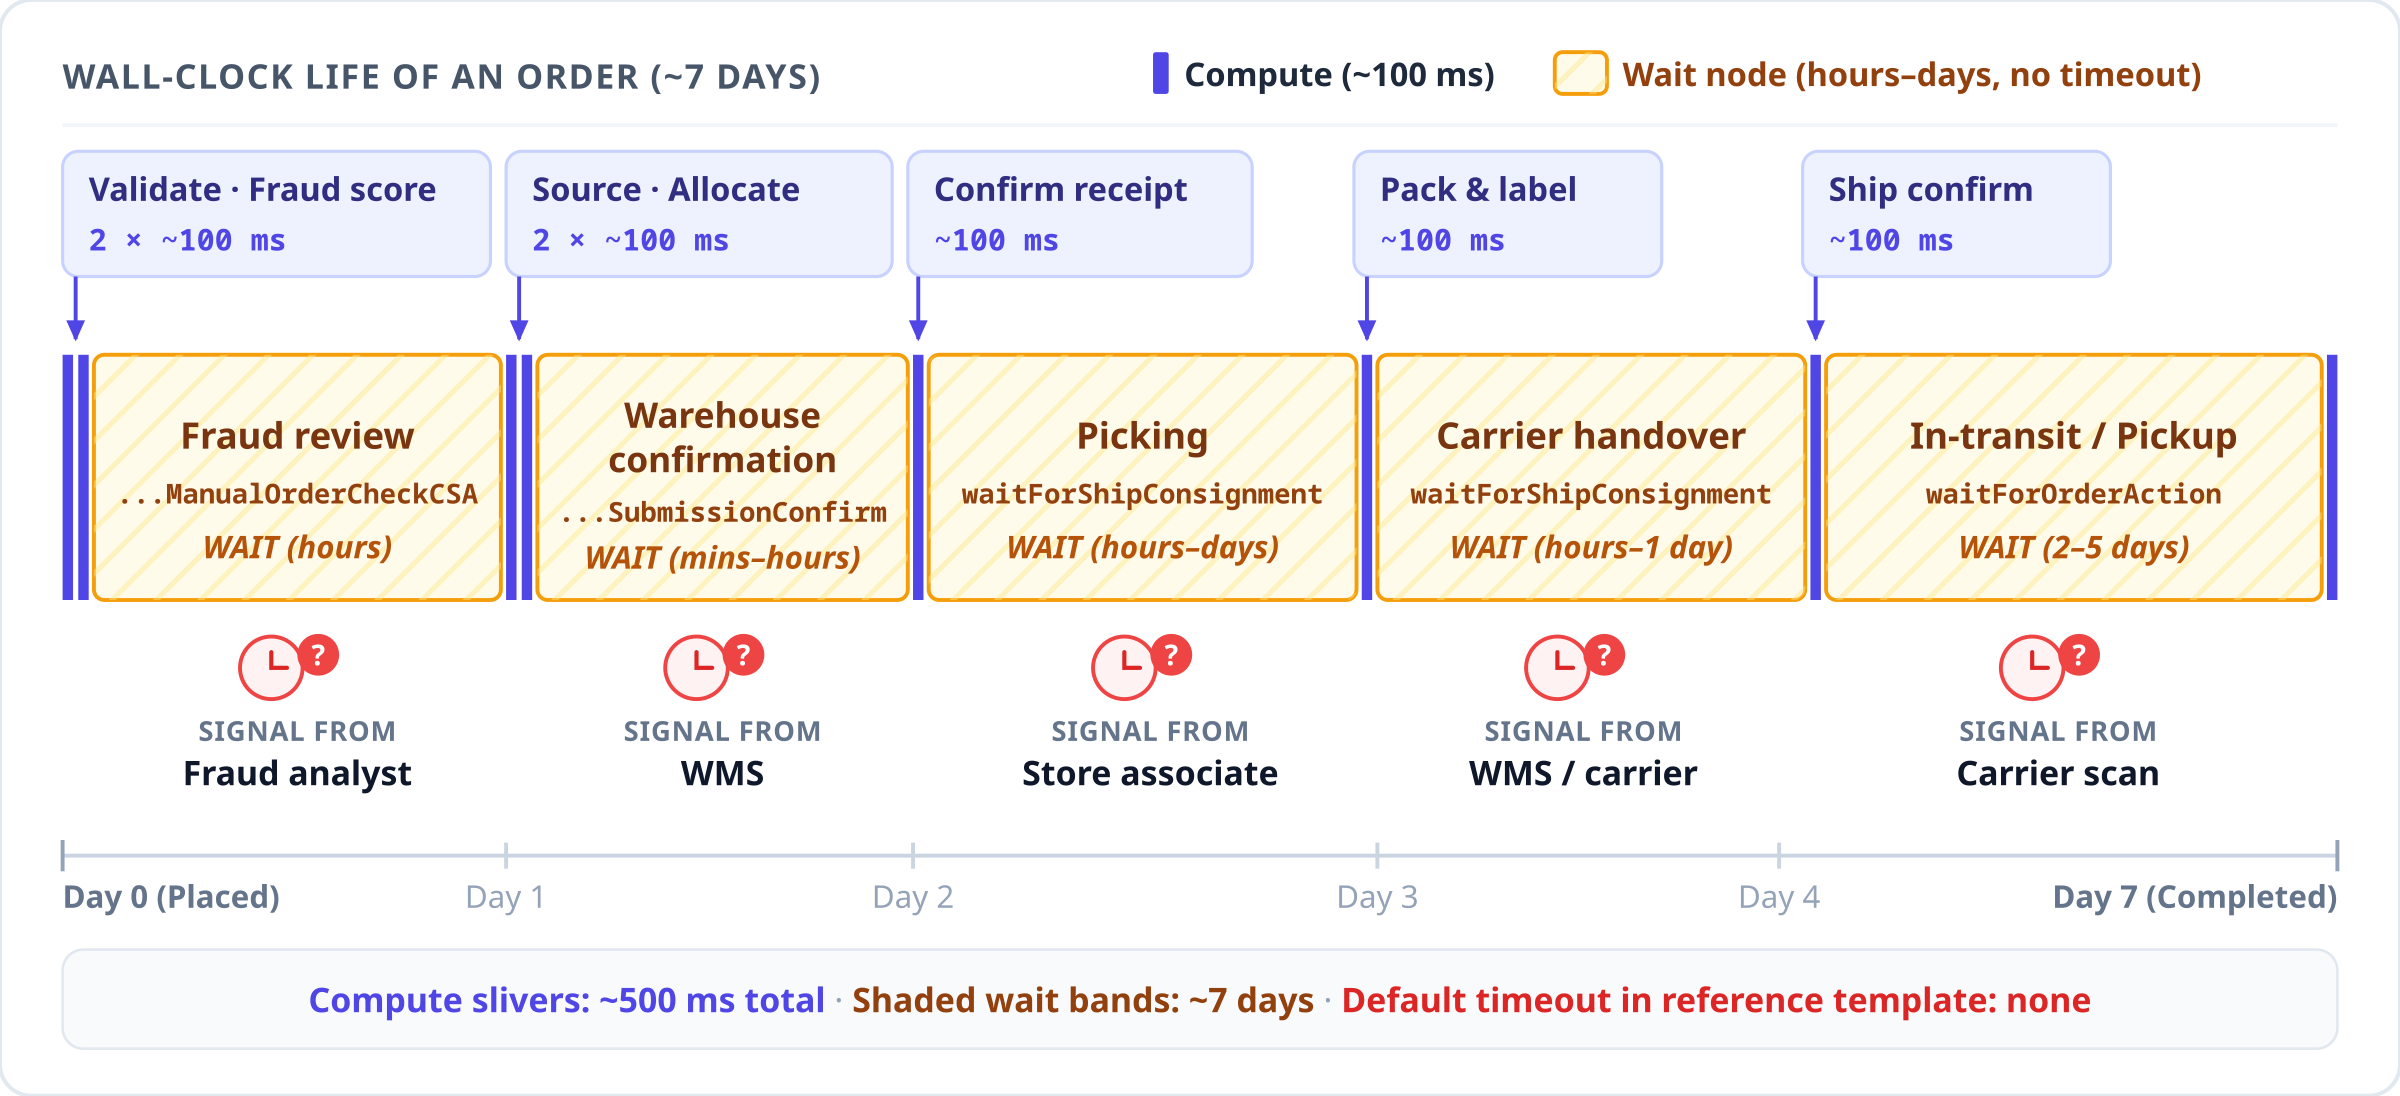
Візьміть будь-яку систему керування замовленнями, у будь-якому продукті, і виміряйте, на що йде реальний час. Розрахунок ціни, перевірка на шахрайство, запит залишків і вибір складу разом забирають кілька сотень мілісекунд. Усе інше — очікування: поки фрод-аналітик подивиться на позначене замовлення, поки склад підтвердить, що отримав лист комплектації, поки комплектувальник справді збере замовлення, поки перевізник забере посилку, поки покупець дійде до магазину, поки повернена посилка доїде до депо, поки платіжний шлюз проведе повернення коштів.
Тож комерційна платформа мусить моделювати довготривалий стан, який просувається за зовнішніми сигналами. Це інженерна задача іншого роду, ніж обробка запитів, і ламається вона інакше. Переважають два сценарії відмови:
Сигнал так і не надходить. Інтеграція зі складом губить повідомлення, продавець іде у відпустку з одинадцятьма завданнями на комплектацію, призначеними йому, зовнішня система фулфілменту відповідає 200 OK, а потім про все забуває. Замовлення стоїть у коректному, узгодженому й назавжди нерухомому стані. Нічого не зламано так, щоб це помітила бодай одна перевірка стану.
Сигнал надходить у формі, якої процес не приймає. Подія спрацьовує, але з payload, якого визначення не знає, або одразу з двома суперечливими вказівками. Тепер процесові доводиться обирати між тим, щоб проігнорувати подію, впасти або вгадати.
Галузева практика тут давно усталилася, і її варто чітко сформулювати, бо вона дає нам точку
відліку. У BPMN є граничні події таймера: до стану прикріплюють годинник, і коли час спливає,
токен залишає стан іншим шляхом. Temporal та подібні рушії durable execution дають
workflow.await(timeout) з явним дедлайном на кожному блокувальному виклику. В архітектурах
на повідомленнях використовують dead-letter-черги та політику повторної доставки. І майже всі,
незалежно від рушія, зрештою доходять до того самого операційного артефакту: дашборду або звіту
зі списком замовлень, які не змінювали стану N годин, згрупованих за станом, у якому вони
застрягли.
Спільне в усьому цьому те, що моделюється сама відсутність події. Вона має тривалість, пункт призначення і власника.
Як SAP Commerce моделює очікування
Order Management працює на рушії процесів платформи, тому самому, на якому побудовано листи з підтвердженням замовлення та B2B-процеси погодження. Тут важать три процеси, і це окремі бізнес-процеси з окремими життєвими циклами:
| Процес | Охоплення | Коли створюється |
|---|---|---|
order-process |
замовлення загалом | під час оформлення замовлення |
consignment-process |
одне відправлення | під час алокації |
return-process |
одна заявка на повернення | під час створення заявки на повернення |
Перше, що варто знати: ці три визначення не скомпільовано в розширення. Вони — дані. Кожне
з них — це ImpEx-файл, який вставляє DynamicProcessDefinition, де атрибут content містить
XML процесу:
INSERT_UPDATE DynamicProcessDefinition;code[unique=true];active;content
;order-process;true;"<?xml version='1.0' encoding='UTF-8'?>
<process xmlns='http://www.hybris.de/xsd/processdefinition'
         start='checkOrder' name='order-process'
         processClass='...OrderProcessModel'>
...
</process>"
Лежать вони в yacceleratorordermanagement/resources/impex/, один файл на процес. Отже, форма
життєвого циклу замовлення у вашому проєкті — це рядок у таблиці бази даних, а не зміна коду,
і для решти статті це важливо: кожен пункт чек-листа нижче закривається редагуванням цього
рядка.
Вузол типу <wait> призупиняє процес, доки не спрацює іменована подія. Реалізація невелика,
і в ній варто розібратися, бо вона пояснює і сценарії відмови, і спосіб їх виправити. Коли
процес доходить до вузла очікування, рушій створює задачу з прикріпленою до неї умовою
і повертає керування. Реконструкція:
// ілюстрація
void trigger(BusinessProcessModel process) {
    ProcessTaskModel task = new ProcessTaskModel();
    task.setRunnerBean("taskRunner");
    task.setAction(nodeId);
    task.setProcess(process);

    TaskConditionModel condition =
        modelService.create(TaskConditionModel.class);
    String code = evaluateEventName(eventExpression, process);
    if (prependProcessCode) {
        code = process.getCode() + "_" + code;
    }
    condition.setUniqueID(code);
    task.setConditions(Set.of(condition));

    // <- гілка, про яку ця стаття
    if (timeout.isConfigured()) {
        task.setExpirationTimeMillis(timeout.getExpirationTime());
    }
    taskManager.scheduleTask(task);
}
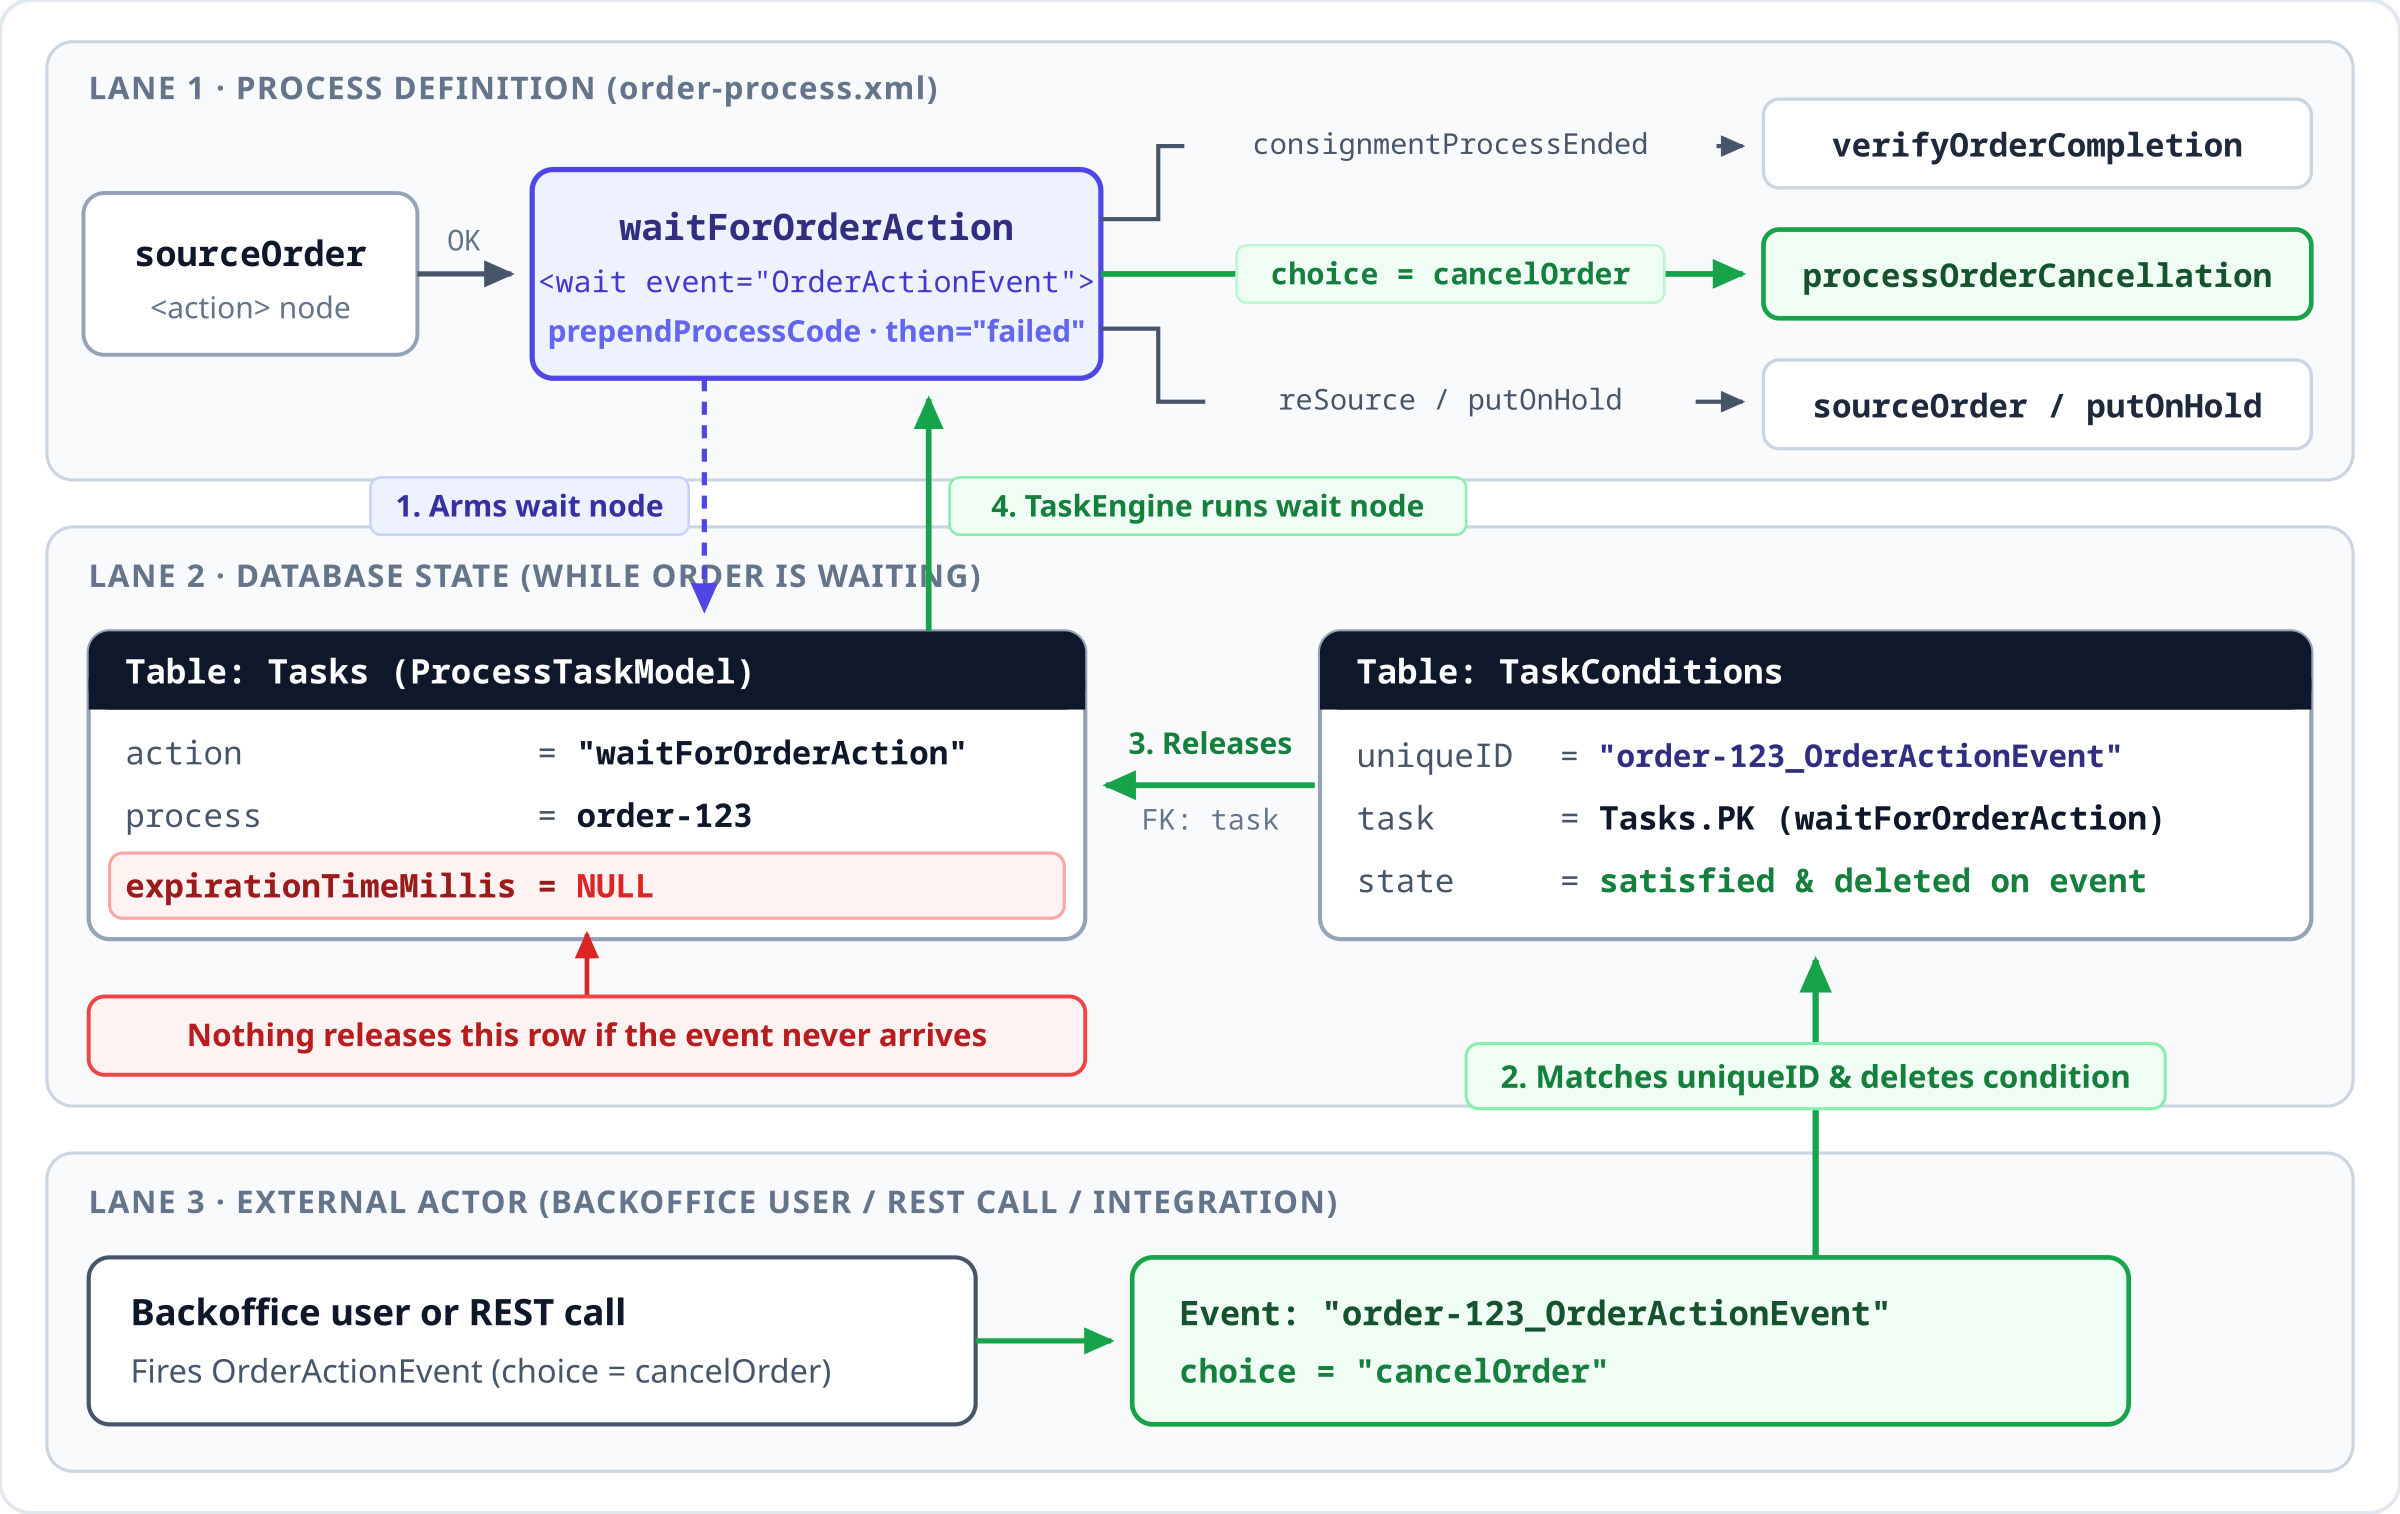
Тобто замовлення, що очікує, — це рядок у Tasks, пов'язаний з рядком у TaskConditions,
у якого uniqueID дорівнює назві події, на яку чекає процес. Подія, що спрацювала, виконує
цю умову; далі рушій задач підхоплює задачу, і процес іде далі. Ніщо нічого не опитує, ніщо
не тримає потік, і перезапуск ноди нічого не змінює, бо весь стан лежить у базі даних.
З погляду надійності це дуже добра схема.
Назва події проходить через Groovy
Одна деталь цієї реконструкції заслуговує на увагу, бо її легко пропустити і вона часто дивує тих, хто вперше помічає її в профайлері.
Назву події у вузлі очікування не використовують буквально. Її обгортають у лапки й обчислюють як вираз Groovy, де в області видимості є процес та його контекстні параметри. Саме тому у визначенні процесу відправлення можна написати так:
<wait id='waitForPreFulfillmentProcessToFinish'
      then='processConsignmentPreFulfillment'
      prependProcessCode='false'>
  <event>${process.code}_ProcessConsignmentPreFulfillmentEvent</event>
</wait>
${process.code} — це плейсхолдер GString, який розв'язується в момент, коли вузол очікування
зводиться. Так очікування пов'язують з одним конкретним вихідним викликом, а не з процесом
загалом: у назву події можна підставити все, що доступне з процесу або його контекстних
параметрів, тож кастомна інтеграція може звести очікування, яке виконає лише її власний колбек.
Зворотний бік у тому, що кожен вхід у вузол очікування запускає скриптовий рушій, навіть для
константного рядка на кшталт CSAOrderVerified. На високонавантаженій інсталяції так набирається
відчутний обсяг роботи Groovy, і на це варто поглянути, якщо рушій задач навантажений більше,
ніж можна очікувати з огляду на обсяги.
Десять місць, де замовлення чекає
Ось повний перелік, вичитаний із трьох визначень процесів, що постачаються. Я наводжу його повністю, бо сам перелік і є аргументом.
| # | Процес | Вузол очікування / подія | На що чекає |
|---|---|---|---|
| 1 | order | waitForManualOrderCheckCSACSAOrderVerified |
поки людина зніме із замовлення позначку про шахрайство |
| 2 | order | waitForOrderActionOrderActionEvent |
на будь-яку дію на рівні замовлення протягом усього його життя |
| 3 | consignment | waitForPreFulfillmentProcessToFinish${process.code}_ProcessConsignmentPreFulfillmentEvent |
на звіт від кастомного кроку перед фулфілментом |
| 4 | consignment | waitForConsignmentSubmissionConfirmation${process.code}_ConsignmentSubmissionConfirmationEvent |
на підтвердження отримання від зовнішньої системи фулфілменту |
| 5 | consignment | waitForShipConsignmentConsignmentActionEvent |
на комплектацію, пакування, відвантаження, скасування чи переалокацію |
| 6 | consignment | waitForPickupConsignmentConsignmentActionEvent |
на те саме для відправлення із самовивозом |
| 7 | return | waitForConfirmOrCancelReturnActionConfirmOrCancelRefundEvent |
поки оператор схвалить або відхилить повернення |
| 8 | return | waitForGoodsActionApproveOrCancelGoodsEvent |
поки товар фізично прибуде й буде прийнятий |
| 9 | return | waitForFailCaptureActionFailCaptureActionEvent |
поки людина вирішить, що робити з невдалим поверненням коштів |
| 10 | return | waitForFailTaxReverseActionFailTaxReverseEvent |
поки людина вирішить, що робити з невдалим сторнуванням податку |
Кожне з них — цілком виправдане місце для очікування. Замовлення, що проходить перевірку на шахрайство, справді
має стояти там, доки хтось на нього не подивиться. Відправлення справді має стояти
в waitForShipConsignment, доки склад щось не зробить.
Питання в тому, що буде, якщо ніхто так нічого й не зробить.
Який вигляд має «ніколи» за квартал
Щоб перевести це в цифри, я змоделював невеликий бізнес: близько 2100 відправлень на день,
70% з них ідуть з розподільного центру, що працює у дві зміни шість днів на тиждень, 30%
відвантажуються з магазинів, відчинених з 10:00 до 20:00 і зачинених у неділю. Час комплектації
береться з реалістичних розподілів за робочими годинами, і невелика частка відправлень так
і не отримує свого ConsignmentActionEvent: 0,3% для РЦ (загублене повідомлення), 1,0% для
магазинів (продавець, який так і не відкрив завдання). Разом це приблизно одне відправлення
з двохсот. Графік показує, скільки відправлень стоїть у waitForShipConsignment щогодини
протягом 90 днів.
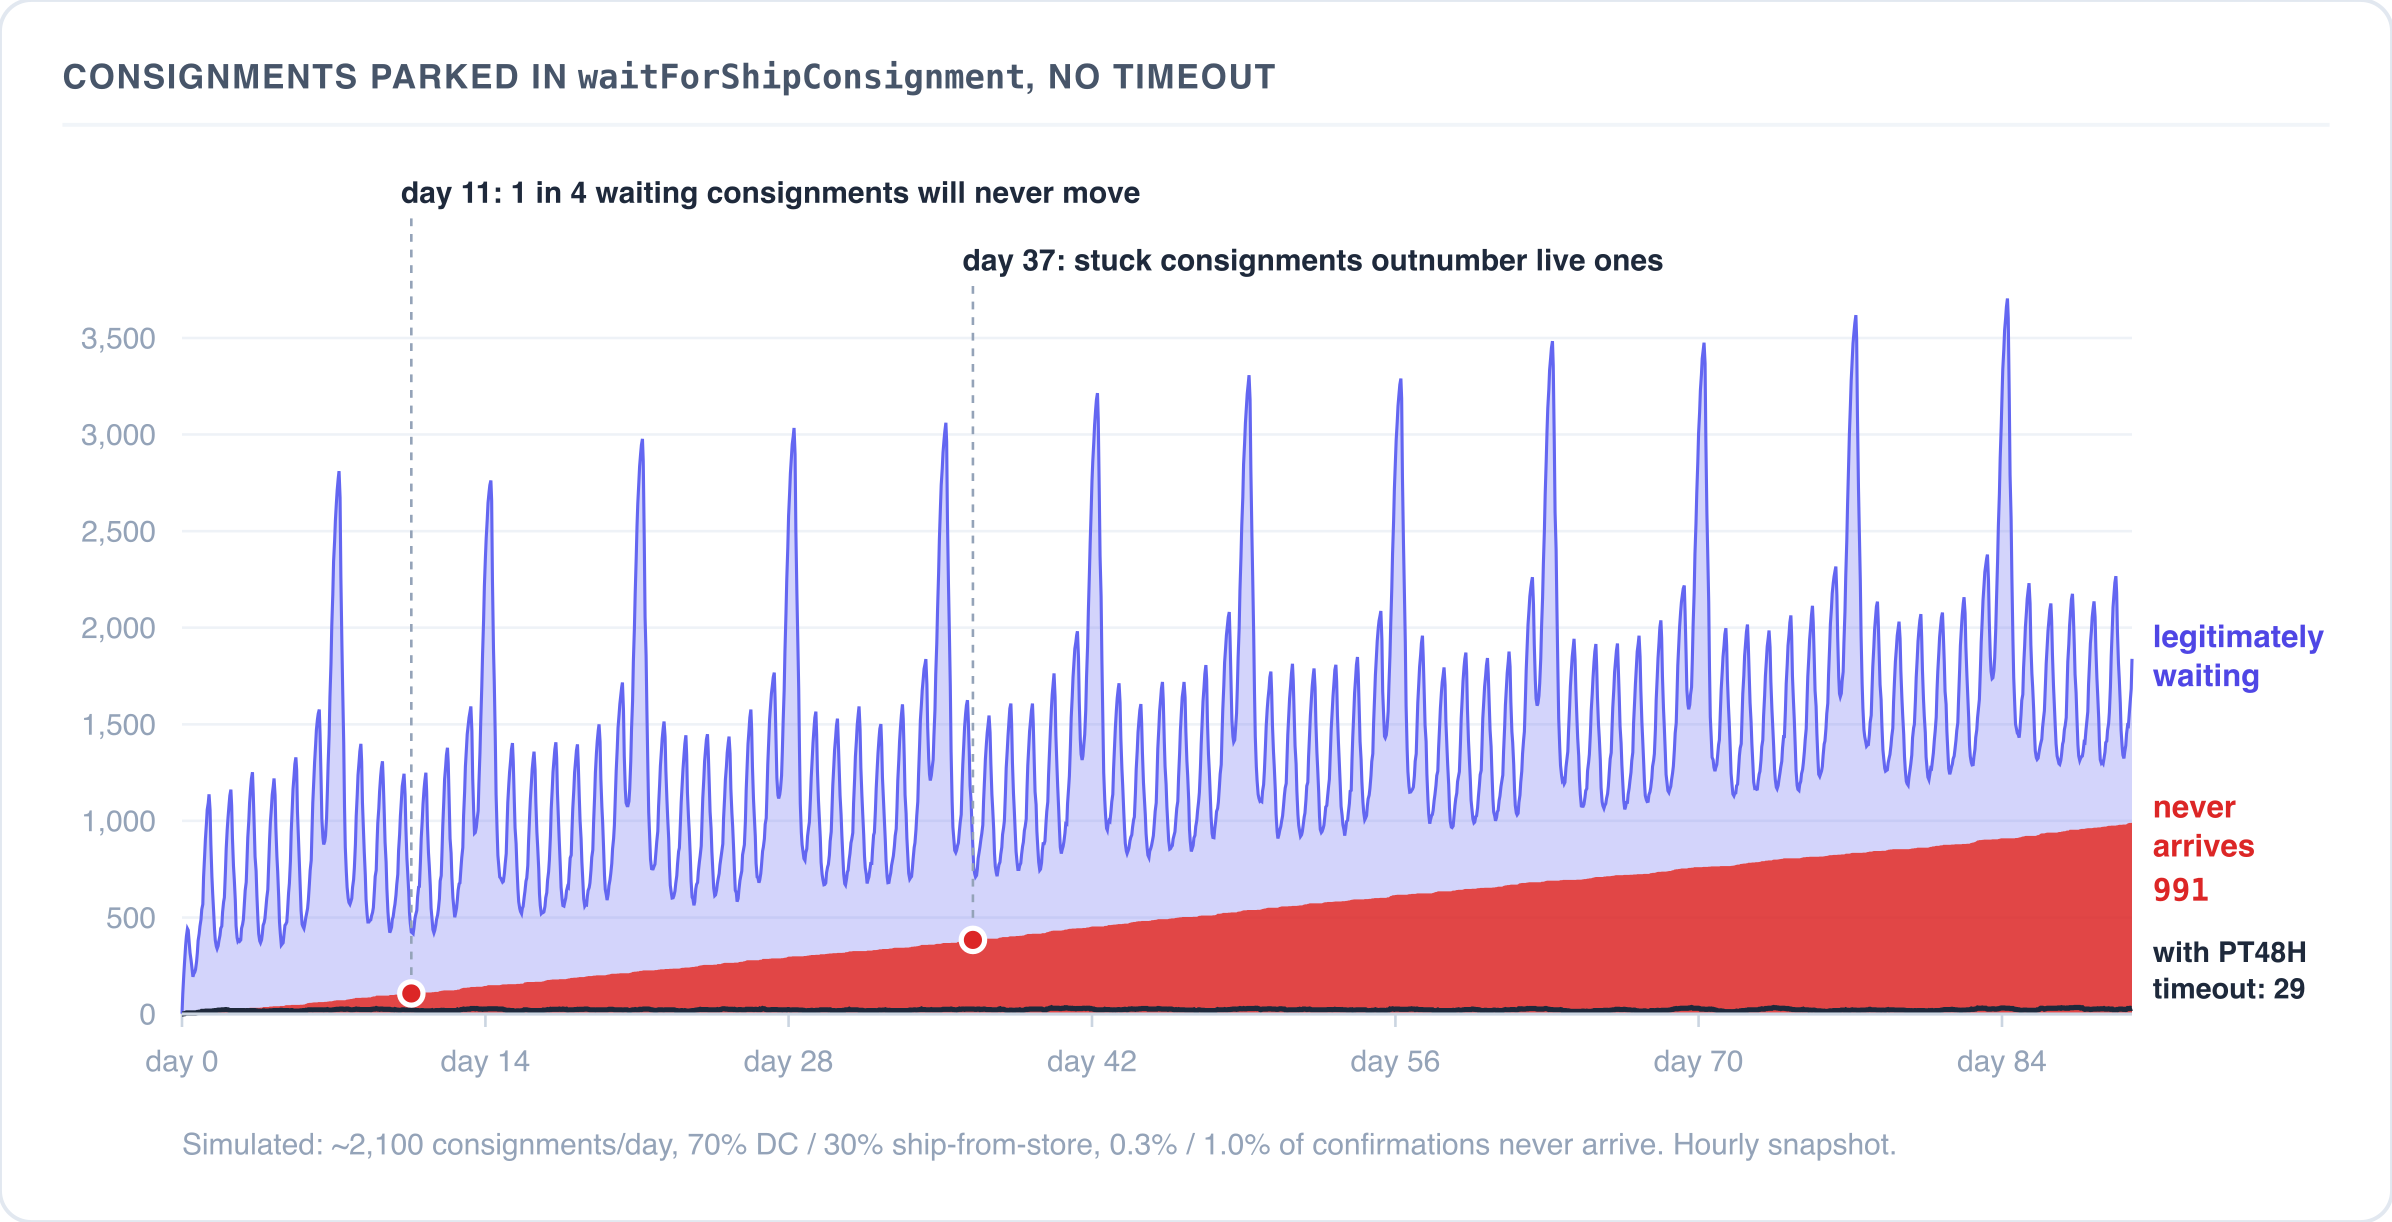
Щодня стабільно додається одинадцять застряглих, і вони нікуди не дінуться, тож на 90-й день їх 991. Це проста арифметика. Моделювання додає до неї інше: наскільки добре вони ховаються. Легітимна частина щотижня коливається приблизно у вісім разів, з піком у ніч на понеділок, коли магазини зачинені. На такому тлі беклог, що зростає на одинадцять на день, не видно як тренд на жодному графіку «замовлень у роботі». І все ж на 11-й день чверть відправлень, що очікують, уже ніколи не зрушить з місця, а на 37-й день застряглих більше, ніж живих. Жодна помилка не потрапляє в лог, і жодна задача не падає. Рушій процесів робить рівно те, що написано у визначенні.
Темна лінія внизу — та сама модель з таймаутом 48 годин, який відхиляє відправлення і наново добирає для нього джерело. Кількість застряглих у будь-який момент лишається нижчою за 35, бо кожне загублене відправлення вибуває через два дні, а його місце займає наступне.
Атрибут timeout і чому його залишено проєктові
Схема визначення процесу підтримує дедлайни. З
platform/ext/processing/resources/processengine/processdefinition.xsd:
<complexType name="timeout">
  <annotation>
    <documentation>
      Allow to configure timeout for the wait node
    </documentation>
  </annotation>
  <attribute name="delay" type="duration" use="required">
    <annotation>
      <documentation>
        Delay after which wait will be timed out
      </documentation>
    </annotation>
  </attribute>
  <attribute name="then" type="tns:name" use="required">
    <annotation>
      <documentation>Transition on timeout</documentation>
    </annotation>
  </attribute>
</complexType>
delay — це XSD duration, тобто PT4H або P2D. then — вузол, на який слід перейти, коли
час сплив. Реалізація вузла очікування оголошує SupportsTimeout, а гілка, яку ми бачили
вище, виставляє задачі expirationTimeMillis, якщо таймаут налаштовано. Далі обробка
спливання строку в рушії задач знову звертається до вузла, і той спрямовує процес до цілі таймауту.
Механізм повноцінний і працює вже багато років.
В еталонних визначеннях процесів, що постачаються з Order Management, жоден із десяти вузлів очікування з коробки не налаштовує таймаут.
Це легко перевірити на свіжій інсталяції: grep -c timeout в ImpEx-файлах із визначеннями
процесів повертає нуль. З коробки немає ні заздалегідь налаштованого SLA для перевірки на
шахрайство, ні дедлайну для нескомплектованого відправлення. Доки проєкт їх не додасть, зовнішня
система фулфілменту, яка прийняла відправлення, але так і не підтвердила його, залишає вузол 4
зведеним безстроково, а невдале списання під час повернення коштів паркує повернення у вузлі 9,
доки не втрутиться оператор.
Як типова поведінка платформи це цілком логічно. SAP не може знати, який у вас SLA на перевірку
на шахрайство — тридцять хвилин чи чотири дні, а еталонний таймаут, що спрацьовує в довільний
момент, був би гіршим за відсутність таймауту, бо рухав би замовлення так, що бізнес не розумів
би чому. Визначення, що постачаються в yacceleratorordermanagement, — це стартовий шаблон,
а дедлайни — відповідальність проєкту. І все ж, оскільки таймаути живуть у схемі рушія процесів,
що лежить нижче, а не на видноті в посібниках з Order Management, команди часто викочують
еталонні визначення у прод як є і замислюються над дедлайнами лише тоді, коли інтеграція зі
складом уперше мовчки перестає надсилати підтвердження.
Який вигляд має розумний набір дедлайнів, цілком залежить від бізнесу, але загальна форма передбачувана:
| Вузол очікування | Правдоподібний дедлайн | Розумний пункт призначення |
|---|---|---|
| перевірка на шахрайство | години | ескалація в чергу другої лінії або автоскасування |
| підтвердження від зовнішнього фулфілменту | хвилини | повторне надсилання, потім відхилення й повторний добір джерела |
| нескомплектоване відправлення | крайній час приймання замовлень магазином | відхилити відправлення, щоб для нього добрали інше джерело |
| повернений товар не надійшов | вікно повернення плюс запас | скасувати повернення |
| невдале списання під час повернення коштів | години | повідомити фінансовий відділ |
Стовпець із пунктом призначення важливіший за стовпець із затримкою. Таймаут, який веде
у вузол end, — це спосіб тихо втрачати замовлення. Таймаут, який веде в дію, що створює
видимий запис про виняток або запускає наявний шлях «відхилити й добрати наново», перетворює
тиху зупинку на задачу, яка має власника.
Зі стовпцем затримки складніше, ніж здається, і причина в XSD. delay — це XSD duration,
яка вимірює час за годинником. Бізнес-дедлайн на кшталт «крайнього часу приймання замовлень магазином» вимірюється
за календарем, а в процесі відправлення той самий вузол очікування обслуговує всі склади, хай
який у них календар. Якщо прогнати ту саму модель із фіксованою затримкою на
waitForShipConsignment, видно, що це означає:
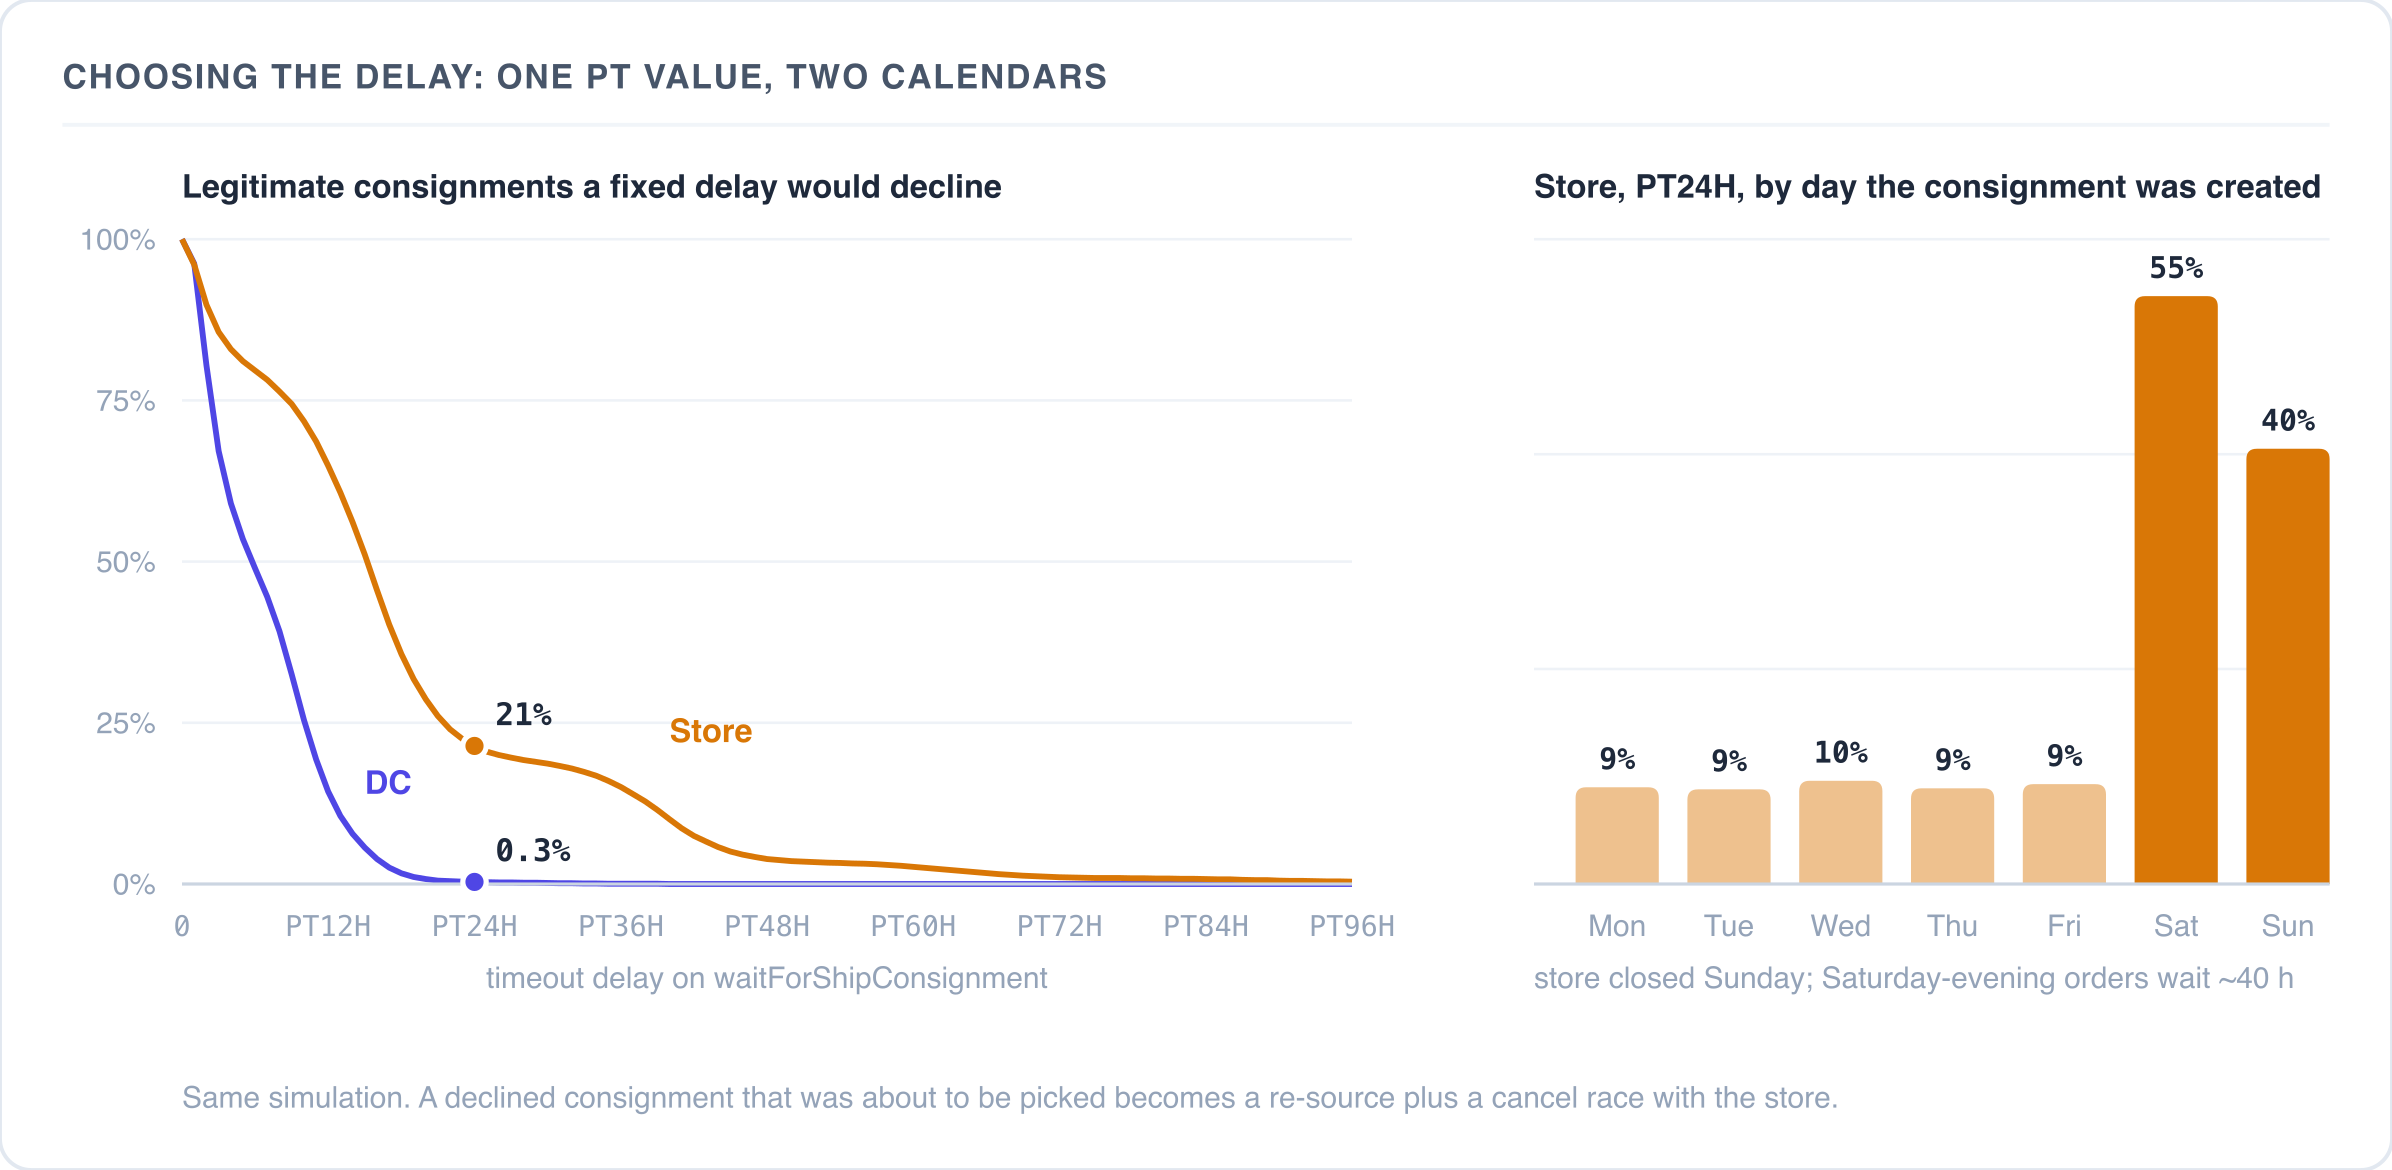
PT24H звучить щедро, і для РЦ так і є: таймаут спрацював би лише для 0,3% здорових відправлень.
Для магазинів те саме значення відхиляє 21% відправлень, які було б скомплектовано. Середнє
приховує картину. З понеділка по п'ятницю відхиляється близько 9%, здебільшого вечірні
замовлення, які чекають наступного відкриття. У суботу цифра становить 55%, бо замовлення,
зроблене в суботу після зачинення магазину, чекає на ранок понеділка близько 40 годин. Кожне
таке хибне відхилення наново добирає джерело для замовлення, яке йшло за планом, і запускає
перегони з продавцем, який, можливо, саме зараз його комплектує. Щоб хибних відхилень у магазинах
було менше за 1%, затримку доводиться підняти приблизно до PT72H. А це три дні тиші, перш
ніж хтось дізнається про відправлення з РЦ, загублене вже в першу годину.
Практичний вихід — вважати таймаут не дедлайном, а інтервалом перевірки. Поставте коротку затримку і спрямуйте таймаут у дію, яка вимірює вік відправлення в робочих годинах його складу. Ця дія повертає процес у вузол очікування, якщо бізнес-дедлайн ще не минув, і відхиляє відправлення, якщо минув. Тоді календарна логіка живе в Java, де їй і місце, а XSD duration задає лише те, як часто виконується перевірка.
Як розв'язуються then і choice
Кожен вузол очікування має обов'язковий атрибут then, і під час читання визначень його
природно сприймати як типовий наступний вузол. Насправді правило суворіше, і різниця виявляється
в інтеграційному коді.
Події можна надсилати з choice — іменованою гілкою. Процес замовлення активно цим користується:
<wait id='waitForOrderAction' prependProcessCode='true' then='failed'>
  <case event='OrderActionEvent'>
    <choice id='consignmentProcessEnded' then='verifyOrderCompletion'/>
    <choice id='cancelOrder' then='processOrderCancellation'/>
    <choice id='cancelled' then='success'/>
    <choice id='reSource' then='sourceOrder'/>
    <choice id='putOnHold' then='putOrderOnHold'/>
  </case>
</wait>
Логіка розв'язання, реконструкція:
// ілюстрація
String nextNode(NodeExecutionContext ctx) {
    if (!ctx.hasAnyChoice()) {
        return then; // choice не передано -> атрибут 'then'
    }
    Set<String> choices = ctx.getChoices();
    if (choices.size() > 1) {
        throw new IllegalStateException(
            "multiple choices are not supported");
    }
    String next = this.choices.get(choices.iterator().next());
    if (next == null) {
        throw new IllegalStateException(
            "choice was not declared in the process definition");
    }
    return next;
}
Кілька наслідків для всіх, хто надсилає ці події з коду.
Якщо надіслати OrderActionEvent для замовлення без choice, процес замовлення одразу
переходить у кінцевий вузол failed, який виставляє процесові стан FAILED і зупиняє його.
Інтеграція, яка підштовхує замовлення, надсилаючи подію без choice, завершує процес. Рядок
замовлення лишається, відправлення лишаються, оркестрація — ні.
Якщо надіслати її з choice, якого немає у визначенні, усередині task runner виникає
IllegalStateException. Задача падає, процес не просувається, а вузол очікування наново
не зводиться. Тепер замовлення застрягло так, що це має точнісінько такий вигляд, як «подія так
і не надійшла»; відрізнити одне від одного можна лише за стектрейсом у логах.
Якщо надіслати її одразу з двома choice, виникає той самий виняток. На це легко натрапити, якщо будувати універсальний інтеграційний ендпоінт «застосувати ось ці зміни стану».
Вузли очікування відправлень дають цьому раду елегантніше, і їхній прийом варто перейняти:
<wait id='waitForShipConsignment' prependProcessCode='true'
      then='waitForShipConsignment'>
then вказує на сам вузол. ConsignmentActionEvent без choice наново зводить очікування,
а не валить процес. Відправлення лишається там, де було, і для ідемпотентного підштовхування
це саме те, що треба. Чи навмисна ця асиметрія між процесом замовлення та процесом відправлення,
сказати не можу, але якщо ви однаково редагуєте визначення замовлення, спрямувати його then
в окрему дію «неочікувана подія», а не в failed, нічого не коштує і усуває пастку.
Як знайти замовлення, що застрягли
Якщо процес, що очікує, — це рядок, його можна знайти запитом. Потрібні таблиці — Tasks
(ProcessTask успадковує Task і ділить із ним таблицю), TaskConditions і Processes.
Застереження, незнання якого коштуватиме вам годину налагодження: Task.expirationDate
і TaskCondition.expirationDate — динамічні атрибути, що обчислюються в Java, і в базі
даних їх немає. Збережена колонка — expirationTimeMillis. Очевидний FlexibleSearch за
expirationDate зробить не те, що вам потрібно.
Робоча відправна точка на нативному SQL, щоб вивести процеси, що очікують, за віком і за вузлом, у якому вони чекають:
SELECT t.p_action                      AS wait_node,
       COUNT(*)                        AS stuck_count,
       MIN(p.createdTS)                AS oldest
FROM   tasks t
JOIN   processes p ON p.PK = t.p_process
WHERE  t.p_expirationtimemillis IS NULL
AND    p.createdTS < DATEADD(hour, -24, GETDATE())
GROUP  BY t.p_action
ORDER  BY stuck_count DESC;
Функцію роботи з датами підлаштуйте під свою базу даних. Результат — той самий
операційний артефакт, про який я казав на початку, — замовлення, які не рухалися N годин,
згруповані за станом, у якому вони застрягли, — і якщо ви ще не зробили для цього окремого
подання в Backoffice чи алерту, цей запит — найшвидший спосіб його отримати. Один раз прогнати
його на даних, схожих на продові, зазвичай повчально: waitForShipConsignment, як правило,
домінує, а в довгому хвості й ховаються баги інтеграцій.
Важить і те, коли його запускати. У змодельованому кварталі вище 24-годинний запит, запущений у четвер о 09:00, повертає 939 відправлень, які вже ніколи не зрушать з місця, і 54 просто повільних. Запущений у понеділок о 09:00, він повертає 903 застряглих і 605 здорових — це магазинні замовлення з вихідних. Той самий поріг, що посеред тижня дає чисту картину, після вихідних на 40% складається із шуму. Якщо запит живить алерт, запускайте його посеред тижня або вимірюйте вік у робочих годинах, як це робить дія за таймаутом вище.
Як змінювати визначення, коли замовлення вже виконуються
Щоб додати таймаут, треба відредагувати ImpEx із визначенням процесу й імпортувати його наново. Саме редагування нічим не примітне:
<wait id='waitForManualOrderCheckCSA' then='orderManualChecked'
      prependProcessCode='true'>
    <event>CSAOrderVerified</event>
    <timeout delay='PT4H' then='escalateFraudReview'/>
</wait>
де escalateFraudReview — бін дії, який ви пишете самі. Зверніть увагу, що вузлові тепер
потрібен справжній пункт призначення: таймаут, що вказує на дію, яка лише пише в лог, — це
спосіб позначити проблему як розв'язану, залишивши її нерозв'язаною.
Найцікавіше починається, коли йдеться про версіонування, бо поводиться воно не так, як підказує модель даних.
BusinessProcess, що виконується, зберігає назву визначення і версію визначення,
з якою він стартував, і рушій розв'язує кожен наступний вузол за цією парою. Поки що це схоже
на звичайне версіонування процесів: змінюєте визначення, а вже запущені екземпляри далі
працюють за тією схемою, з якою стартували.
На практиці такої ізоляції немає, бо другої версії ніхто ніколи не створює.
DynamicProcessDefinition.version — це Long із типовим значенням 0, з унікальним індексом
за (code, version, active), а провайдер перевіряє, що на один code припадає не більше
одного активного рядка. ImpEx, що постачається, оголошує code[unique = true] і взагалі
не містить колонки version, тож кожен повторний імпорт оновлює на місці той самий рядок —
версію 0. Кожне будь-коли запущене замовлення прив'язане до версії 0, а версія 0 — це те,
що ви імпортували останнім.
Перемикання визначає кеш, а не деплой. ProcessDefinitionsCache — це мапа на рівні JVM
із ключем (name, version); визначення, яке вже в ній є, віддається з пам'яті, а до бази даних
звертаються лише в разі промаху. Якщо скласти ці два факти, виходить реальна поведінка під час
зміни визначення процесу:
- уже запущені процеси справді підхоплюють нове визначення, бо вони розв'язуються у версію
0, а версія0змінилася в них під ногами; - підхоплюють вони його, коли кеш на ноді наступного разу заповниться, а на практиці це означає після перезапуску, тож зміна набуває чинності під час деплою, а не під час імпорту;
- ноди кластера, які перезапускаються в різний час, виконують різний вміст для тієї самої версії процесу, доки триває розгортання.
Зазвичай це нешкідливо, бо більшість змін додає вузли, а не видаляють їх. Шкода з'являється,
коли замовлення припарковане у вузлі очікування, якого в новому вмісті вже немає: пошук вузла
кидає NoSuchNodeException, і замовлення застрягає з винятком, у якому названо вузол, що ви
вже видалили з файлу, на який дивитеся.
Якщо потрібна справжня ізоляція, її доведеться збудувати самому: вставити новий рядок з явно вказаною
вищою version, перемкнути active і залишити старий рядок на місці, щоб уже запущені процеси
й далі могли за ним розв'язуватися. Жоден ImpEx у поставці цього не демонструє, і це непогано
пояснює, чому так майже ніхто не робить.
Що в підсумку
Рушій процесів під Order Management — це добротна інфраструктура: надійна, стійка до перезапусків, визначена даними і цілком здатна виражати дедлайни. Еталонні визначення Order Management залишають ці дедлайни неналаштованими, щоб їх задав проєкт, — а отже, доки ви їх не додасте, десять місць, де замовлення передає керування людині або зовнішній системі, не мають жодної страхувальної сітки. Це обов'язковий пункт чек-листа для кожного впровадження, і його можна повністю закрити з ImpEx.
Наступна стаття циклу: як SAP Commerce обирає склад. Рушій сорсингу оцінює склади-кандидати зваженою сумою за матрицею — на папері струнка модель, але відносна нормалізація в ній має неочевидні наслідки для того, як на практиці поводяться набори кандидатів.
Discussion
Powered by GitHub Discussions — sign in with a GitHub account to join the conversation.