
Це друга з п'яти статей циклу про SAP Commerce Order Management. Перша, Процеси Order Management, які ніколи не завершуються за таймаутом, розповідала про рушій процесів під OMS і про десять місць, де замовлення чекає на сигнал ззовні. Ця стаття спускається на рівень нижче, до кроку, який вирішує, звідки поїде товар.
Цикл присвячено механіці роботи в рантаймі та проєктним рішенням щодо конфігурації, тобто рівню, нижчому за прикладні посібники на SAP Help Portal. Якщо механізм там добре описано, я даю посилання замість переказу й витрачаю місце на ту поведінку, у якій доводиться розбиратися під час налаштування.
Про код у цій статті
Фрагменти Java нижче — це ілюстративна реконструкція: спрощений переказ алгоритму з перейменованими змінними та згорнутими гілками, мета якого — показати, що робить розрахунок. Це не відтворення жодної реалізації, і читати їх варто як схеми. З фрагментами Spring, ImpEx і XSD інакше: це конфігураційні файли з поставки, і я цитую їх як є, адже конфігураційний файл для того й існує, щоб його читали та змінювали.Вибір точки відвантаження — це задача про призначення
Покупець замовляє три товари. Ритейлер тримає запаси в національному розподільчому центрі, чотирьох регіональних складах і двохстах магазинах, які водночас працюють як точки фулфілменту. Щось має вирішити, яка фізична точка відвантажує яку позицію, і від цього рішення залежить більша частина витрат і більша частина клієнтського досвіду далі за ланцюжком.
Між чим доводиться обирати, у галузі добре відомо:
- Вартість і швидкість доставки. Ближче — дешевше й швидше, але до певної межі. Зональні тарифи перевізників роблять «ближче» ступінчастою функцією, а не плавною, тож найближча точка не завжди найдешевша.
- Кількість посилок. Дві посилки замість однієї приблизно подвоюють вартість доставки й стабільно знижують задоволеність. Заради того, щоб замовлення поїхало цілим, часто варто проїхати значно далі.
- Здоров'я запасів. Відвантаження з точки з найглибшим запасом захищає мережу від майбутніх out-of-stock. Відвантаження з точки, яка от-от знизить ціну на товар, розпродує залежані залишки. Ці дві цілі тягнуть у різні боки, і яка з них потрібна, залежить від категорії.
- Персонал. Магазинові, у якого сьогодні вже сорок завдань на відбір, не варто давати сорок перше, навіть якщо він найближчий.
- Бізнес-пріоритет. Флагманський магазин, 3PL-оператор із контрактними зобов'язаннями щодо обсягу, склад, який компанія збирається закрити.
Підходи до поєднання цих критеріїв вишиковуються в спектр. На простому кінці — впорядковані списки правил («спершу магазин самовивозу, потім регіональний склад, потім РЦ»): про них легко міркувати, але їх важко оптимізувати. Посередині — просте адитивне зважування: кожен кандидат отримує оцінку за кожним критерієм, оцінки нормалізуються до спільної шкали, множаться на ваги й підсумовуються. На складному кінці — повноцінні солвери, де сорсинг формулюють як задачу змішаного цілочислового програмування для всього замовлення й розв'язують, мінімізуючи загальну вартість. Так працюють великі OMS-продукти, створені спеціально для ритейлу.
SAP Commerce використовує просте адитивне зважування за чотирма критеріями, з вагами, які налаштовуються для кожного base store. Для комерційної платформи це розумний вибір, а далі в статті розібрано, як це зважування поводиться на практиці.
Як улаштовано крок сорсингу
Сорсинг читає замовлення й запаси та видає план, нічого не записуючи. Окремий крок алокації перетворює план на консайнменти й події щодо запасів; про нього буде наступна стаття.
Кроки по черзі:
- Позиції замовлення групуються. Позиції, які мають їхати разом (наразі це позиції зі спільною точкою самовивозу), утворюють один контекст сорсингу.
- Збираються й фільтруються склади-кандидати.
- Для контексту обирається стратегія сорсингу.
- Стратегія ранжує кандидатів за fitness і розподіляє кількості.
- Якщо нерозподілені кількості залишилися, запускається наступна стратегія, хіба що стратегія, яка відпрацювала, позначена як термінальна.
Крок 2 виконується у два окремі етапи, і під час читання Spring-конфігурації це легко пропустити: етапи лежать у різних пакетах, і лише в одного з них у назві є «sourcing».
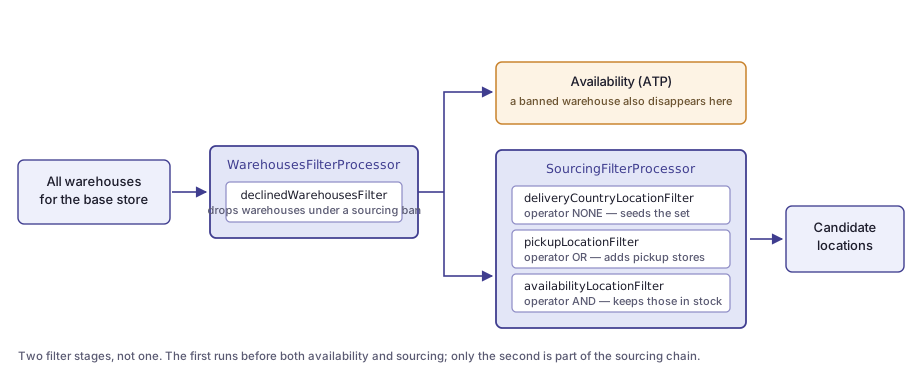
Зовнішній етап — WarehousesFilterProcessor з пакета warehouse.filter. Еталонний шаблон
дає йому єдиний фільтр:
<bean id="defaultWarehousesFilterProcessor"
      class="...warehouse.filter.WarehousesFilterProcessor">
  <property name="filters">
    <list>
      <ref bean="declinedWarehousesFilter"/>
    </list>
  </property>
</bean>
DeclinedWarehousesFilter прибирає склади, на яких зараз діє SourcingBan. Бан
створюється, коли склад відхиляє консайнмент; тривалість для причини «занадто завантажений»
задається властивістю й за замовчуванням дорівнює одному дню:
warehousing.ban.toobusy.days=1Цей процесор підключено ще й до стратегії вибору складів, якою користується розрахунок доступності. Склад, що відхилив консайнмент, випадає не лише з відбору кандидатів, а й із розрахунку ATP, і вітрина бачить бан як зниження доступності. Чи потрібно вам це, залежить від мережі. У мережі з десяти складів ефект важко помітити, а за двох складів бан на час своєї дії вдвічі знижує доступність. Якщо ви хочете, щоб бани сорсингу лишалися всередині сорсингу, це зміна в один рядок.
Внутрішній етап — SourcingFilterProcessor, і його фільтри комбінуються за допомогою операцій над
множинами, а не виконуються простим ланцюжком:
<bean id="sourcingFilterProcessor"
      class="...sourcing.filter.SourcingFilterProcessor">
  <property name="filters">
    <list>
      <ref bean="deliveryCountryLocationFilter"/>
      <ref bean="pickupLocationFilter"/>
      <ref bean="availabilityLocationFilter"/>
    </list>
  </property>
</bean>
Кожен фільтр оголошує filterResultOperator:
| Фільтр | Оператор | Дія |
|---|---|---|
deliveryCountryLocationFilter |
NONE |
заповнює множину складами, що обслуговують країну доставки |
pickupLocationFilter |
OR |
додає (об'єднанням) склад за обраною точкою самовивозу |
availabilityLocationFilter |
AND |
перетинає зі складами, де товар справді є |
Перший фільтр у списку має використовувати NONE, бо об'єднувати поки що нема з чим. Ця
вимога до порядку випливає з конфігурації, але нею не перевіряється, тож якщо ви вставляєте
власний фільтр на початок списку, дайте йому NONE, а оператор перенесіть на фільтр, який
раніше був першим.
Розрахунок fitness
Коли множина кандидатів готова, ранжування — це один вкладений цикл за елементами матриці.
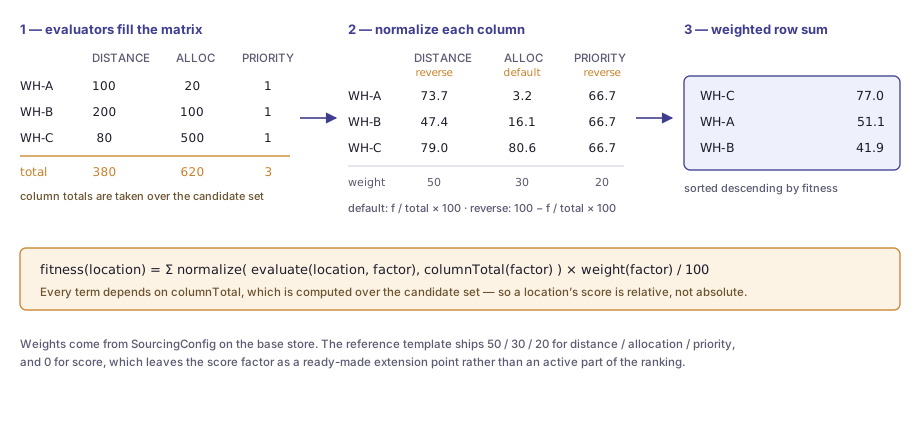
В еталонному шаблоні чотири фактори, у кожного є evaluator, що видає сире число, і нормалізатор, що переводить його в діапазон 0–100:
| Фактор | Вага за замовчуванням | Сире значення | Normalizer |
|---|---|---|---|
DISTANCE |
50 | кілометри до адреси доставки | reverse |
ALLOCATION |
30 | сумарна доступна кількість за товарами групи | default |
PRIORITY |
20 | Warehouse.priority, ціле число |
reverse |
SCORE |
0 | Warehouse.score, double |
default |
Ваги зберігаються в SourcingConfig, прив'язаному до base store, тобто задаються для
кожного base store окремо й змінюються в рантаймі без деплою. У посібниках SAP і в проєктних
шаблонах трапляються й інші приблизні розподіли ваг; значення має те, що записано у вашому
власному рядку SourcingConfig, а будь-яке значення за замовчуванням — лише відправна
точка. SCORE постачається з вагою 0: фактор повністю підключено, але він
бездіяльний, доки проєкт не почне заповнювати Warehouse.score з якогось зовнішнього
показника ефективності.
Обидва нормалізатори вміщаються в один рядок:
// ілюстрація
double normalizeDefault(double value, double columnTotal) {
    if (Double.isNaN(value) || Double.isNaN(columnTotal)) {
        return 0d;
    }
    return value / columnTotal * 100d;
}

// ілюстрація
double normalizeReverse(double value, double columnTotal) {
    if (Double.isNaN(value) || Double.isNaN(columnTotal)) {
        return 0d;
    }
    return 100d - value / columnTotal * 100d;
}
«Default» означає «більше — краще», «reverse» — «менше — краще». Відстань і пріоритет використовують зворотну форму, тому пріоритет 1 ранжується вище за пріоритет 5.
І саме ранжування:
// ілюстрація
double[][] matrix = new double[locations][factors];
double[] columnTotal = new double[factors];

// прохід 1 - оцінка з накопиченням суми за кожним стовпцем
for (int l = 0; l < locations; l++) {
    for (int f = 0; f < factors; f++) {
        matrix[l][f] = evaluatorFor(f).evaluate(location(l));
        columnTotal[f] += matrix[l][f];
    }
}

// прохід 2 - нормалізація за стовпцем, потім зважування й сума
for (int l = 0; l < locations; l++) {
    double fitness = 0d;
    for (int f = 0; f < factors; f++) {
        double norm = normalizerFor(f)
                .normalize(matrix[l][f], columnTotal[f]);
        fitness += norm * weightOf(f) / 100d;
    }
    result[l] = withFitness(location(l), fitness);
}

sortDescendingByFitness(result);
Щоб додати фактор, потрібні новий бін evaluator, запис у мапі та стовпець ваг. У наступних двох розділах розібрано властивості цього формулювання, через які на реальних даних виходять несподівані результати.
Fitness залежить від набору кандидатів
Нормалізація ділить на суму за стовпцем серед кандидатів, що беруть участь у цьому запуску. Тож оцінка точки — це частка суми за стовпцем, і вона змінюється, коли змінюється набір кандидатів.
Здебільшого цього не видно, бо додавання чи вилучення кандидата масштабує всі оцінки в стовпці на той самий множник, і порядок зберігається. Усе змінюється, коли суми двох факторів змінюються в різних пропорціях: розрив між двома точками в одному стовпці скорочується швидше, ніж в іншому.
Візьмімо замовлення з двох позицій по п'ять одиниць, яке обробляє NoSplittingStrategy;
вона шукає одну точку, здатну покрити все.
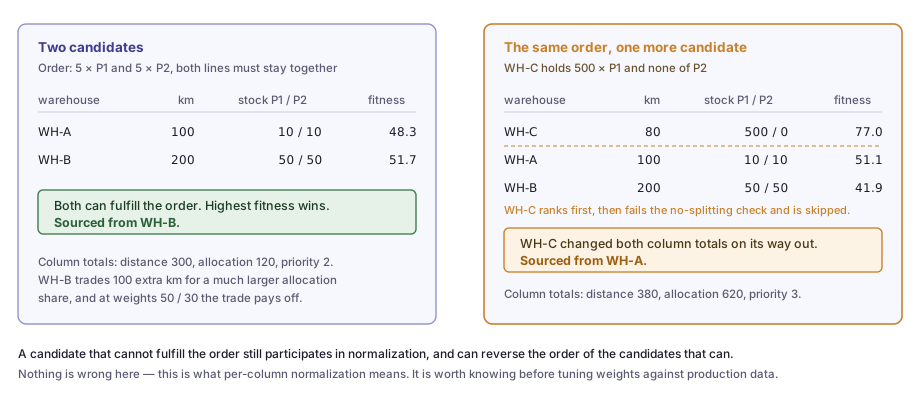
За двох кандидатів перемагає WH-B: він на 100 км далі, але запас у нього вп'ятеро більший, і за ваг 50 / 30 перевага за алокацією переважує штраф за відстань.
Тепер до набору кандидатів потрапляє третій склад. WH-C розташований поруч і має 500 одиниць першого товару й жодної другого, тож виконати це замовлення самотужки не може. Стратегія проранжує його, виявить, що перевірку на відсутність розбиття він не проходить, і пропустить. Але в обидві суми за стовпцями він уже зробив внесок: невеликий у відстань і дуже великий в алокацію. Розрив за алокацією між A і B стискається значно сильніше, ніж розрив за відстанню, і тепер перемагає WH-A.
Так працює нормалізація за стовпцями в будь-якій моделі простого адитивного зважування, і це впливає на те, як таку модель налаштовувати.
Добір ваг за агрегованими продакшн-даними менш надійний, ніж здається, бо ті самі ваги дають різне ранжування залежно від того, скільки кандидатів пройшло фільтри для конкретного замовлення. Під час налаштування фіксуйте набір кандидатів і змінюйте фактори по одному.
Фільтри теж беруть участь в оцінюванні. Фільтр, який відсікає явно непридатного кандидата,
поліпшує ранжування всіх інших, тому посилити SourcingFilterProcessor дешевше, ніж
перебалансовувати ваги.
Якщо відносна оцінка вашому бізнесові не підходить, можна написати власний
FitnessNormalizer, який переводить сире значення в абсолютну шкалу (наприклад, кілометри
відносно фіксованої стелі в 500 км), і зареєструвати його в fitnessNormalizerMap для
потрібних факторів. Нормалізатор отримує суму за стовпцем і може її ігнорувати.
Як працює фактор відстані
Значення — це відстань за дугою великого кола в кілометрах, обчислена за формулою гаверсинусів
із радіусом Землі 6372,8 км. Дороги й час у дорозі вона не враховує. У щільній міській
забудові та всюди, де заважають річки, гори чи кордони, похибка систематична й завжди в
один бік. Проєкти, яким це важливо, зазвичай замінюють DistanceEvaluator реалізацією, що
звертається до сервісу маршрутизації й агресивно кешує, адже evaluator викликається для
кожного кандидата під час кожної спроби сорсингу.
Щоб обчислити відстань, адреса доставки повинна мати координати. Їх записує
GeocodeShippingAddressAction — крок процесу замовлення, який виконується безпосередньо
перед сорсингом і повністю пропускається для замовлень із самовивозом. Він делегує роботу
біну geoServiceWrapper.
Еталонна реалізація за цим аліасом — заглушка, яка повертає координати для будь-якої адреси й ніколи не повідомляє про помилку:
<alias alias="geoServiceWrapper"
       name="defaultCommerceMockGeoWebServiceWrapper"/>
<bean id="defaultCommerceMockGeoWebServiceWrapper"
      class="...storelocator.impl.CommerceMockGeoWebServiceWrapper">
  <property name="baseStoreService" ref="baseStoreService"/>
  <property name="countryIsoGPSLocationMap"
            ref="countryIsoGPSLocationMap"/>
</bean>
У countryIsoGPSLocationMap дев'ять країн — CN, JP, US, GB, GG, IM, JE, DE, CA — плюс
DEFAULT із широтою 0 і довготою 0. Будь-яка адреса в країні зі списку геокодується в ту
саму фіксовану точку цієї країни; будь-яка адреса в решті світу — у Гвінейську затоку.
Виходить, що в щойно встановленій системі фактор відстані вимірює відстань від кожного
складу до однієї з десяти фіксованих точок на Землі. Усі замовлення з доставкою в ту саму
країну дають однакове ранжування за відстанню незалежно від реальної адреси. Для демо й
інтеграційних тестів цього досить, а підключення справжнього геокодера — задокументований і
нескладний крок: заміна аліасу на GoogleMapsServiceWrapper займає два рядки. Я згадую це
тому, що до такої заміни результати сорсингу виглядають цілком правдоподібно, і її легко
відкласти на потім, а згодом витратити день на з'ясування, чому найближчий магазин ніколи не
виграє.
Одна відсутня координата вимикає весь фактор
Друга властивість відстані стосується й усіх інших факторів.
DistanceSourcingLocationPopulator записує у відстань null у п'яти різних випадках:
замовлення не має адреси доставки; склад не має точки обслуговування; точка обслуговування
не має адреси; адреса замовлення не має широти чи довготи; точка обслуговування не має
широти чи довготи. У кожному випадку пишеться рядок рівня INFO, і обробка йде далі.
// ілюстрація
if (deliveryAddress == null) {
    log.info("no delivery address; distance is null");
    target.setDistance(null);
    return;
}
PointOfServiceModel pos = posSelection.get(order, warehouse);
if (pos == null || pos.getAddress() == null) {
    log.info("no usable point of service; distance is null");
    target.setDistance(null);
    return;
}
// ... перевірки широти й довготи влаштовані так само ...
target.setDistance(haversine(posLat, posLon, addrLat, addrLon));
DistanceEvaluator перетворює цей null на Double.NaN. Перший прохід додає кожне сире
значення до суми за стовпцем, тож одного NaN досить, щоб уся сума за стовпцем стала NaN.
Другий прохід передає цю суму нормалізаторові, а той повертає 0, якщо будь-який з
аргументів — NaN, причому для кожного рядка, зокрема й тих, де відстань коректна.
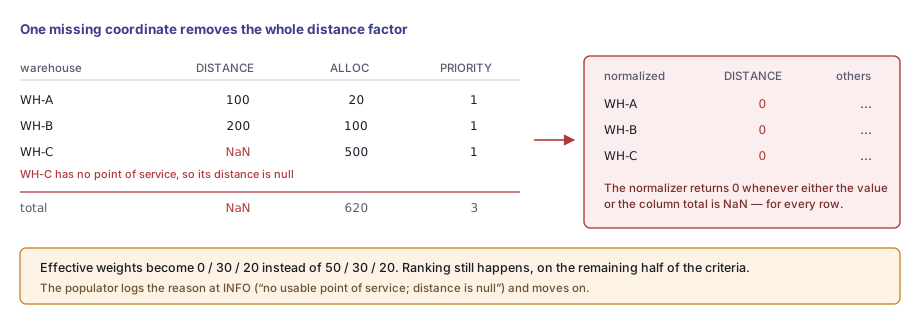
Фактичні ваги стають 0 / 30 / 20. Сорсинг і далі видає правдоподібну відповідь зі звичайним виводом у лог, але для цього замовлення відстань більше не враховує. Для цього досить одного розподільчого центру без прив'язаної точки обслуговування або одного магазину, адресу якого імпортували без координат.
Той самий механізм діє й для інших факторів. Warehouse.priority — це Integer без
значення за замовчуванням, тому склад, створений через ImpEx без явного пріоритету, має там
null і прибирає фактор пріоритету з кожного замовлення, у якому бере участь як кандидат.
Warehouse.score має значення за замовчуванням 0, тож із ним безпечніше, але проєкт, який
заповнює його із зовнішнього джерела, може знову отримати ту саму прогалину.
У проєкті, який покладається на сорсинг, я додав би до пайплайну деплою перевірку даних:
кожен склад, що може стати кандидатом сорсингу, має точку обслуговування з координатами й
непорожній пріоритет. Ще я додав би власні evaluator'и, які замість NaN підставляють
задане запасне значення (велику відстань для невідомої точки, середній пріоритет для
незаданого), щоб прогалина в даних погіршувала оцінку одного кандидата, а не вимикала цілий
критерій.
Фактор алокації вимірює глибину запасу
AllocationFitnessEvaluator підсумовує за всіма позиціями замовлення в контексті сорсингу
доступну в точці кількість товару кожної позиції:
// ілюстрація
double evaluate(SourcingLocation location) {
    long total = 0L;
    for (AbstractOrderEntryModel entry : contextEntries(location)) {
        Long available = location.getAvailability()
                                 .get(entry.getProduct());
        total += (available == null) ? 0L : available;
    }
    return (double) total;
}
Це міра глибини запасу в парі з нормалізатором default, тобто більше — краще. З погляду бізнесу це означає «надавай перевагу точці, де товар закінчиться з найменшою ймовірністю», і для мережі, де довгий хвіст краще зберігати, ніж розпродувати, це обґрунтоване значення за замовчуванням.
Назва наводить на іншу думку, тому скажу прямо: фактор не вимірює, яку частину замовлення точка може покрити, і не вимірює, скільки залишиться нерозподіленим. Точка з 1000 одиниць отримує оцінку значно вищу, ніж точка рівно з тими 10, які потрібні замовленню, хоча обидві покривають замовлення повністю. Підсумовування за позиціями замість мінімуму дає той самий ефект: точка з великим запасом одного товару й нулем іншого може випередити точку, де є потроху всього.
Чи правильна це мета — питання бізнесу, і відповідь залежить від категорії. Якщо вам
потрібне покриття, а не глибина, зміна невелика й ізольована: власний evaluator, що повертає
нерозподілений залишок і зареєстрований у fitnessEvaluatorMap під ключем ALLOCATION:
// ілюстрація - менше означає краще, тому під час реєстрації
// ставте в пару нормалізатор reverse
double evaluate(SourcingLocation location) {
    long shortfall = 0L;
    for (AbstractOrderEntryModel entry : contextEntries(location)) {
        long needed = unallocatedQuantity(entry);
        long available = availabilityOf(location, entry);
        shortfall += Math.max(0L, needed - available);
    }
    return (double) shortfall;
}
Evaluator'у, у якого менше означає краще, потрібен нормалізатор reverse, а
fitnessNormalizerMap індексується за фактором, тому змінюйте обидва записи разом, інакше
фактор інвертується. Саме тут найчастіше помиляються з власними факторами: інвертований
фактор не кидає винятку і ставить найгіршого кандидата на перше місце.
Стратегії сорсингу та прапорець terminal
Стратегія сорсингу вирішує, як ранжовані кандидати перетворюються на призначення. Еталонний шаблон постачає три стратегії.
NoSplittingStrategy ранжує кандидатів і бере першого, хто може повністю покрити кожну
позицію групи. Якщо такого немає, вона нічого не призначає й позначає результат як
неповний.
// ілюстрація
List<SourcingLocation> ranked = fitnessService.sortByFitness(ctx);
ranked.stream()
      .filter(loc -> coversEveryLine(ctx.getOrderEntries(), loc))
      .findFirst()
      .ifPresent(best -> ctx.getResult().getResults()
              .add(resultFactory.create(ctx.getOrderEntries(), best)));
ctx.getResult().setComplete(isFullyAssigned(ctx));
NoRestrictionsStrategy проходить ранжованим списком і забирає з кожної точки скільки
може, доки замовлення не буде покрито. Це жадібний прохід без глобальної мети, і кількість
посилок виходить як наслідок ранжування.
Дві стратегії виконуються послідовно, спершу NoSplittingStrategy, — так еталонний шаблон
виражає принцип «краще одна посилка, але можна й кілька». Якщо для вашого бізнесу
найважливіше, щоб замовлення поїхало цілим, урахуйте, що ця перевага не має ваги: його
виражено лише порядком у списку. Проєктові, якому потрібен налаштовуваний компроміс, потрібна
стратегія, що явно призначає вартість розбиттю.
PickupStrategy обслуговує click-and-collect. Її обирає мапер, а не позиція в списку:
<bean id="pickupSourcingStrategyMapper"
      class="...strategy.mapper.impl.PickupSourcingStrategyMapper">
  <property name="strategy" ref="pickupSourcingStrategy"/>
</bean>
Мапер спрацьовує, коли кожна позиція контексту має deliveryPointOfService. Логіка після
цього тривіальна, бо точку покупець уже обрав сам.
Ще в біні задано властивість, яку інші стратегії залишають зі значенням за замовчуванням:
<bean id="defaultSourcingPickupStrategy"
      class="...sourcing.strategy.impl.PickupStrategy"
      parent="abstractSourcingStrategy">
  <property name="posSelectionStrategy" ref="posSelectionStrategy"/>
  <property name="terminal" value="true"/>
</bean>
terminal="true" зупиняє ланцюжок стратегій. Якщо в обраному магазині товару бракує,
стратегія призначає те, що є, позначає контекст як неповний, і жодна наступна стратегія не
запускається. Замовлення із самовивозом ніколи не перенаправляється в іншу точку. Я вважаю
це правильною поведінкою за замовчуванням: покупець, який обрав магазин, щоб прийти туди, не
хоче, щоб його замовлення без запиту відправили звідкись іще.
Але це означає, що часткове виконання самовивозу стає питанням бізнес-процесу, а не сорсингу. Залишок лежить нерозподіленим, доки хтось або щось на нього не відреагує, і вирішити, що саме (повідомити й чекати, запропонувати розбиття, перевести залишок у доставку), треба в проєктному чек-листі. Еталонний шаблон залишає це відкритим, і під час запуску з незміненим шаблоном це легко пропустити.
Чек-лист перед запуском
Проєктні рішення з цієї статті:
| Сфера | Що вирішити |
|---|---|
| Геокодування | замінити заглушку; перевірити, що координати потрапляють в адреси, а не в точки країн |
| Дані складів | кожен кандидат має точку обслуговування з координатами й непорожній пріоритет |
| Запасні значення факторів | власні evaluator'и повертають задане значення замість NaN |
| Ваги | задати SourcingConfig для кожного base store за власною моделлю витрат, а не за значеннями за замовчуванням |
Семантика ALLOCATION |
переконатися, що вам потрібна саме глибина запасу, а не покриття |
| Бани сорсингу | вирішити, чи має склад, що відхилив консайнмент, випадати ще й з ATP |
| Фільтри | посилити SourcingFilterProcessor, адже фільтри впливають не лише на набір кандидатів, а й на оцінки |
| Нестача під час самовивозу | визначити, що відбувається із залишком, коли в магазині самовивозу бракує товару |
| Вартість розбиття | якщо кількість посилок важлива, задати їй явну вартість, а не покладатися на порядок стратегій |
Більша частина цього — зміни конфігурації або невеликі біни; сам рушій можна залишити як є.
Наступна стаття циклу (не знаю, як скоро..): доступність до продажу без резервування. Розрахунок ATP збирається за допомогою рефлексії з елемента формули, булеві властивості якого зіставляються з іменами методів DAO, а кількості, що визначають стан замовлення (allocated, shipped, pending, unallocated), — динамічні атрибути, і це безпосередньо позначається на всіх, хто намагається будувати за ними звіти в SQL.
Discussion
Powered by GitHub Discussions — sign in with a GitHub account to join the conversation.