
Часть 1. Задача
Откуда в индексе мусор
Типичная ситуация: есть поисковый индекс, наполненный краулером. Сотни тысяч или миллионы страниц, из каждой HTML-разметка уже выброшена, остался текст. Этот текст индексируется, по нему считается релевантность, из него режутся сниппеты, а в последние годы — ещё и чанки для эмбеддингов и RAG.
Проблема в том, что значительная часть этого текста — не контент. Это:
- шаблон сайта: меню, хлебные крошки, футер, «© 2024 Компания. Все права защищены», ссылки на соцсети;
- служебные блоки: баннер про cookies, «Подпишитесь на рассылку», «Мы используем файлы cookie, чтобы…»;
- юридические дисклеймеры: «Информация на сайте не является публичной офертой», «Цены и наличие могут отличаться», «Перед применением проконсультируйтесь со специалистом»;
- блоки, которые CMS вставляет в тело статьи: «Читайте также», подписи к стандартным виджетам, повторяющиеся абзацы «о компании» в конце каждой новости.
Часть этого отрезается DOM-эвристиками ещё при парсинге. Но только часть: дисклеймер, вставленный редактором в тело каждой статьи, с точки зрения разметки ничем не отличается от контента. А если индекс собирался давно, разными версиями парсера, с разных сайтов — что именно в нём осталось, никто уже толком не знает.
Чем это вредит
Это не только место на диске.
- Длина документа. BM25 и почти все его родственники нормализуют вес термина на длину документа. Страница с короткой карточкой товара и длинным футером «наказывается» за футер.
- Сниппеты. Если запрос случайно совпал со словами из дисклеймера, сниппет покажет дисклеймер.
- Эмбеддинги и RAG. Чанк, на треть состоящий из «Мы используем файлы cookie…», получает вектор, который тянет его к другим таким же чанкам. Для векторного поиска все страницы сайта начинают немного походить друг на друга.
- Дедупликация и near-duplicate detection. Две разные карточки товара с одинаковым на 80% шаблоном выглядят как почти-дубликаты.
- Обучение моделей. Для LLM это известная проблема: повторяющиеся фрагменты
в обучающих данных модель запоминает дословно. В корпусе
Colossal Clean Crawled Corpus — очищенной выгрузке Common Crawl, на которой обучали
T5 и многие другие модели, — нашлось
английское предложение из 61 слова, повторённое больше 60 тысяч раз.Lee, Katherine; Ippolito, Daphne; Nystrom, Andrew et al. — Deduplicating Training Data Makes Language Models Better (ACL 2022, arXiv:2107.06499). Точная дедупликация подстрок через суффиксный массив — тот же класс задачи, что и наш, только с другой целью.
Поэтому вопрос, с которого всё началось, был простой: сколько в нашем индексе такого мусора и что это за фрагменты? Не «как его вырезать» — а сначала просто увидеть.
Почему не DOM-эвристики
Классический ответ на «как убрать boilerplate» — анализ отдельной страницы: плотность текста в блоке, доля ссылок, длина абзацев, позиция в DOM. На этом построены Boilerpipe, jusText, Trafilatura и их потомки.
У этого подхода два ограничения, которые для нашей задачи принципиальны:
- Он смотрит на одну страницу. Он не знает, что абзац, который выглядит как нормальный текст, дословно повторяется ещё на 40 тысячах страниц.
- Ему нужна разметка. А в индексе разметки уже нет — только текст.
Определение, которое работает без разметки и без знания о конкретном сайте, звучит так: мусор — это то, что повторяется. Не отдельные слова (слово «и» тоже повторяется), а длинные фрагменты, которые дословно встречаются во многих разных документах. Именно это мы и будем искать.
Идея не новая: поисковики занимались поиском повторяющихся фрагментов в коллекциях документов как минимум с середины 2000-х.
Часть 2. Формулировка
Прежде чем выбирать алгоритм, нужно аккуратно сказать, что мы ищем. Каждое слово в определении ниже потом отзовётся на сложности алгоритма.
Документы и токены
Документ — это последовательность токенов. Токенизация самая простая: привести к
нижнему регистру, порезать по всему, что не буква и не цифра. Пунктуация
пропадает, «Все права защищены.» и «все права защищены» — одно и то же. Каждый
токен заменяется целым числом из словаря, так что дальше мы работаем не со
строками, а с массивами int.
Фраза
Фраза — это непрерывный кусок документа: токены с i-го по (i+k−1)-й, без пропусков. Это важно: «доставка бесплатно» и «доставка … бесплатно» — разные вещи, второе нас не интересует.
Поддержка: в скольких документах, а не сколько раз
Поддержка фразы — число документов, в которых она встречается хотя бы
раз. Обозначим её df(P), как document frequency в поиске.
Почему не общее число вхождений? Потому что фраза, повторённая 500 раз внутри одного длинного документа (рефрен песни, повторяющаяся строка таблицы), — это не шаблон. Шаблон — это то, что проходит через документы.
Порог σ (сигма) — минимальная поддержка, начиная с которой фраза нам
интересна. Фраза с df ≥ σ называется частой.
Максимальность
Если фраза «доставка бесплатно при заказе от 3000 рублей» встречается в 1000 документов, то и каждый её кусок — «доставка бесплатно», «при заказе от», «от 3000 рублей» — встречается не меньше чем в 1000. Перечислять их все бессмысленно: вместо одной находки мы получим десятки её обрезков.
Поэтому ищем только максимальные частые фразы: частые, которые нельзя удлинить ни влево, ни вправо так, чтобы фраза осталась частой.
Это то, что в литературе называется MCFP — Maximal Contiguous Frequent Phrase. Задача: дан корпус и порог σ, найти все MCFP. Обычно добавляют ещё минимальную длину: фразы короче 5–10 токенов нам не интересны, даже если они частые.
Игрушечный пример, который пройдёт через всю статью
Четыре «страницы» интернет-магазина, σ = 3:
Д1: новый ноутбук acer swift доставка бесплатно при заказе от 3000 рублей
Д2: чехол для iphone 15 доставка бесплатно при заказе от 3000 рублей
Д3: доставка бесплатно при заказе от 3000 рублей наушники sony
Д4: наушники sony wh 1000 доставка бесплатно
Ответ:
- «доставка бесплатно при заказе от 3000 рублей» —
df = 3(Д1, Д2, Д3). Частая. Влево не удлиняется (перед ней «swift», «15» и начало документа), вправо — тоже. Максимальная. - «доставка бесплатно» —
df = 4. Частая, и даже чаще. Но не максимальная: её удлинение «доставка бесплатно при» тоже частое (df = 3 ≥ σ). - «наушники sony» —
df = 2 < 3. Не частая.
Обратите внимание на второй пункт: у подфразы поддержка выше, чем у максимальной фразы, и всё равно она в ответ не попадает. Максимальность — не «самая частая», а «самая длинная из ещё частых». Это пригодится, когда будем проверять максимальность в алгоритме.
Часть 3. От простого к сложному
Шаг 0. Посчитать n-граммы
Самое очевидное решение: выбрать длину n, пройти окном по всем документам, сложить все n-граммы в хеш-таблицу «n-грамма → множество документов», отфильтровать по σ.
Для n = 2 на нашем примере:
доставка бесплатно   {Д1, Д2, Д3, Д4}   df=4  ✓
бесплатно при        {Д1, Д2, Д3}       df=3  ✓
при заказе           {Д1, Д2, Д3}       df=3  ✓
заказе от            {Д1, Д2, Д3}       df=3  ✓
от 3000              {Д1, Д2, Д3}       df=3  ✓
3000 рублей          {Д1, Д2, Д3}       df=3  ✓
наушники sony        {Д3, Д4}           df=2
новый ноутбук        {Д1}               df=1
... ещё полтора десятка с df=1
Работает. Проблем три, и все три ведут к следующим шагам.
Проблема 1: какое n? Шаблонная фраза может быть длиной 6 токенов, а может быть 300 (целый абзац дисклеймера). Фиксированное n либо режет длинные фразы на куски, либо пропускает короткие.
Проблема 2: память. Число различных n-грамм на естественном языке растёт почти так же, как число токенов: начиная с n = 3–4 подавляющее большинство n-грамм уникальны. На корпусе в 3 млрд токенов это миллиарды ключей в хеш-таблице, у каждого — список документов. Никакой памяти не хватит, и почти вся она уйдёт на n-граммы, которые встретились один раз и нам заведомо не нужны.
Проблема 3: обрезки. Даже если перебрать все n, ответ будет состоять из вложенных друг в друга кусков одной и той же фразы. Вот реальный фрагмент вывода моего раннего прототипа без проверки максимальности (корпус — исходники Java, поэтому «шаблон» здесь — это аннотации и импорты):
df=2985  len=9  import org springframework beans factory annotation required public class
df=2985  len=8         org springframework beans factory annotation required public class
df=2985  len=7             springframework beans factory annotation required public class
df=2985  len=6                             beans factory annotation required public class
df=2985  len=5                                   factory annotation required public class
Пять строк, одна находка. В том прогоне таких строк было 77 тысяч.
Шаг 1. Apriori: расти от частого к частому
Ключевое наблюдение, на котором стоит вся область: поддержка
антимонотонна. Если фраза P встречается в документе, то и любой её кусок там
встречается. Значит, df(кусок) ≥ df(P). Следствие: если короткая фраза
не частая, то никакая фраза, которая её содержит, тоже не частая.
Это даёт стратегию: начать с частых коротких фраз и удлинять только их. Нечастое удлинение отбрасывается вместе со всем, что из него могло бы вырасти. Это идея Apriori/GSP — классики data mining середины 90-х.
На примере: из всех биграмм частых шесть. «наушники sony» отброшена — значит, и
«наушники sony wh», и всё дальше можно не смотреть. А «доставка бесплатно»
удлиняется в «доставка бесплатно при» (df=3), то — в «доставка бесплатно при
заказе» (df=3), и так до «… 3000 рублей». Дальше удлинять нечем: справа у Д1 и
Д2 конец документа, у Д3 — «наушники», df = 1.
Проблема 1 (какое n) решена: длина больше не параметр, фраза растёт сама, пока остаётся частой. Проблема 3 (обрезки) решается проверкой максимальности на выходе. А проблема 2 (память) — нет: на первом уровне всё равно нужно посчитать все биграммы, чтобы узнать, какие из них частые.
Шаг 2. Sequential pattern mining: слишком общий инструмент
Для задачи «найти частые последовательности» существует целое семейство готовых алгоритмов: GSP, PrefixSpan, SPADE, BIDE+, VMSP, CloSpan. Многие собраны в библиотеке SPMF, их легко взять и запустить.
Подвох в том, что они решают другую, более общую задачу. В классическом
sequential pattern mining между элементами паттерна допускаются пропуски:
паттерн ⟨A, B, C⟩ считается присутствующим в документе, если там есть
A … что угодно … B … что угодно … C. Для анализа покупательских корзин это
ровно то, что нужно. Для текста — комбинаторный взрыв: в длинном документе почти
любые три частых слова найдутся в нужном порядке где-нибудь на расстоянии
нескольких тысяч токенов друг от друга. Число кандидатов растёт на порядки, и
почти все они бессмысленны.
Можно ограничить эти алгоритмы непрерывными расширениями (в SPMF есть, например, вариант BIDE+ «contiguous»), но их внутренние структуры данных — проецированные базы, списки позиций для каждого префикса — спроектированы под общий случай и памяти потребляют соответственно. В наших бенчмарках все SPMF-алгоритмы (BIDE+, VMSP, GST) упали по памяти уже на 1000 книг — это порядка 60 миллионов токенов при куче в 40 ГБ. До миллиардов им далеко.
Вывод: нужен инструмент, который с самого начала знает, что пропусков нет.
Шаг 3. Суффиксный массив: точный ответ из стрингологии
Задача «найти все повторяющиеся подстроки» — классика стрингологии, и у неё есть классическое решение.
Суффиксный массив — это все суффиксы текста, отсортированные лексикографически (хранятся, конечно, не сами суффиксы, а их начальные позиции). LCP-массив рядом с ним хранит для каждой пары соседних суффиксов длину их общего префикса.
Почему это решает задачу: все вхождения любой подстроки в отсортированном массиве суффиксов лежат подряд — это суффиксы, которые с неё начинаются. А LCP-массив говорит, где такие блоки начинаются и заканчиваются.
Маленький пример. Склеим три документа в один текст с разделителями (буквы — это токены):
Д1: A B C D Д2: X A B C Д3: A B C YОтсортированные суффиксы (показываю только начало каждого) и LCP с предыдущим:
  #   суффикс          док   LCP
  1   A B C $          Д2    —
  2   A B C D $        Д1    3
  3   A B C Y $        Д3    3
  4   B C $            Д2    0
  5   B C D $          Д1    2
  6   B C Y $          Д3    2
  7   C $              Д2    0
  ...
Строки 1–3 образуют LCP-интервал: три соседних суффикса с общим префиксом
длины ≥ 3, то есть «A B C». Суффиксы из трёх разных документов — df = 3.
Строки 4–6 — интервал для «B C», тоже df = 3, но «B C» содержится в «A B C» с
той же поддержкой, так что она не максимальная.
Обход всех LCP-интервалов снизу вверх (с помощью стека) перечисляет все
повторяющиеся подстроки, а подсчёт различных документов в каждом интервале даёт
df. На этом построен алгоритм Фишера–Хойна–Крамера (FHK) — он решает задачу
за время, асимптотически оптимальное по размеру входа. Есть и альтернатива с
обходом сверху вниз и ранним отсечением поддеревьев — DFI (Deferred Frequency
Index).
Это точный и красивый метод. Его проблема — константы. Суффиксный массив и LCP-массив — это по целому числу на каждый токен корпуса, плюс сам текст, плюс массив «какому документу принадлежит позиция», плюс вспомогательные структуры обхода. И всё это строится для всего корпуса, включая миллиарды позиций, с которых не начинается ни одна частая фраза. В наших замерах FHK доходит до 30 тысяч книг (≈1,7 млрд токенов) и падает по памяти дальше, а DFI со своей sparse-таблицей для RMQ — уже на 5 тысячах.
Стрингология отвечает на вопрос «где повторяется любая подстрока». Нам нужен ответ на вопрос поуже: «где повторяется частая подстрока». И большинство подстрок естественного языка — не частые.
Часть 4. BloomSpan
Главная идея
Посмотрим на корпус глазами закона Ципфа. Распределение n-грамм в естественном языке — длинный хвост: подавляющее большинство встречаются один-два раза. Это относится и к биграммам. На корпусе Gutenberg при σ = 20 из всех биграмм порогу соответствуют около 2%.
Отсюда идея: сначала дёшево выбросить 98% корпуса, а дорогие структуры строить только для оставшихся 2%.
«Дёшево» здесь значит — не храня сами n-граммы. Для этого есть вероятностные структуры данных.
Фильтр Блума со счётчиками
Обычный фильтр Блума отвечает на вопрос «встречался ли этот элемент?» — битовый массив, элемент хешируется, соответствующие биты выставляются в 1. Он может ошибиться в одну сторону: сказать «да» про элемент, которого не было (коллизия хешей). Но никогда не скажет «нет» про элемент, который был.
Счётный фильтр Блума (Counting Bloom Filter) вместо битов хранит маленькие счётчики. Добавить элемент — увеличить счётчик в ячейке, куда он хешируется. Спросить «сколько раз встречался» — прочитать счётчик.
Свойство то же: ошибка только вверх. Если в ячейку попали две разные биграммы, счётчик покажет сумму — то есть больше, чем у каждой. Меньше, чем на самом деле, он не покажет никогда.
Игрушечная иллюстрация: массив из 8 счётчиков, биграммы хешируются в ячейки.
ячейка:     0   1   2   3   4   5   6   7
счётчик:    3   1   4   0   3   2   3   5
                    ↑                   ↑
         «доставка бесплатно»     сюда попали три биграммы:
              (4 раза)            «3000 рублей»   (3 раза)
                                  «новый ноутбук» (1 раз)
                                  «sony wh»       (1 раз)
«новый ноутбук» встретилась один раз, но из-за коллизии фильтр говорит «5». На этапе фильтрации она пройдёт как кандидат — и будет отсеяна позже, при точном подсчёте. Обратная ситуация — частая биграмма, которой фильтр насчитал меньше σ, — невозможна.
Почему фильтр не теряет ни одной частой фразы
Это центральное свойство алгоритма, и оно доказывается в три строки.
Фильтр считает не документную частоту df, а общее число вхождений c — так
проще: не нужно помнить, в каком документе мы уже увеличивали счётчик. Пусть
ĉ(S) — то, что показывает фильтр для n-граммы S.
- Коллизии только добавляют:
ĉ(S) ≥ c(S). - Каждый документ, где есть S, даёт хотя бы одно вхождение:
c(S) ≥ df(S). - Значит,
ĉ(S) ≥ df(S), и еслиdf(S) ≥ σ, то фильтр точно покажет≥ σ.
Итак, все по-настоящему частые n-граммы проходят фильтр. Осталось убедиться, что из них можно вырастить все частые длинные фразы. Это следует из антимонотонности: любая частая фраза длины ≥ n содержит n-грамму, которая тоже частая (с поддержкой не меньше). Значит, у каждой частой фразы есть хотя бы один «сид», переживший фильтр.
Ложноотрицательных результатов на этапе отбора нет. Ложноположительные есть, и их немало: фильтр считает вхождения, а не документы, поэтому биграмма, которая 20 раз встретилась в одной книге, тоже пройдёт при σ = 20. Их отсеет следующий, уже точный шаг.
Как это выглядит в коде (Java-реализация, сокращено):
// Размер: 8 байт на токен корпуса, но не больше 512 МБ
byte[] filter = new byte[filterSize];

// Один линейный проход: каждая биграмма увеличивает свой счётчик
for (int p = 0; p <= seq.length - n; p++) {
    int idx = (int) (Math.abs(hashTokens(seq, p, n)) % filter.length);
    int c = filter[idx] & 0xFF;
    if (c < 255) filter[idx] = (byte) (c + 1);   // насыщение на 255
}
Пара инженерных деталей. Хеш — FNV-1a по целочисленным токенам. Функция одна,
так что формально это одна строка Count-Min Sketch, а не «настоящий»
многохешевый фильтр Блума; на гарантию это не влияет, влияет только на долю
ложноположительных. Счётчик — один байт, и он насыщается на 255; поэтому
сравнение идёт с min(σ, 255), и гарантия «ошибка только вверх» сохраняется.
Второй фильтр — по отдельным словам
Помимо фильтра по биграммам, есть второй, совсем дешёвый: точная документная частота каждого отдельного токена (их в словаре миллионы, а не миллиарды, так что это просто хеш-таблица). Если хотя бы одно слово биграммы встречается меньше чем в σ документах, биграмма не может быть частой — та же антимонотонность.
Кандидат-сид проходит, только если пройдены оба фильтра. На корпусе Gutenberg-BookCorpus при σ = 20 вместе они отсекают 98% всех биграмм.
Слияние сидов и точная поддержка
Для выживших 2% мы, наконец, можем позволить себе точность. Каждое вхождение
кандидата записывается как (биграмма, документ, позиция); биграмма из двух
32-битных токенов упаковывается в один long. Массив параллельно сортируется, и
одинаковые биграммы оказываются рядом. Один проход по нему — и для каждой
биграммы известен точный список вхождений и точный df. Всё, у чего
df < σ, выбрасывается: это ложноположительные фильтра.
На этом этапе у нас есть сиды: частые биграммы со списками всех их вхождений.
Порядок обработки: сначала самое «тяжёлое»
Сиды сортируются по оценке
Ψ(P) = |P| × df(P)— длина на поддержку, то есть примерно «сколько токенов корпуса покрывает эта фраза». При равенстве — длиннее раньше, потом лексикографически (чтобы результат был детерминирован).
Зачем: первыми обрабатываются сиды, из которых вырастут самые массивные шаблоны — «хребты» корпуса. Когда такой хребет найден, все его кусочки, которые попадутся позже, будут быстро распознаны как уже покрытые.
Рост вглубь прямо по корпусу
Каждый сид растёт вправо поиском в глубину со стеком. Для текущей фразы смотрим на токен, следующий за каждым её вхождением, и группируем вхождения по этому токену. Каждая группа, которая покрывает ≥ σ документов, — это частое удлинение, оно кладётся в стек.
Важно, где это происходит: прямо в исходном массиве токенов. Никаких
проецированных баз, никаких копий суффиксов: вхождение — это пара
(документ, позиция), и «следующий токен» — это просто doc[pos + len].
На примере: сид «доставка бесплатно» (вхождения в Д1, Д2, Д3, Д4). Следующие токены: Д1 → «при», Д2 → «при», Д3 → «при», Д4 → конец документа. Группа «при» покрывает 3 документа ≥ σ → в стек кладётся «доставка бесплатно при» с тремя вхождениями. И так далее до «… 3000 рублей», где следующие токены — конец, конец, «наушники» — и ни одна группа не дотягивает до σ. Дальше удлинять нельзя.
Раннее отсечение: если все соседи слева одинаковые
Перед тем как удлинять фразу вправо, алгоритм проверяет одну вещь: у всех ли вхождений один и тот же токен слева?
Если да, фраза заведомо не максимальная: её можно удлинить влево без потери поддержки. И эту более длинную версию алгоритм найдёт и так — из другого сида, который начинается на токен левее (он тоже частый, с той же поддержкой). Так что текущую ветку можно выбросить целиком, со всем, что из неё выросло бы.
На примере: сид «бесплатно при» — у всех трёх вхождений слева стоит «доставка». Ветка отсекается сразу; фраза целиком будет найдена из сида «доставка бесплатно».
Это дешёвая проверка (один проход по вхождениям), и она убирает большую часть дублирующей работы: без неё каждый длинный шаблон длины L был бы «выращен» почти L раз — из каждого своего внутреннего сида.
Проверка максимальности
Когда фраза больше не растёт вправо, нужно решить, попадает ли она в ответ. Два вопроса:
(А) Не является ли она куском уже найденной фразы? Наивно — сравнить со всеми найденными. Это дорого: найденных могут быть десятки тысяч. Поэтому ведётся инвертированный индекс «токен → найденные фразы, где он есть». Для кандидата берётся его самый редкий (по этому индексу) токен, и сравнивать нужно только с фразами из его списка. Если надфраза существует, она обязана содержать и этот токен, так что ничего не теряется, а список обычно очень короткий.
(Б) Не поглощает ли она что-то найденное раньше? Если новая фраза длиннее и содержит ранее найденную, старая удаляется из ответа и из индекса.
Это ровно та ситуация, что с «доставка бесплатно» в Части 2: у подфразы может быть больше поддержка, она может быть найдена раньше — и всё равно в итоге должна уступить место надфразе.
Маска покрытия
Последний механизм — глобальная битовая маска длиной в весь корпус: по одному флагу на каждую позицию. Когда фраза подтверждена как максимальная, все позиции всех её вхождений помечаются. Если у очередного сида все вхождения лежат в уже помеченных позициях, он пропускается, даже не начав расти.
Благодаря сортировке по Ψ это срабатывает часто: хребты находятся первыми, и большая часть последующих сидов — их внутренности.
У этой маски есть и второй смысл, который для исходной задачи важнее первого. К этому вернёмся в Части 6.
Весь алгоритм целиком
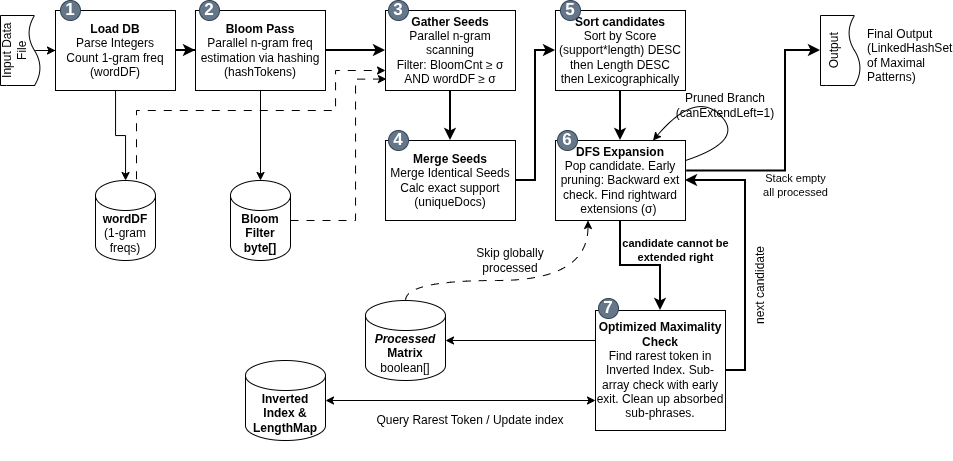
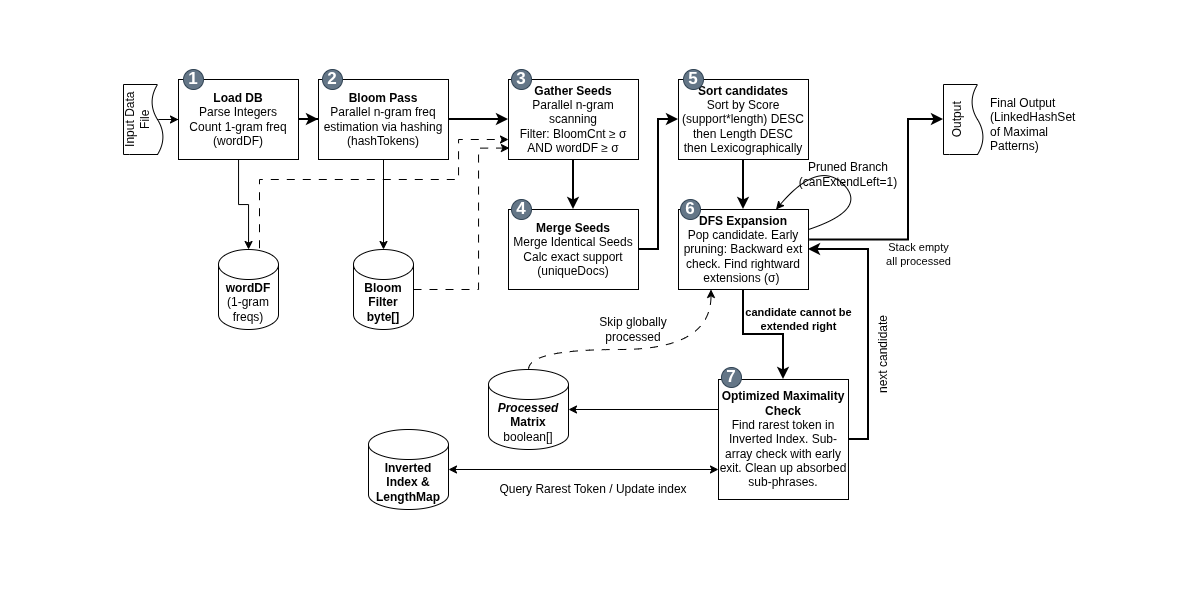
- Загрузить корпус как массивы
int, посчитать точныйdfкаждого слова. - Один линейный проход: все биграммы в счётный фильтр.
- Второй параллельный проход: оставить биграммы, прошедшие оба фильтра.
- Отсортировать вхождения, слить, посчитать точный
df, выбросить ложноположительные. - Отсортировать сиды по Ψ.
- Для каждого сида (если он не покрыт маской) — рост вглубь с ранним отсечением.
- Проверка максимальности через инвертированный индекс, обновление маски.
Сколько это стоит
Пусть W — число токенов в корпусе, M — размер фильтра, C — число вхождений выживших сидов, P — число найденных фраз.
Память: O(W + M + C + P). Корпус и маска — по O(W), фильтр — ровно M
байт (у нас до 512 МБ), сиды и индекс — пропорционально тому, что пережило
фильтр. Ключевое отличие от суффиксного массива: дорогие структуры строятся
не для всех W позиций, а только для C, а C — это несколько процентов от W.
Время: фильтр и сбор сидов — линейные проходы плюс сортировка сидов,
Θ(W + C log C). Фаза роста зависит от данных, и честной оценки худшего
случая для неё нет. Вместо этого — измерения в следующей части.
Если коротко про честность: в худшем случае BloomSpan не лучше точных методов, а иногда хуже. Он выигрывает на определённой «форме» данных — и именно эта форма типична для естественного текста.
Часть 5. Измерения
Как мерили
Все алгоритмы реализованы на Java и запускались на одной машине (Intel Core
Ultra 9, 64 ГБ RAM, OpenJDK 21, куча -Xmx40g). FHK и DFI — собственные
реализации (SA-IS + LCP по Касаи), BIDE+, VMSP и GST — из SPMF. Время —
от вызова алгоритма до результата, включая построение суффиксного массива
для FHK/DFI. Каждая конфигурация — 6 прогонов, первый выбрасывается как прогрев
JVM, в таблицах — медиана по остальным пяти.
Наборы данных:
| набор | что это | σ | мин. длина |
|---|---|---|---|
| Синтетика 1 | документы из случайно сгенерированных «слов» (не английских), в которые вставлены три фиксированные фразы | 3 | 3 |
| Синтетика 2 | 300 сильно перекрывающихся фраз убывающей длины — худший случай для BloomSpan | — | — |
| Gutenberg-8k | 8544 книги из Project Gutenberg, 535 млн токенов | 10 | 5 |
| Gutenberg-BookCorpus-Cleaned | до 50 000 книг, до 3,07 млрд токенов | 20 | 10 |
Как устроена Синтетика 1. «Слова» в ней — не слова английского языка, а
случайные строки: каждое — 8 случайных строчных латинских букв (qhzbtwla,
mfoxkrdu и т. п.). Генератор работает так:
- Сгенерировать N × 5000 строк по 8 случайных букв, отбрасывая повторы, так что все строки уникальны в пределах всего корпуса. Вариантов 26⁸ ≈ 2·10¹¹, так что настоящее английское слово среди них — редкая случайность, а осмысленных сочетаний нет вовсе.
- Нарезать их подряд по 5000 на документ. В итоге каждое «слово» фона
встречается ровно в одном документе,
df = 1: повторов в фоне нет по построению. - Взять из CSV три короткие английские фразы с заданной поддержкой («This is the first test sentence» — 3 документа, «Another unique phrase for testing» — 5, «A third sentence» — 4). Для каждой выбрать столько разных случайных документов и вставить фразу целиком в случайное место между словами фона.
Получается корпус, в котором заранее известен правильный ответ: ровно три
частые фразы и ничего больше. Это проверка корректности и стресс-тест на
«плоское» распределение без повторов, но на естественный текст такой корпус не
похож. Генератор лежит в репозитории
(corpus-miner/test-gen/generate_test_dataset.py).
Корректность проверялась напрямую: на Gutenberg-8k при всех размерах, где досчитывает хотя бы один точный бейзлайн (до 5000 книг), множества фраз у BloomSpan, FHK и DFI отсортированы и сравнены — они совпадают полностью. Ни пропусков, ни лишнего. Дальше 5000 книг сравнивать не с чем, и эквивалентность там не утверждается.
Большой корпус: где BloomSpan для этого и задумывался
Gutenberg-BookCorpus-Cleaned, σ = 20, минимальная длина 10. Время в секундах, память в МБ, OOM — не хватило 40 ГБ.
| книг | BloomSpan, с | BloomSpan, МБ | FHK, с | FHK, МБ | DFI, с | DFI, МБ | ускорение | фраз |
|---|---|---|---|---|---|---|---|---|
| 1 000 | 1,73 | 5 095 | 19,08 | 6 591 | 20,17 | 9 138 | 11,0× | 31 |
| 3 000 | 4,16 | 7 836 | 60,34 | 7 856 | 67,25 | 29 393 | 14,5× | 120 |
| 5 000 | 6,64 | 6 977 | 101,33 | 11 238 | OOM | OOM | 15,3× | 217 |
| 8 000 | 10,41 | 8 853 | 160,37 | 16 708 | OOM | OOM | 15,4× | 375 |
| 10 000 | 13,59 | 12 044 | 199,34 | 20 764 | OOM | OOM | 14,7× | 516 |
| 15 000 | 20,80 | 14 979 | 308,67 | 31 549 | OOM | OOM | 14,8× | 1 034 |
| 20 000 | 27,67 | 20 839 | — | — | OOM | OOM | — | 1 964 |
| 30 000 | 44,61 | 29 385 | 662,24 | 38 461 | OOM | OOM | 14,8× | 3 673 |
| 50 000 | 383,27 | 38 873 | OOM | OOM | OOM | OOM | — | — |
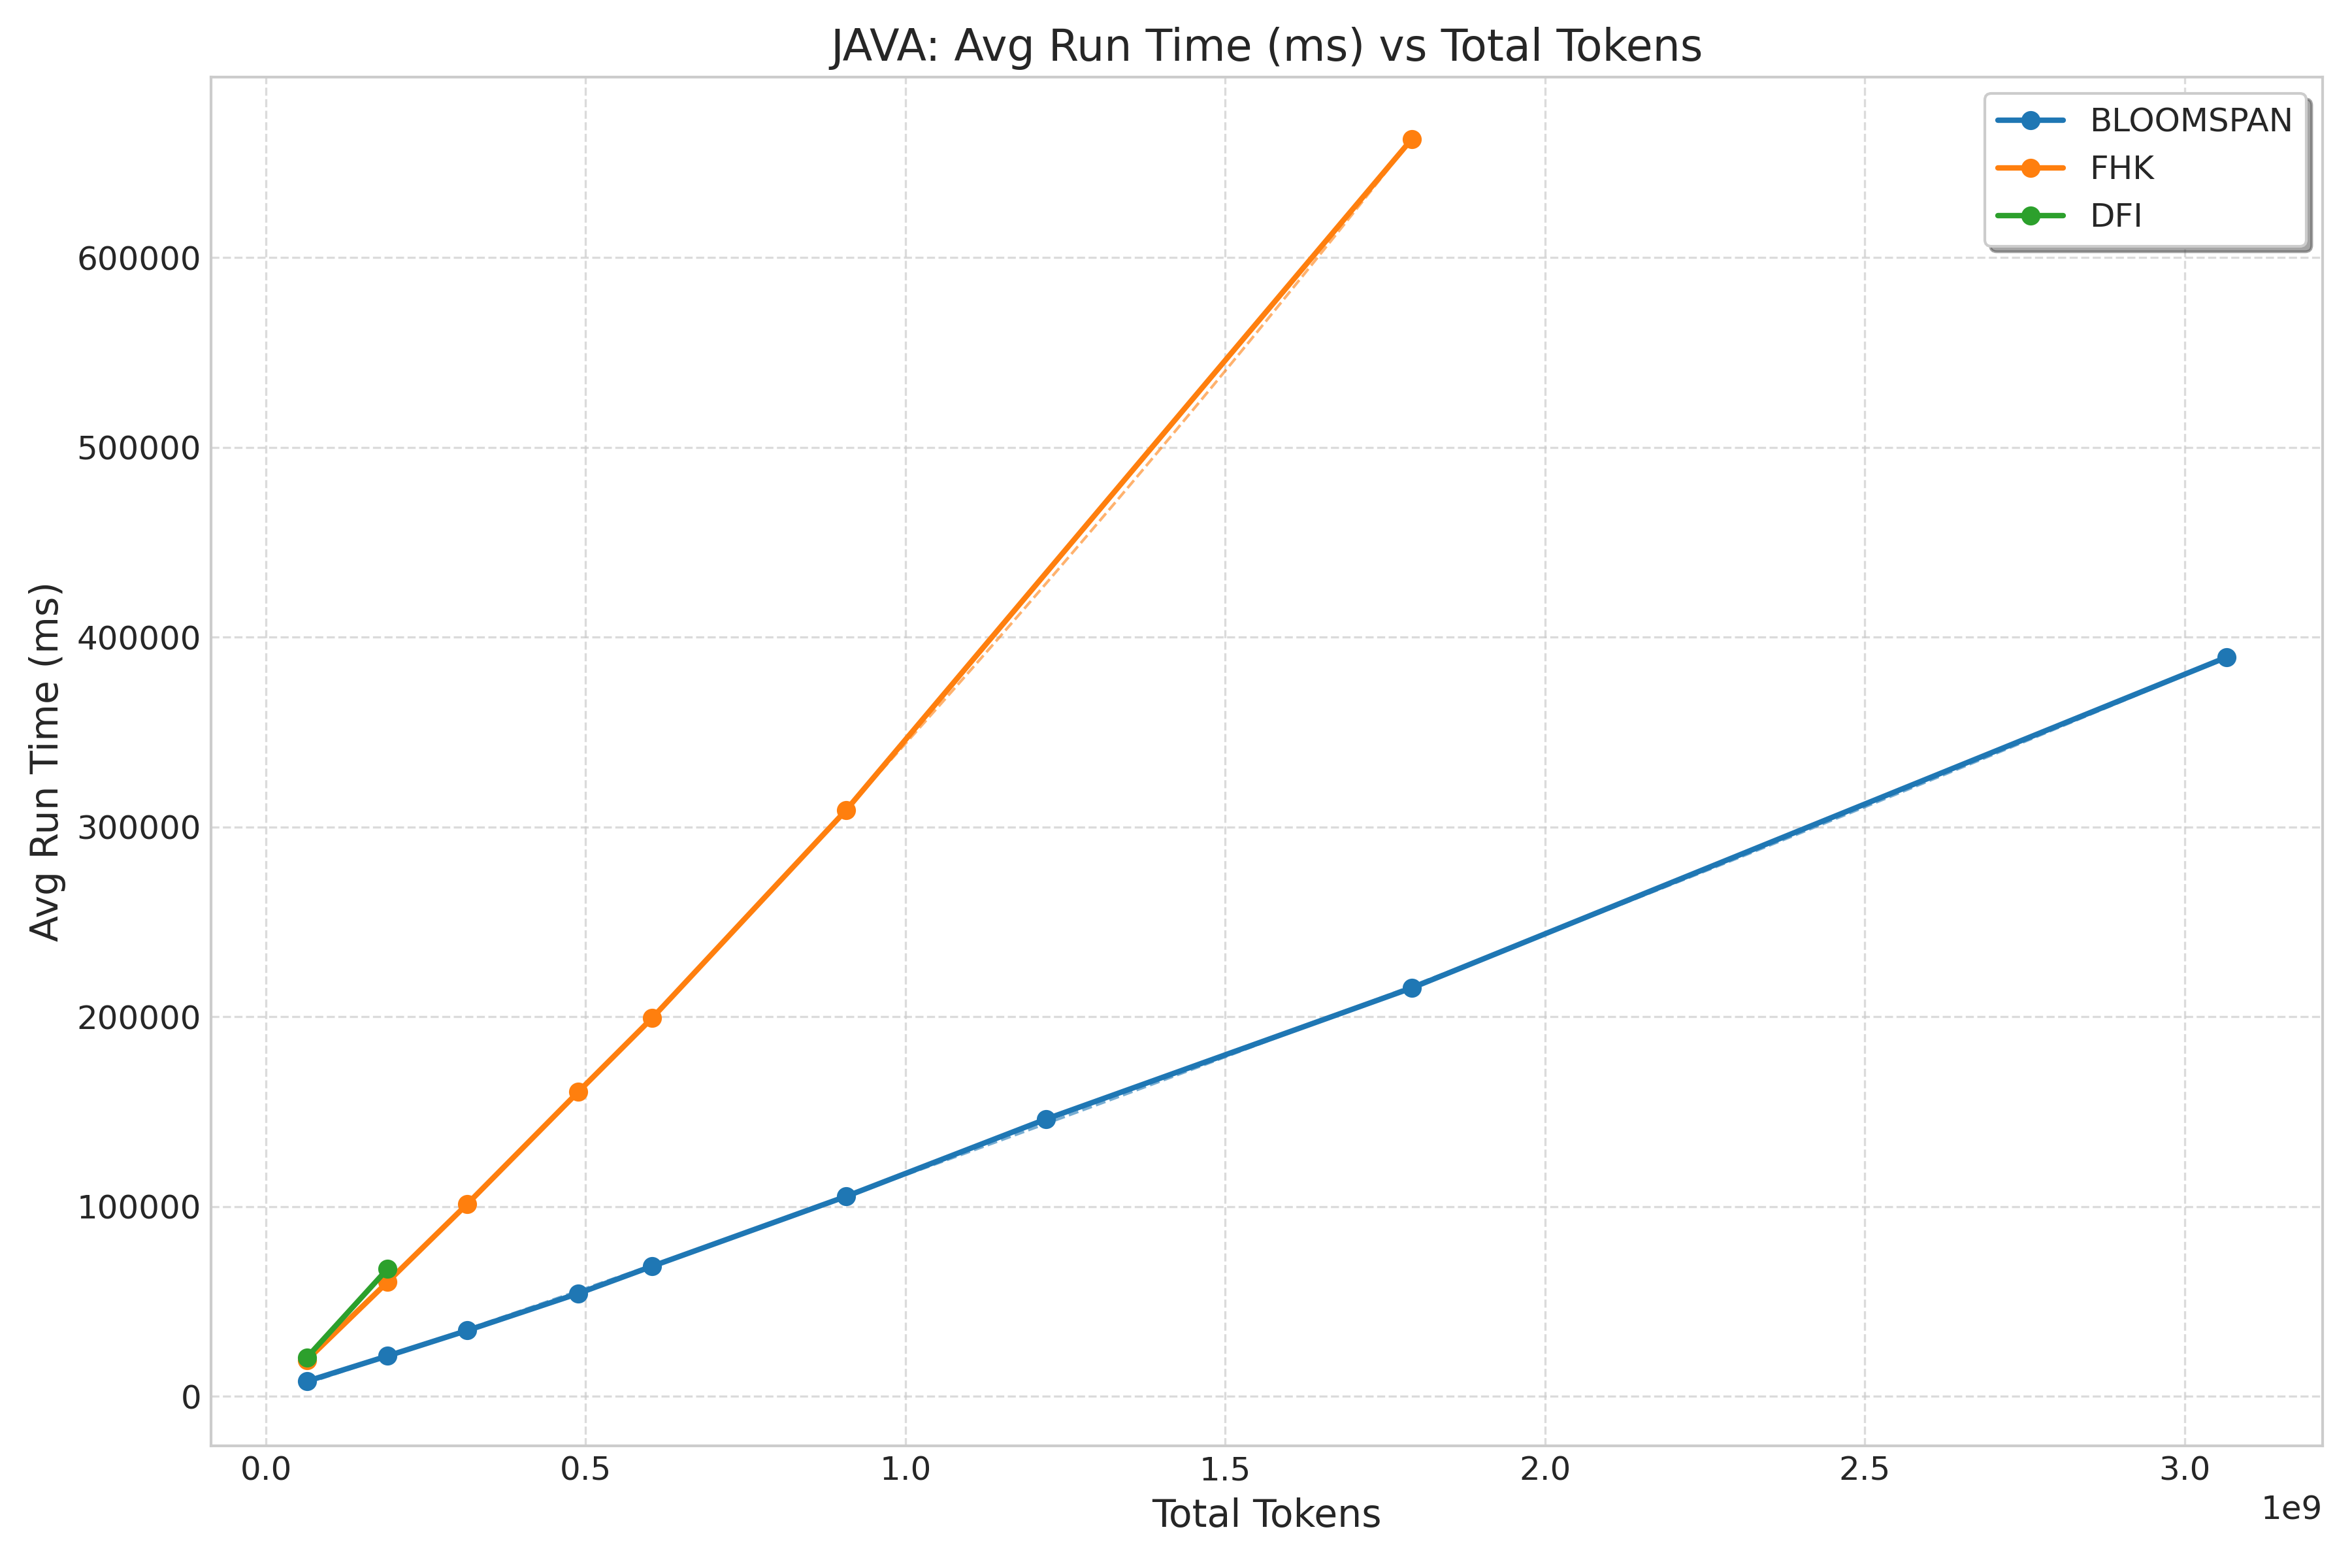
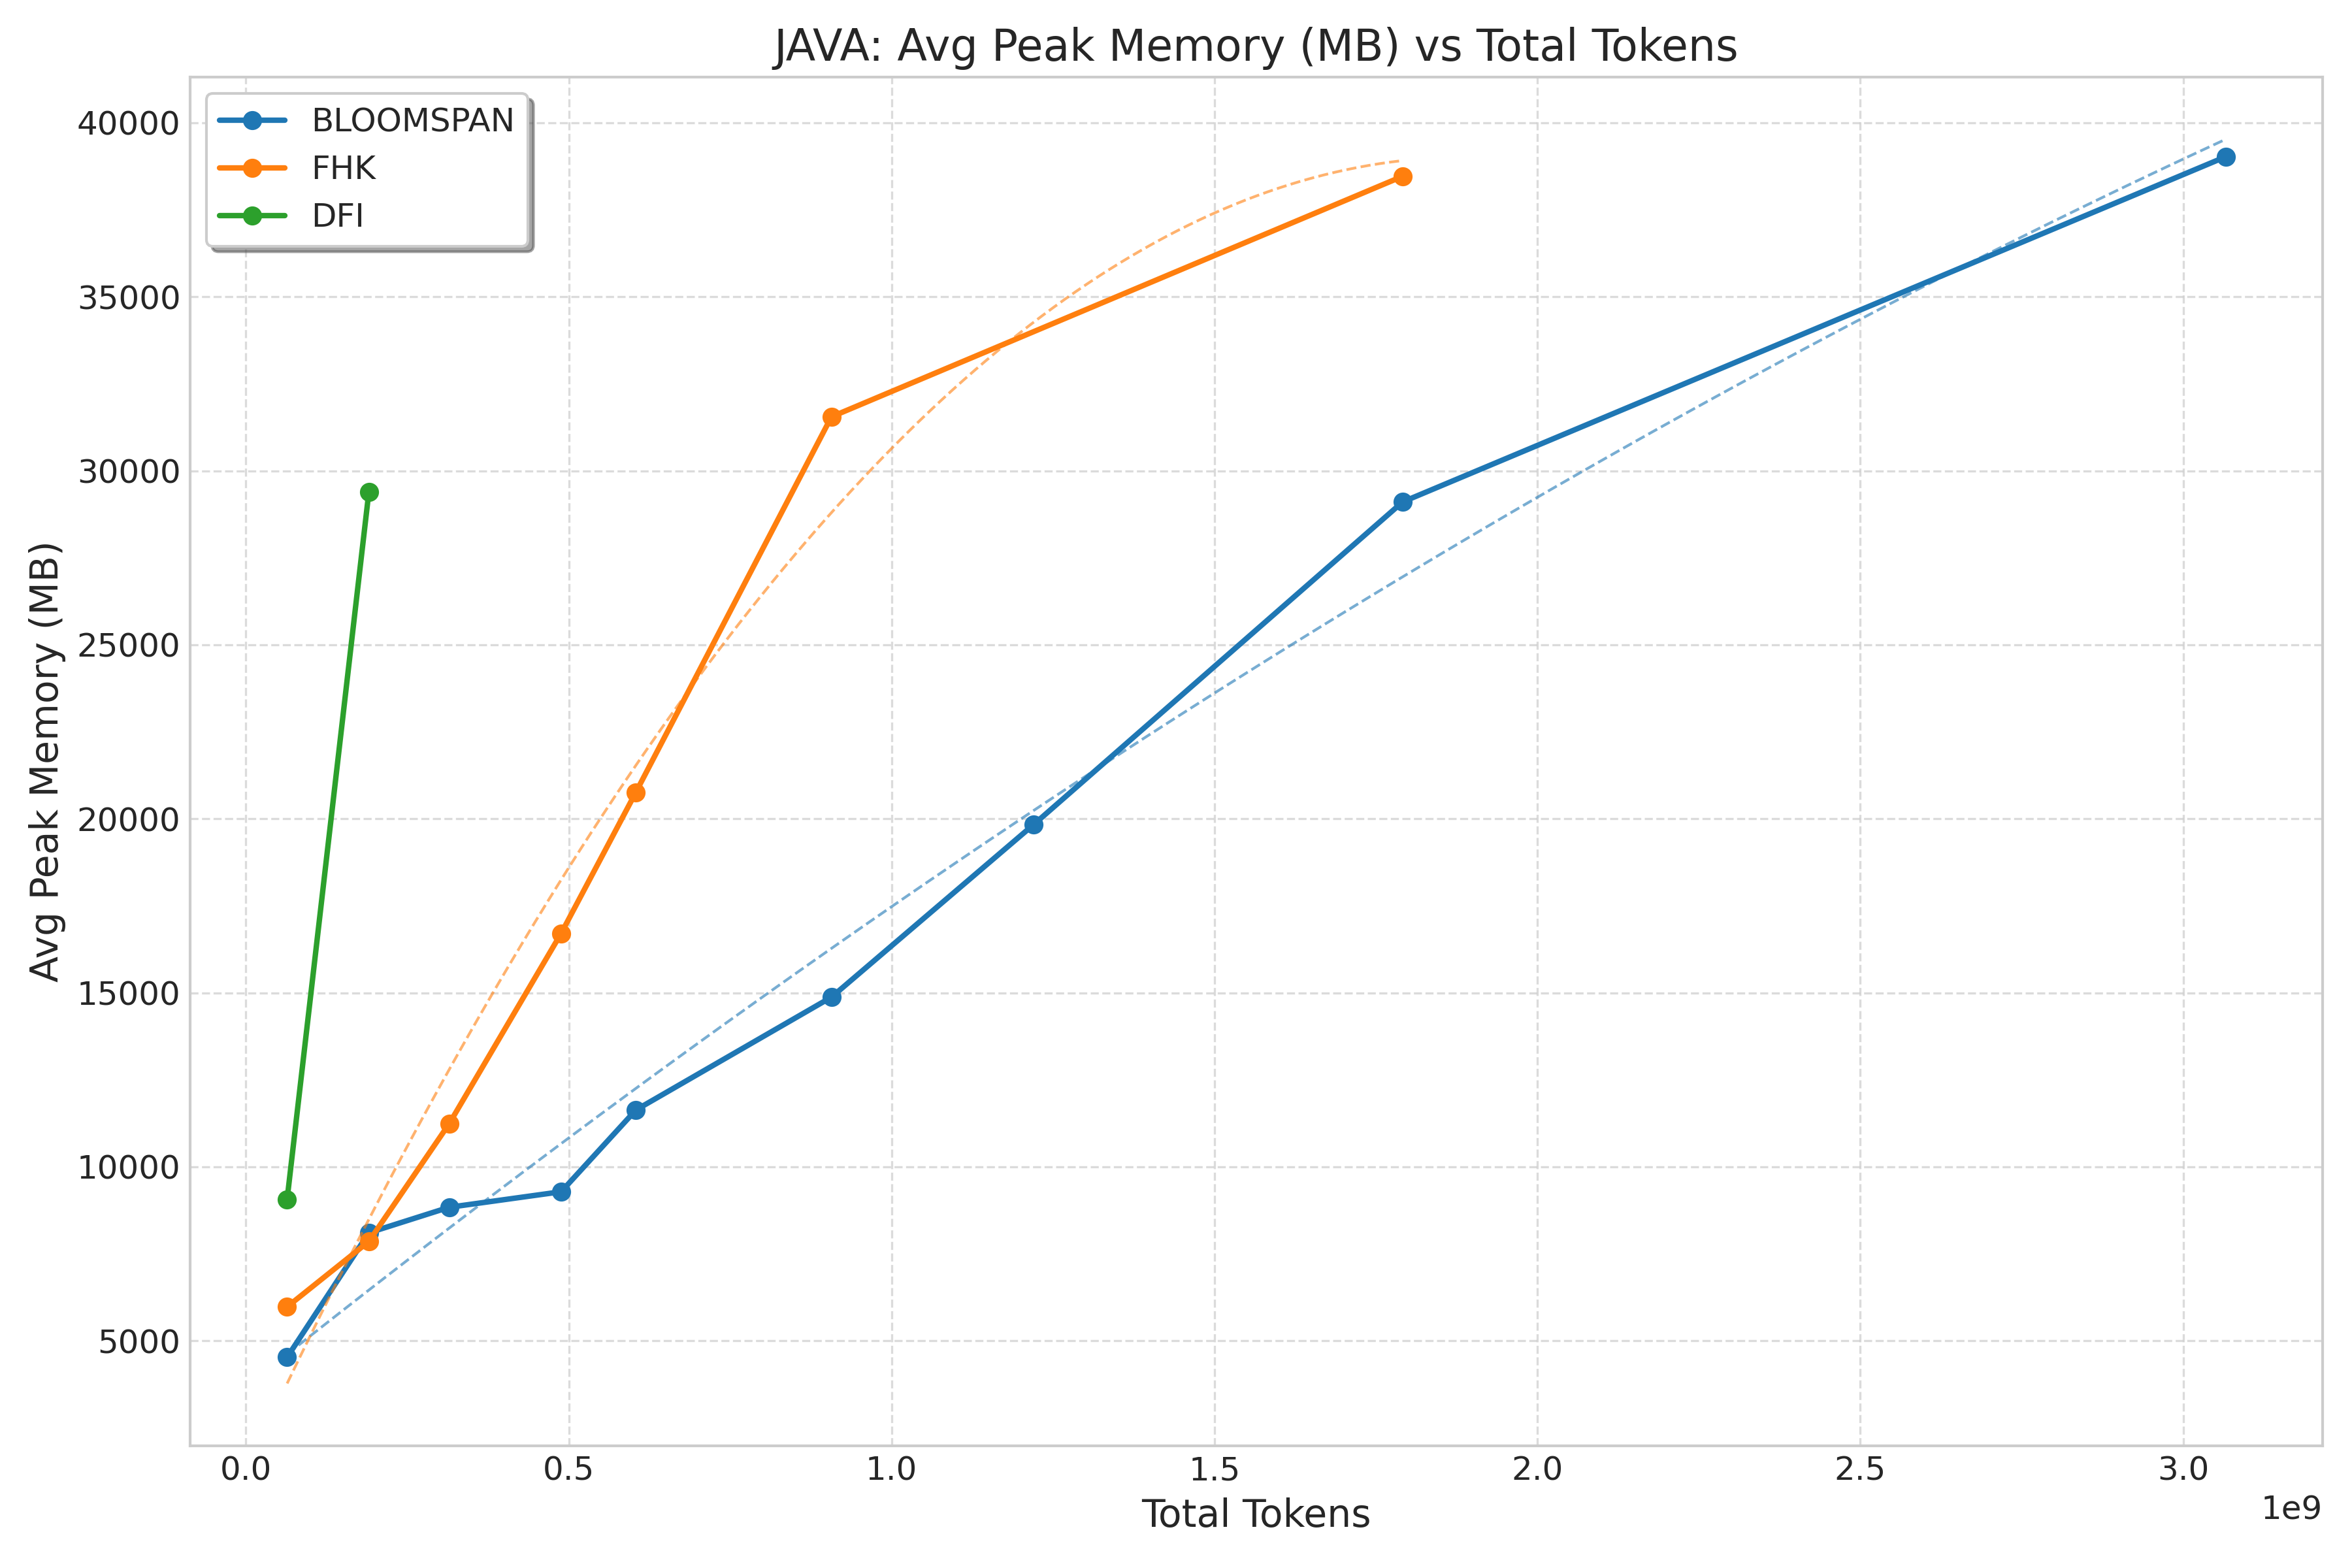
Что здесь видно:
- В 11–15 раз быстрее FHK во всех точках, где оба досчитали.
- Разрыв по памяти растёт с размером: на 15 000 книг — 15,0 ГБ против 31,5 ГБ.
- DFI со своей sparse-таблицей RMQ (
O(n log n)памяти) съедает 29 ГБ уже на 3000 книг и падает на 5000. FHK доходит до 30 000 книг (≈1,7 млрд токенов). BloomSpan — единственный, кто досчитал 50 000 книг (≈3,07 млрд токенов) в 40 ГБ. - Масштабирование почти линейное: до 30 000 книг стоимость обработки одного токена держится в диапазоне 0,021–0,027 мкс — при росте входа в 28 раз. Наклон в логарифмических координатах — 0,98.
- На 50 000 книг линейность ломается: стоимость прыгает до 0,125 мкс на токен. Причина — фраз становится много, и проверка максимальности, стоимость которой зависит от размера ответа, выходит на первый план. Наклон по всем девяти точкам — 1,24.
Где BloomSpan проигрывает
Было бы нечестно показывать только удобную таблицу. Есть три режима, где BloomSpan не лучший.
Синтетика 1 (редкие вставки в уникальный фон). До 10 000 документов все стрингологические алгоритмы масштабируются примерно линейно и идут близко. На 12 000 документов происходит перелом, и дальше FHK быстрее и экономнее: на 30 000 документов FHK — 15,3 с и 38,9 ГБ, BloomSpan — 38,2 с и упирается в лимит кучи.
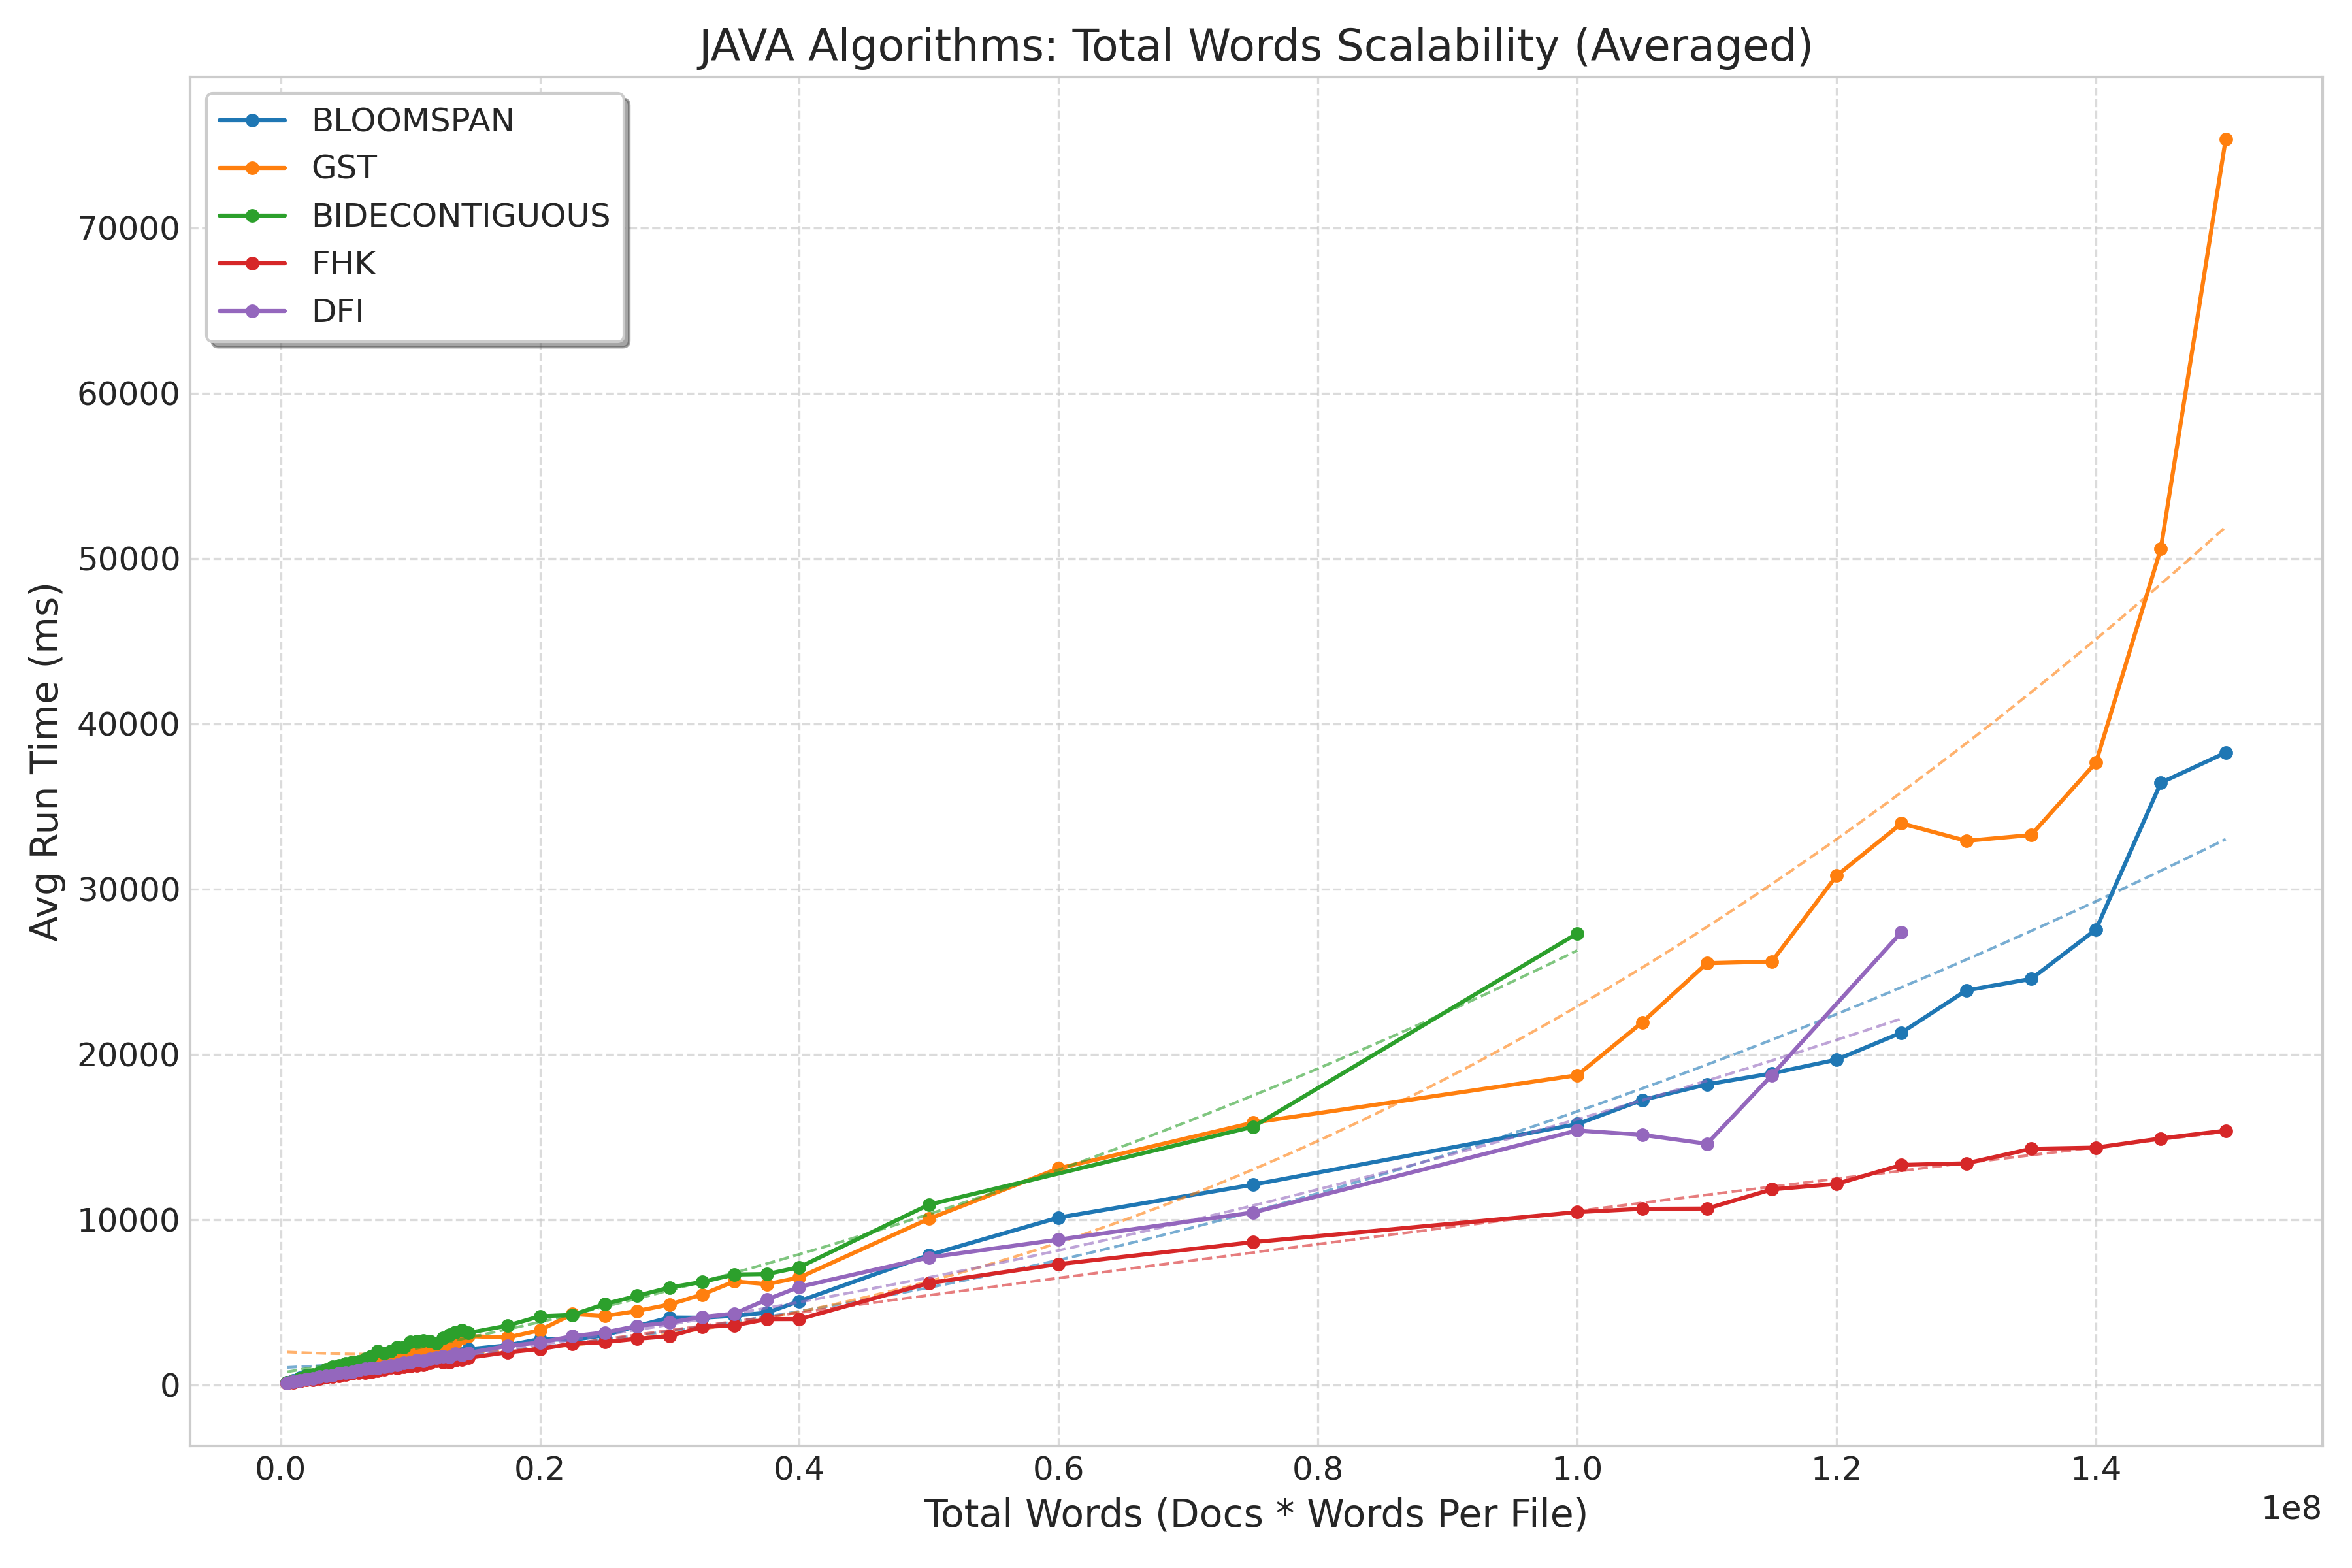
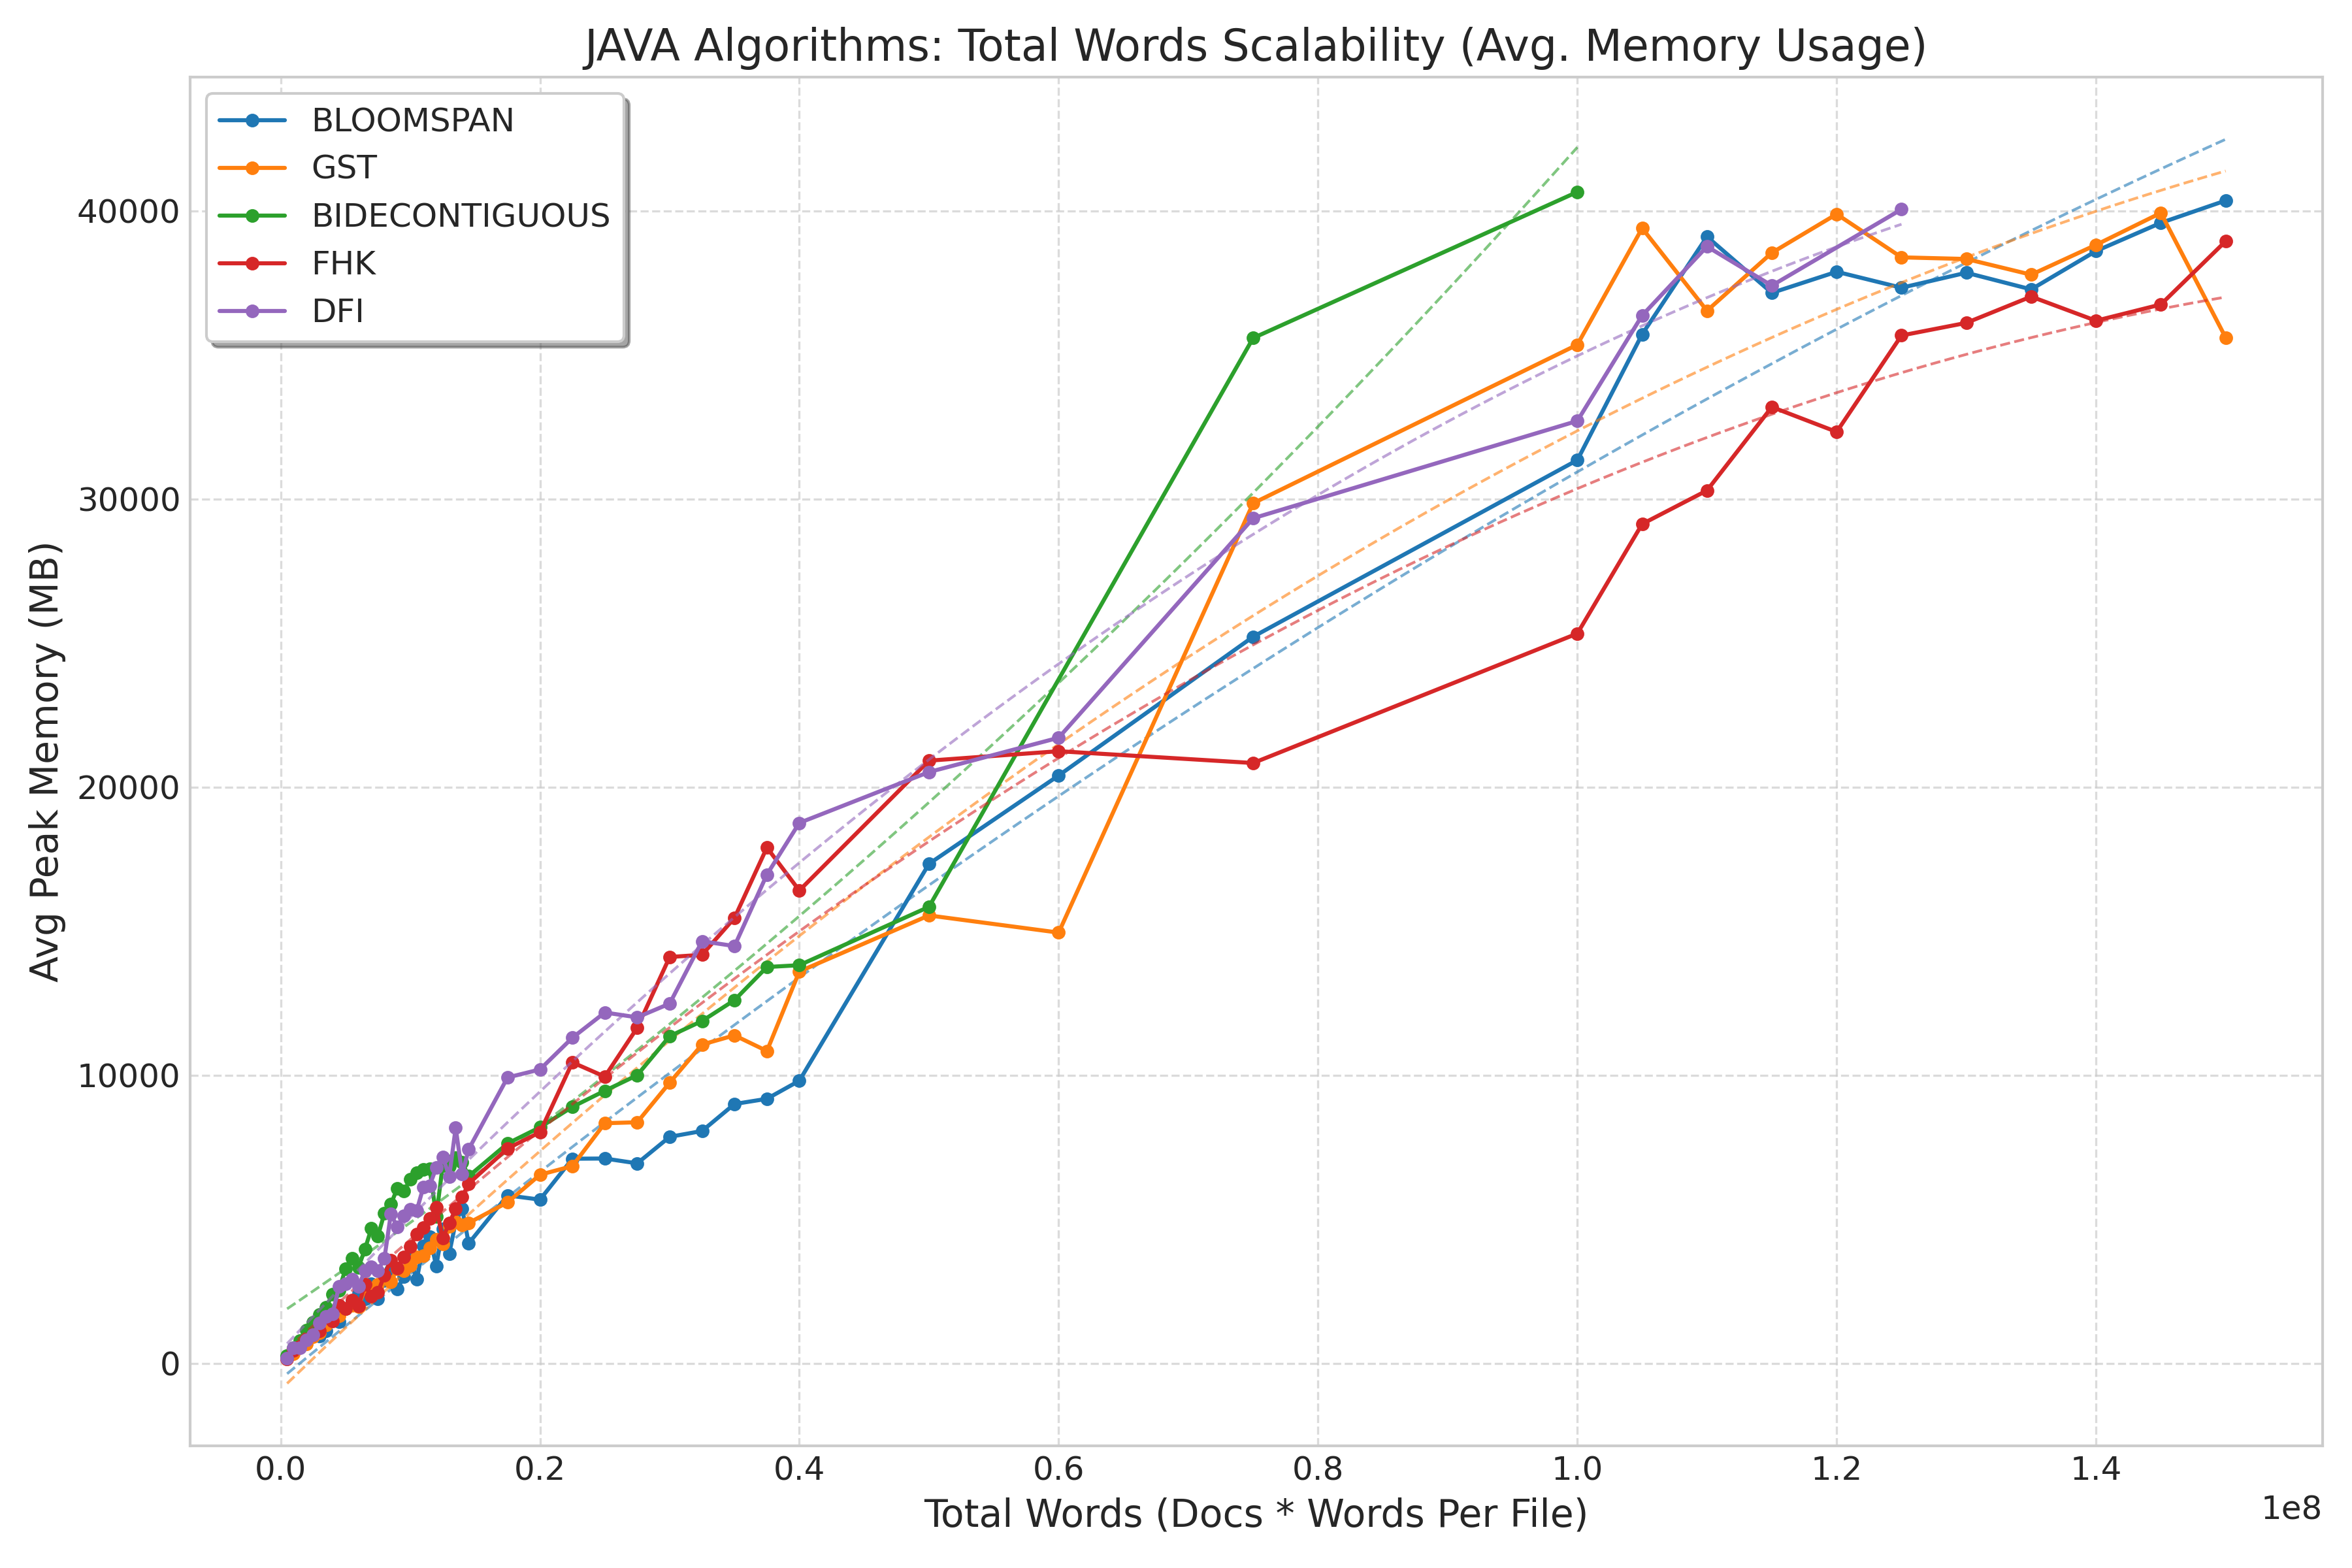
Синтетика 2 (плотные вложенные перекрытия). Специально построенный худший случай. FHK — 10,5 с, BloomSpan — 12,6 с, DFI — 14,9 с, BIDE+ (непрерывный, максимальный) — 16,8 с. Остальные SPMF-алгоритмы — OOM.
Gutenberg-8k при мягком пороге σ = 10. До 1000 книг BloomSpan на ≈20% быстрее FHK/DFI. Начиная с 3000 книг FHK/DFI на 10–20% быстрее: при мягком пороге частых фраз становится очень много (≈218 тысяч на 5000 книг), и опять доминирует проверка максимальности. На 8000 книг BloomSpan падает по памяти, а FHK и DFI досчитывают.
| книг | BloomSpan, мс | FHK, мс | DFI, мс | BIDE+, мс | GST, мс |
|---|---|---|---|---|---|
| 100 | 713 | 625 | 655 | 1 275 | 2 373 |
| 500 | 3 201 | 3 896 | 4 016 | 13 241 | 27 170 |
| 1 000 | 6 608 | 8 425 | 8 313 | OOM | OOM |
| 3 000 | 28 550 | 25 427 | 25 185 | OOM | OOM |
| 5 000 | 141 023 | 117 228 | 111 864 | OOM | OOM |
| 8 000 | OOM | 2 214 653 | 1 461 332 | OOM | OOM |
Почему так: «форма» корпуса
Разница объясняется не размером, а структурой данных. Удобная мера — число
фраз в разбиении Лемпеля–Зива, делённое на число токенов (c/n): грубо
говоря, насколько текст «сжимается» за счёт повторов.
- Синтетика 1: фон из уникальных слов,
c/n ≈ 1: каждый токен фона новый, поэтому каждая LZ-фраза состоит из одного токена (LZ78-разбор сгенерированного корпуса на 1000 документов даёт 0,99999). В фоне повторов нет вообще — по построению каждое «слово» встречается ровно один раз. Во всём корпусе повторяются только три вставленные фразы — несколько десятков токенов на десятки и сотни миллионов. Распределение плоское. Фильтр Блума отсекает фон, но FHK справляется с ним не хуже — и без отдельного прохода фильтра, так что фильтр здесь чистый оверхед. - Синтетика 2: почти каждая n-грамма из вставленного семейства частая. Фильтру нечего отсекать, вся работа — в проверке максимальности. А LCP-интервалы FHK как раз естественно «схлопывают» вложенные перекрытия.
- Естественный язык (Gutenberg):
c/n ≈ 0,27, около 7,94 бита на токен. Ципфовский хвост редких n-грамм, который фильтр срезает на 98%, и умеренное число не патологически вложенных повторов. Это та форма данных, под которую BloomSpan проектировался. Веб-корпус после краулера — тоже естественный текст, только с бо́льшим числом шаблонных повторов; по этой мерке стоит ожидать, что он ближе к Gutenberg, чем к любой из синтетик (сам яc/nдля веб-корпуса в этих экспериментах не измерял).
Практическое правило: строгий порог и большой корпус естественного текста — BloomSpan. Мягкий порог, много найденного или данные с плотными вложенными повторами — суффиксные методы.
Часть 6. Назад к индексу
От списка фраз к ответу «сколько мусора»
Список максимальных фраз — это ответ на вопрос «что повторяется». Но исходный вопрос был «сколько».
Здесь пригождается маска покрытия из Части 4. После окончания работы алгоритма в ней помечены ровно те позиции корпуса, которые принадлежат хотя бы одному вхождению какой-нибудь найденной фразы. Значит:
- доля помеченных позиций во всём корпусе — это доля текста индекса, состоящая из повторяющихся фрагментов;
- доля помеченных позиций в каждом документе — это «засорённость» конкретного документа. Распределение этой величины по документам сразу показывает, есть ли в индексе страницы, которые почти целиком состоят из шаблона (кандидаты на выброс), и какие сайты/разделы засорены сильнее других;
- сортировка фраз по
|P| × df(P)— это список «главных пожирателей индекса»: какой конкретно фрагмент занимает больше всего токенов.
То есть одна и та же структура, которая ускоряет алгоритм, после его окончания становится основной метрикой.
Как выбирать σ и минимальную длину
Два параметра работают как две ручки.
- σ отвечает за «насколько массово». Слишком низкий — в ответ попадают любые совпадения: цитаты, устойчивые выражения, одинаковые характеристики двух похожих товаров. Плюс, как видно из таблиц выше, растёт объём ответа и падает скорость. Слишком высокий — пропускаются шаблоны небольших сайтов. Разумно начинать с порога, привязанного к размеру типичного сайта в корпусе, а не к размеру корпуса.
- Минимальная длина отсекает устойчивые словосочетания. Фраза из 3–4 слов с высокой поддержкой — это чаще язык, чем шаблон. Дисклеймеры и футеры обычно длиннее 10 токенов.
На что обратить внимание
Точное совпадение — это ограничение. Шаблон с переменной частью («Показано 1–20 из 345 товаров», «© 2019», «© 2024», имя автора в подписи) распадается на несколько фраз между переменными вставками. Каждая из них по отдельности будет найдена, но как куски, а не как один шаблон. Поддержка «почти совпадающих» фраз (с допуском на редакционное расстояние) — следующий шаг, которого в BloomSpan пока нет.
Повторяется — не всегда значит мусор. В e-commerce одно и то же описание нередко стоит у всех цветов и размеров одного товара. В новостях — цитата из официального заявления во всех заметках по теме. В законодательстве — типовые формулировки, которые и есть контент. Алгоритм находит повторы; решение, какие из них шум, — доменное, и его нужно принимать, глядя на верх списка.
Токенизация теряет пунктуацию и регистр. Для поиска шаблонов это скорее плюс (мелкие различия в оформлении не мешают совпадению), но при обратном маппинге найденной фразы на исходный текст это нужно учитывать.
Итог
Задача «найти все длинные фрагменты, которые дословно повторяются во многих документах», выглядит как упражнение на хеш-таблицу. На миллиардах токенов она превращается в выбор между тремя плохими вариантами: хеш-таблица n-грамм не влезает в память, алгоритмы sequential pattern mining тонут в комбинаторике пропусков, а точные суффиксные методы строят дорогие структуры для каждого токена корпуса, даже для тех 98%, с которых никакая частая фраза не начинается.
BloomSpan опирается на то, что естественный текст подчиняется закону Ципфа:
- счётный фильтр Блума отсекает подавляющее большинство кандидатов за один линейный проход и, благодаря тому что ошибается только вверх, не теряет ни одной частой фразы;
- приоритет по Ψ = |P| × df(P) заставляет сначала находить самые массивные шаблоны;
- рост вглубь прямо по корпусу обходится без проецированных баз;
- раннее отсечение по левому соседу, инвертированный индекс по редкому токену и маска покрытия убирают дублирующую работу.
На 3 млрд токенов это в 11–15 раз быстрее FHK, вдвое экономнее по памяти и досчитывает там, где остальные не помещаются в 40 ГБ. На мягких порогах и синтетике с плотными повторами — проигрывает суффиксным методам, и это стоит знать заранее.
А для исходной задачи главное даже не скорость: после работы алгоритма маска покрытия даёт ровно тот ответ, ради которого всё затевалось, — какая доля индекса состоит из повторяющихся фрагментов и где именно они лежат.
Discussion
Powered by GitHub Discussions — sign in with a GitHub account to join the conversation.