
Частина 1. Задача
Звідки в індексі сміття
Типова ситуація: є пошуковий індекс, який наповнив краулер. Сотні тисяч або мільйони сторінок, з кожної HTML-розмітку вже викинуто, лишився текст. Цей текст індексують, за ним рахують релевантність, із нього вирізають сніпети, а останніми роками — ще й чанки для ембедингів і RAG.
Проблема в тому, що чимала частина цього тексту — не контент. Це:
- шаблон сайту: меню, хлібні крихти, футер, «© 2024 Компанія. Усі права захищено», посилання на соцмережі;
- службові блоки: банер про cookies, «Підпишіться на розсилку», «Ми використовуємо файли cookie, щоб…»;
- юридичні дисклеймери: «Інформація на сайті не є публічною офертою», «Ціни та наявність можуть відрізнятися», «Перед застосуванням проконсультуйтеся з фахівцем»;
- блоки, які CMS вставляє в тіло статті: «Читайте також», підписи до стандартних віджетів, однакові абзаци «про компанію» наприкінці кожної новини.
Частину цього відрізають DOM-евристики ще під час парсингу. Але тільки частину: дисклеймер, який редактор вставив у тіло кожної статті, з погляду розмітки нічим не відрізняється від контенту. А якщо індекс збирали давно, різними версіями парсера, з різних сайтів, — що саме в ньому лишилося, вже ніхто до ладу не знає.
Чим це шкодить
Ідеться не лише про місце на диску.
- Довжина документа. BM25 і майже всі його родичі нормалізують вагу терміна з урахуванням довжини документа. Сторінка з короткою карткою товару й довгим футером «карається» за футер.
- Сніпети. Якщо запит випадково збігся зі словами з дисклеймера, сніпет покаже дисклеймер.
- Ембединги й RAG. Чанк, що на третину складається з «Ми використовуємо файли cookie…», отримує вектор, який тягне його до інших таких самих чанків. Для векторного пошуку всі сторінки сайту починають трохи скидатися одна на одну.
- Дедуплікація та near-duplicate detection. Дві різні картки товару з однаковим на 80% шаблоном скидаються на майже дублікати.
- Навчання моделей. Для LLM це відома проблема: повторювані фрагменти
навчальних даних модель запам'ятовує дослівно. У корпусі
Colossal Clean Crawled Corpus — очищеному вивантаженні Common Crawl, на якому навчали
T5 та багато інших моделей, — знайшлося
англійське речення з 61 слова, повторене понад 60 тисяч разів.Lee, Katherine; Ippolito, Daphne; Nystrom, Andrew et al. — Deduplicating Training Data Makes Language Models Better (ACL 2022, arXiv:2107.06499). Точна дедуплікація підрядків через суфіксний масив — той самий клас задач, що й наша, лише з іншою метою.
Тож запитання, з якого все почалося, було просте: скільки в нашому індексі такого сміття і що це за фрагменти? Не «як його вирізати», а спершу просто побачити.
Чому не DOM-евристики
Класична відповідь на «як прибрати boilerplate» — аналіз окремої сторінки: щільність тексту в блоці, частка посилань, довжина абзаців, позиція в DOM. На цьому побудовано Boilerpipe, jusText, Trafilatura та їхні нащадки.
Цей підхід має два обмеження, принципові для нашої задачі:
- Він дивиться на одну сторінку. Він не знає, що абзац, який має вигляд звичайного тексту, дослівно повторюється ще на 40 тисячах сторінок.
- Йому потрібна розмітка. А в індексі розмітки вже немає — тільки текст.
Визначення, яке працює без розмітки й без знання про конкретний сайт, звучить так: сміття — це те, що повторюється. Не окремі слова (слово «і» теж повторюється), а довгі фрагменти, що дослівно трапляються в багатьох різних документах. Саме це ми й шукатимемо.
Ідея не нова: пошуковики шукали повторювані фрагменти в колекціях документів щонайменше із середини 2000-х.
Частина 2. Формулювання
Перш ніж обирати алгоритм, треба точно сказати, що ми шукаємо. Кожне слово у визначенні нижче потім позначиться на складності алгоритму.
Документи й токени
Документ — це послідовність токенів. Токенізація найпростіша: звести до
нижнього регістру, розбити на кожному символі, що не є літерою чи цифрою. Пунктуація
зникає, «Усі права захищено.» і «усі права захищено» — одне й те саме. Кожен
токен замінюється цілим числом зі словника, тож далі ми працюємо не з
рядками, а з масивами int.
Фраза
Фраза — це неперервний шматок документа: токени з i-го до (i+k−1)-го, без пропусків. Це важливо: «безкоштовна доставка» й «безкоштовна … доставка» — різні речі, друге нас не цікавить.
Підтримка: у скількох документах, а не скільки разів
Підтримка фрази — кількість документів, у яких вона трапляється хоча б
раз. Позначмо її df(P), як document frequency у пошуку.
Чому не загальна кількість входжень? Бо фраза, повторена 500 разів усередині одного довгого документа (приспів пісні, однаковий рядок таблиці), — це не шаблон. Шаблон — це те, що проходить крізь документи.
Поріг σ (сигма) — мінімальна підтримка, починаючи з якої фраза нас
цікавить. Фразу з df ≥ σ називають частою.
Максимальність
Якщо фраза «безкоштовна доставка для замовлень від 1000 гривень» трапляється в 1000 документах, то й кожен її шматок — «безкоштовна доставка», «для замовлень від», «1000 гривень» — трапляється щонайменше в 1000. Перелічувати їх усі безглуздо: замість однієї знахідки ми отримаємо десятки її обрізків.
Тому шукаємо лише максимальні часті фрази: часті, які не можна подовжити ні ліворуч, ні праворуч так, щоб фраза лишилася частою.
У літературі це називають MCFP — Maximal Contiguous Frequent Phrase. Задача: дано корпус і поріг σ, знайти всі MCFP. Зазвичай додають ще мінімальну довжину: фрази, коротші за 5–10 токенів, нас не цікавлять, навіть якщо вони часті.
Іграшковий приклад, який пройде крізь усю статтю
Чотири «сторінки» інтернет-магазину, σ = 3:
Д1: новий ноутбук acer swift безкоштовна доставка для замовлень від 1000 гривень
Д2: чохол для iphone 15 безкоштовна доставка для замовлень від 1000 гривень
Д3: безкоштовна доставка для замовлень від 1000 гривень навушники sony
Д4: навушники sony wh 1000 безкоштовна доставка
Відповідь:
- «безкоштовна доставка для замовлень від 1000 гривень» —
df = 3(Д1, Д2, Д3). Часта. Ліворуч не подовжується (перед нею «swift», «15» і початок документа), праворуч — теж. Максимальна. - «безкоштовна доставка» —
df = 4. Часта, і навіть частіша. Але не максимальна: її подовження «безкоштовна доставка для» теж часте (df = 3 ≥ σ). - «навушники sony» —
df = 2 < 3. Не часта.
Зверніть увагу на другий пункт: у підфрази підтримка вища, ніж у максимальної фрази, і все одно до відповіді вона не потрапляє. Максимальність — не «найчастіша», а «найдовша з усе ще частих». Це знадобиться, коли будемо перевіряти максимальність в алгоритмі.
Частина 3. Від простого до складного
Крок 0. Порахувати n-грами
Найочевидніше рішення: обрати довжину n, пройти вікном по всіх документах, скласти всі n-грами в хеш-таблицю «n-грама → множина документів», відфільтрувати за σ.
Для n = 2 на нашому прикладі:
безкоштовна доставка {Д1, Д2, Д3, Д4}   df=4  ✓
доставка для         {Д1, Д2, Д3}       df=3  ✓
для замовлень        {Д1, Д2, Д3}       df=3  ✓
замовлень від        {Д1, Д2, Д3}       df=3  ✓
від 1000             {Д1, Д2, Д3}       df=3  ✓
1000 гривень         {Д1, Д2, Д3}       df=3  ✓
навушники sony       {Д3, Д4}           df=2
новий ноутбук        {Д1}               df=1
... ще з півтора десятка з df=1
Працює. Проблем три, і всі три ведуть до наступних кроків.
Проблема 1: яке n? Шаблонна фраза може мати довжину 6 токенів, а може й 300 (цілий абзац дисклеймера). Фіксоване n або ріже довгі фрази на шматки, або пропускає короткі.
Проблема 2: пам'ять. Кількість різних n-грам у природній мові зростає майже так само, як кількість токенів: починаючи з n = 3–4, переважна більшість n-грам унікальні. На корпусі в 3 млрд токенів це мільярди ключів у хеш-таблиці, і в кожного — список документів. Жодної пам'яті не вистачить, і майже вся вона піде на n-грами, які трапилися один раз і нам точно не потрібні.
Проблема 3: обрізки. Навіть якщо перебрати всі n, відповідь складатиметься з вкладених один в одного шматків тієї самої фрази. Ось реальний фрагмент виводу мого раннього прототипу без перевірки максимальності (корпус — вихідний код Java, тому «шаблон» тут — це анотації та імпорти):
df=2985  len=9  import org springframework beans factory annotation required public class
df=2985  len=8         org springframework beans factory annotation required public class
df=2985  len=7             springframework beans factory annotation required public class
df=2985  len=6                             beans factory annotation required public class
df=2985  len=5                                   factory annotation required public class
П'ять рядків, одна знахідка. У тому прогоні таких рядків було 77 тисяч.
Крок 1. Apriori: рости від частого до частого
Ключове спостереження, на якому тримається вся галузь: підтримка
антимонотонна. Якщо фраза P трапляється в документі, то й будь-який її шматок там
трапляється. Отже, df(шматок) ≥ df(P). Наслідок: якщо коротка фраза
не часта, то жодна фраза, яка її містить, теж не часта.
Це дає стратегію: почати з частих коротких фраз і подовжувати лише їх. Нечасте подовження відкидається разом з усім, що з нього могло б вирости. Це ідея Apriori/GSP — класики data mining середини 90-х.
На прикладі: з усіх біграм частих шість. «навушники sony» відкинуто — отже, і
«навушники sony wh», і все далі можна не розглядати. А «безкоштовна доставка»
подовжується до «безкоштовна доставка для» (df=3), та — до «безкоштовна доставка для
замовлень» (df=3), і так аж до «… 1000 гривень». Далі подовжувати нічим: праворуч у Д1 і
Д2 кінець документа, у Д3 — «навушники», df = 1.
Проблему 1 (яке n) розв'язано: довжина вже не параметр, фраза росте сама, доки лишається частою. Проблему 3 (обрізки) розв'язує перевірка максимальності на виході. А проблему 2 (пам'ять) — ні: на першому рівні однаково треба порахувати всі біграми, щоб дізнатися, які з них часті.
Крок 2. Sequential pattern mining: надто загальний інструмент
Для задачі «знайти часті послідовності» існує ціла родина готових алгоритмів: GSP, PrefixSpan, SPADE, BIDE+, VMSP, CloSpan. Багато з них зібрано в бібліотеці SPMF, їх легко взяти й запустити.
Заковика в тому, що вони розв'язують іншу, загальнішу задачу. У класичному
sequential pattern mining між елементами патерну допускаються пропуски:
патерн ⟨A, B, C⟩ вважається присутнім у документі, якщо там є
A … будь-що … B … будь-що … C. Для аналізу купівельних кошиків це
саме те, що потрібно. Для тексту — комбінаторний вибух: у довгому документі майже
будь-які три часті слова знайдуться в потрібному порядку десь на відстані
кількох тисяч токенів одне від одного. Кількість кандидатів зростає на порядки, і
майже всі вони безглузді.
Можна обмежити ці алгоритми неперервними розширеннями (у SPMF є, наприклад, варіант BIDE+ «contiguous»), але їхні внутрішні структури даних — проєційовані бази, списки позицій для кожного префікса — спроєктовано для загального випадку, і пам'яті вони споживають відповідно. У наших бенчмарках усі SPMF-алгоритми (BIDE+, VMSP, GST) впали через брак пам'яті вже на 1000 книжках — це близько 60 мільйонів токенів за купи в 40 ГБ. До мільярдів їм далеко.
Висновок: потрібен інструмент, який від самого початку знає, що пропусків немає.
Крок 3. Суфіксний масив: точна відповідь зі стрингології
Задача «знайти всі повторювані підрядки» — класика стрингології, і вона має класичне розв'язання.
Суфіксний масив — це всі суфікси тексту, відсортовані лексикографічно (зберігаються, звісно, не самі суфікси, а їхні початкові позиції). LCP-масив поруч із ним зберігає для кожної пари сусідніх суфіксів довжину їхнього спільного префікса.
Чому це розв'язує задачу: усі входження будь-якого підрядка у відсортованому масиві суфіксів лежать поспіль — це суфікси, які з нього починаються. А LCP-масив показує, де такі блоки починаються й закінчуються.
Невеликий приклад. Склеїмо три документи в один текст із роздільниками (літери — це токени):
Д1: A B C D Д2: X A B C Д3: A B C YВідсортовані суфікси (показую лише початок кожного) і LCP із попереднім:
  #   суфікс           док   LCP
  1   A B C $          Д2    —
  2   A B C D $        Д1    3
  3   A B C Y $        Д3    3
  4   B C $            Д2    0
  5   B C D $          Д1    2
  6   B C Y $          Д3    2
  7   C $              Д2    0
  ...
Рядки 1–3 утворюють LCP-інтервал: три сусідні суфікси зі спільним префіксом
довжиною ≥ 3, тобто «A B C». Суфікси з трьох різних документів — df = 3.
Рядки 4–6 — інтервал для «B C», теж df = 3, але «B C» міститься в «A B C» з
тією самою підтримкою, тож вона не максимальна.
Обхід усіх LCP-інтервалів знизу вгору (за допомогою стека) перелічує всі
повторювані підрядки, а підрахунок різних документів у кожному інтервалі дає
df. На цьому побудовано алгоритм Фішера–Хойна–Крамера (FHK) — він розв'язує задачу
за час, асимптотично оптимальний щодо розміру входу. Є й альтернатива з
обходом згори вниз і раннім відсіканням піддерев — DFI (Deferred Frequency
Index).
Це точний і красивий метод. Його проблема — константи. Суфіксний масив і LCP-масив — це по одному цілому числу на кожен токен корпусу, плюс сам текст, плюс масив «якому документу належить позиція», плюс допоміжні структури обходу. І все це будується для всього корпусу, зокрема для мільярдів позицій, з яких не починається жодна часта фраза. У наших вимірюваннях FHK доходить до 30 тисяч книжок (≈1,7 млрд токенів), а далі падає через брак пам'яті, а DFI зі своєю sparse-таблицею для RMQ — уже на 5 тисячах.
Стрингологія відповідає на запитання «де повторюється будь-який підрядок». Нам потрібна відповідь на вужче запитання: «де повторюється частий підрядок». А більшість підрядків природної мови — не часті.
Частина 4. BloomSpan
Головна ідея
Погляньмо на корпус крізь призму закону Ципфа. Розподіл n-грам у природній мові — довгий хвіст: переважна більшість трапляються один-два рази. Це стосується й біграм. На корпусі Gutenberg за σ = 20 з усіх біграм поріг проходять близько 2%.
Звідси ідея: спершу дешево викинути 98% корпусу, а дорогі структури будувати лише для решти 2%.
«Дешево» тут означає — не зберігаючи самих n-грам. Для цього є ймовірнісні структури даних.
Фільтр Блума з лічильниками
Звичайний фільтр Блума відповідає на запитання «чи траплявся цей елемент?» — бітовий масив, елемент хешується, відповідні біти встановлюються в 1. Він може помилитися в один бік: сказати «так» про елемент, якого не було (колізія хешів). Але ніколи не скаже «ні» про елемент, який був.
Лічильний фільтр Блума (Counting Bloom Filter) замість бітів зберігає невеликі лічильники. Додати елемент — збільшити лічильник у комірці, куди він хешується. Запитати «скільки разів траплявся» — прочитати лічильник.
Властивість та сама: помилка лише вгору. Якщо в комірку потрапили дві різні біграми, лічильник покаже суму — тобто більше, ніж у кожної. Менше, ніж насправді, він не покаже ніколи.
Іграшкова ілюстрація: масив із 8 лічильників, біграми хешуються в комірки.
комірка:    0   1   2   3   4   5   6   7
лічильник:  3   1   4   0   3   2   3   5
                    ↑                   ↑
        «безкоштовна доставка»    сюди потрапили три біграми:
              (4 рази)            «1000 гривень»  (3 рази)
                                  «новий ноутбук» (1 раз)
                                  «sony wh»       (1 раз)
«новий ноутбук» трапилася один раз, але через колізію фільтр каже «5». На етапі фільтрації вона пройде як кандидат — і її буде відсіяно пізніше, під час точного підрахунку. Зворотна ситуація — часта біграма, якій фільтр нарахував менше за σ, — неможлива.
Чому фільтр не губить жодної частої фрази
Це центральна властивість алгоритму, і доводиться вона в три рядки.
Фільтр рахує не документну частоту df, а загальну кількість входжень c — так
простіше: не треба пам'ятати, в якому документі ми вже збільшували лічильник. Нехай
ĉ(S) — те, що показує фільтр для n-грами S.
- Колізії лише додають:
ĉ(S) ≥ c(S). - Кожен документ, де є S, дає щонайменше одне входження:
c(S) ≥ df(S). - Отже,
ĉ(S) ≥ df(S), і якщоdf(S) ≥ σ, то фільтр гарантовано покаже≥ σ.
Таким чином, усі справді часті n-грами проходять фільтр. Лишилося переконатися, що з них можна виростити всі часті довгі фрази. Це випливає з антимонотонності: будь-яка часта фраза довжиною ≥ n містить n-граму, яка теж часта (з не меншою підтримкою). Отже, кожна часта фраза має щонайменше один «сід», що пережив фільтр.
Хибнонегативних результатів на етапі відбору немає. Хибнопозитивні є, і їх чимало: фільтр рахує входження, а не документи, тому біграма, яка 20 разів трапилася в одній книжці, теж пройде за σ = 20. Їх відсіє наступний, уже точний крок.
Ось як це має вигляд у коді (Java-реалізація, скорочено):
// Розмір: 8 байтів на токен корпусу, але не більше ніж 512 МБ
byte[] filter = new byte[filterSize];

// Один лінійний прохід: кожна біграма збільшує свій лічильник
for (int p = 0; p <= seq.length - n; p++) {
    int idx = (int) (Math.abs(hashTokens(seq, p, n)) % filter.length);
    int c = filter[idx] & 0xFF;
    if (c < 255) filter[idx] = (byte) (c + 1);   // насичення на 255
}
Кілька інженерних деталей. Хеш — FNV-1a над послідовністю цілочисельних токенів. Функція одна,
тож формально це один рядок Count-Min Sketch, а не «справжній»
багатохешевий фільтр Блума; на гарантію це не впливає, впливає лише на частку
хибнопозитивних. Лічильник займає один байт і насичується на 255; тому
лічильник порівнюють із min(σ, 255), і гарантія «помилка лише вгору» зберігається.
Другий фільтр — за окремими словами
Крім фільтра за біграмами, є другий, зовсім дешевий: точна документна частота кожного окремого токена (їх у словнику мільйони, а не мільярди, тож це просто хеш-таблиця). Якщо хоча б одне слово біграми трапляється менш ніж у σ документах, біграма не може бути частою — та сама антимонотонність.
Кандидат-сід проходить, лише якщо пройдено обидва фільтри. На корпусі Gutenberg-BookCorpus за σ = 20 разом вони відсікають 98% усіх біграм.
Злиття сідів і точна підтримка
Для 2%, що вижили, ми нарешті можемо дозволити собі точність. Кожне входження
кандидата записується як (біграма, документ, позиція); біграма з двох
32-бітних токенів пакується в один long. Масив паралельно сортується, і
однакові біграми опиняються поруч. Один прохід по ньому — і для кожної
біграми відомі точний список входжень і точний df. Усі біграми, у яких
df < σ, викидаються: це хибнопозитивні результати фільтра.
На цьому етапі ми маємо сіди: часті біграми зі списками всіх їхніх входжень.
Порядок обробки: спершу найважче
Сіди сортуються за оцінкою
Ψ(P) = |P| × df(P)— довжина, помножена на підтримку, тобто приблизно «скільки токенів корпусу покриває ця фраза». За рівності — довша раніше, потім лексикографічно (щоб результат був детермінованим).
Навіщо: першими обробляються сіди, з яких виростуть наймасивніші шаблони — «хребти» корпусу. Коли такий хребет знайдено, всі його шматочки, які трапляться пізніше, швидко розпізнаються як уже покриті.
Ріст у глибину безпосередньо в корпусі
Кожен сід росте праворуч пошуком у глибину зі стеком. Для поточної фрази дивимося на токен, що йде після кожного її входження, і групуємо входження за цим токеном. Кожна група, яка покриває ≥ σ документів, — це часте подовження, його кладуть у стек.
Важливо, де це відбувається: просто у вихідному масиві токенів. Жодних
проєційованих баз, жодних копій суфіксів: входження — це пара
(документ, позиція), а «наступний токен» — це просто doc[pos + len].
На прикладі: сід «безкоштовна доставка» (входження в Д1, Д2, Д3, Д4). Наступні токени: Д1 → «для», Д2 → «для», Д3 → «для», Д4 → кінець документа. Група «для» покриває 3 документи ≥ σ → у стек кладеться «безкоштовна доставка для» з трьома входженнями. І так далі аж до «… 1000 гривень», де наступні токени — кінець, кінець, «навушники» — і жодна група не дотягує до σ. Далі подовжувати не можна.
Раннє відсікання: якщо всі сусіди ліворуч однакові
Перш ніж подовжувати фразу праворуч, алгоритм перевіряє одну річ: чи в усіх входжень той самий токен ліворуч?
Якщо так, фраза гарантовано не максимальна: її можна подовжити ліворуч без втрати підтримки. І цю довшу версію алгоритм і так знайде — з іншого сіда, який починається на токен лівіше (він теж частий, з тією самою підтримкою). Тож поточну гілку можна викинути цілком, з усім, що з неї виросло б.
На прикладі: сід «доставка для» — в усіх трьох входженнях ліворуч стоїть «безкоштовна». Гілку відсікають одразу; фразу цілком буде знайдено із сіда «безкоштовна доставка».
Це дешева перевірка (один прохід по входженнях), і вона прибирає більшу частину дублювальної роботи: без неї кожен довгий шаблон довжиною L «вирощувався» б майже L разів — з кожного свого внутрішнього сіда.
Перевірка максимальності
Коли фраза більше не росте праворуч, треба вирішити, чи потрапляє вона до відповіді. Два запитання:
(А) Чи не є вона шматком уже знайденої фрази? Наївно — порівняти з усіма знайденими. Це дорого: знайдених можуть бути десятки тисяч. Тому ведеться інвертований індекс «токен → знайдені фрази, де він є». Для кандидата береться його найрідкісніший (за цим індексом) токен, і порівнювати треба лише з фразами з його списку. Якщо надфраза існує, вона мусить містити й цей токен, тож нічого не губиться, а список зазвичай дуже короткий.
(Б) Чи не поглинає вона щось знайдене раніше? Якщо нова фраза довша й містить раніше знайдену, стару видаляють із відповіді та з індексу.
Це саме та ситуація, що й із фразою «безкоштовна доставка» в Частині 2: підфраза може мати більшу підтримку, її можуть знайти раніше — і все одно зрештою вона має поступитися місцем надфразі.
Маска покриття
Останній механізм — глобальна бітова маска завдовжки з увесь корпус: по одному прапорцю на кожну позицію. Коли фразу підтверджено як максимальну, всі позиції всіх її входжень позначаються. Якщо в чергового сіда всі входження лежать в уже позначених позиціях, його пропускають, навіть не почавши вирощувати.
Завдяки сортуванню за Ψ це спрацьовує часто: хребти знаходять першими, і більшість наступних сідів — їхні нутрощі.
Ця маска має й другий сенс, важливіший для початкової задачі, ніж перший. До цього повернемося в Частині 6.
Увесь алгоритм
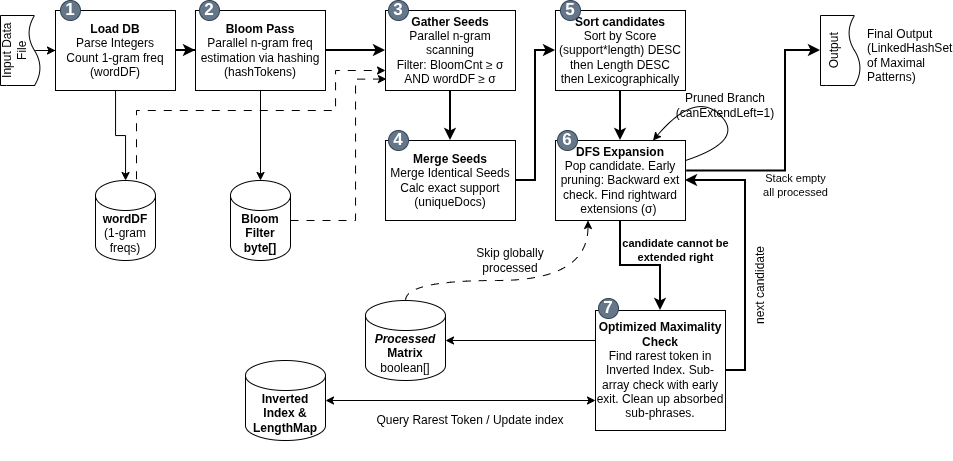
- Завантажити корпус як масиви
int, порахувати точнийdfкожного слова. - Один лінійний прохід: усі біграми — в лічильний фільтр.
- Другий паралельний прохід: залишити біграми, що пройшли обидва фільтри.
- Відсортувати входження, злити, порахувати точний
df, викинути хибнопозитивні. - Відсортувати сіди за Ψ.
- Для кожного сіда (якщо його не покриває маска) — ріст у глибину з раннім відсіканням.
- Перевірка максимальності через інвертований індекс, оновлення маски.
Скільки це коштує
Нехай W — кількість токенів у корпусі, M — розмір фільтра, C — кількість входжень сідів, що вижили, P — кількість знайдених фраз.
Пам'ять: O(W + M + C + P). Корпус і маска — по O(W), фільтр — рівно M
байтів (у нас до 512 МБ), сіди та індекс — пропорційно тому, що пережило
фільтр. Ключова відмінність від суфіксного масиву: дорогі структури будуються
не для всіх W позицій, а лише для C, а C — це кілька відсотків від W.
Час: фільтр і збирання сідів — лінійні проходи плюс сортування сідів,
Θ(W + C log C). Фаза росту залежить від даних, і чесної оцінки найгіршого
випадку для неї немає. Натомість — вимірювання в наступній частині.
Якщо коротко про чесність: у найгіршому випадку BloomSpan не кращий за точні методи, а іноді й гірший. Він виграє на певній «формі» даних — і саме ця форма типова для природного тексту.
Частина 5. Вимірювання
Як вимірювали
Усі алгоритми реалізовано на Java й запущено на одній машині (Intel Core
Ultra 9, 64 ГБ RAM, OpenJDK 21, купа -Xmx40g). FHK і DFI — власні
реалізації (SA-IS + LCP за Касаї), BIDE+, VMSP і GST — із SPMF. Час —
від виклику алгоритму до результату, включно з побудовою суфіксного масиву
для FHK/DFI. Кожна конфігурація — 6 прогонів, перший викидається як розігрів
JVM, у таблицях — медіана решти п'яти.
Набори даних:
| набір | що це | σ | мін. довжина |
|---|---|---|---|
| Синтетика 1 | документи з випадково згенерованих «слів» (не англійських), у які вставлено три фіксовані фрази | 3 | 3 |
| Синтетика 2 | 300 фраз спадної довжини, що сильно перекриваються, — найгірший випадок для BloomSpan | — | — |
| Gutenberg-8k | 8544 книжки з Project Gutenberg, 535 млн токенів | 10 | 5 |
| Gutenberg-BookCorpus-Cleaned | до 50 000 книжок, до 3,07 млрд токенів | 20 | 10 |
Як улаштована Синтетика 1. «Слова» в ній — не слова англійської мови, а
випадкові рядки: кожне — 8 випадкових малих латинських літер (qhzbtwla,
mfoxkrdu тощо). Генератор працює так:
- Згенерувати N × 5000 рядків по 8 випадкових літер, відкидаючи повтори, так щоб усі рядки були унікальними в межах усього корпусу. Варіантів 26⁸ ≈ 2·10¹¹, тож справжнє англійське слово серед них — рідкісна випадковість, а осмислених сполучень немає взагалі.
- Порізати їх поспіль по 5000 на документ. У результаті кожне «слово» фону
трапляється рівно в одному документі,
df = 1: повторів у фоні немає за побудовою. - Взяти із CSV три короткі англійські фрази із заданою підтримкою («This is the first test sentence» — 3 документи, «Another unique phrase for testing» — 5, «A third sentence» — 4). Для кожної обрати стільки різних випадкових документів і вставити фразу цілком у випадкове місце між словами фону.
Виходить корпус, для якого правильна відповідь відома заздалегідь: рівно три
часті фрази й нічого більше. Це перевірка коректності та стрес-тест на
«пласкому» розподілі без повторів, але на природний текст такий корпус не
схожий. Генератор лежить у репозиторії
(corpus-miner/test-gen/generate_test_dataset.py).
Коректність перевіряли безпосередньо: на Gutenberg-8k за всіх розмірів, де дораховує хоча б один точний бейзлайн (до 5000 книжок), множини фраз BloomSpan, FHK і DFI відсортували й порівняли — вони повністю збігаються. Ні пропусків, ні зайвого. Понад 5000 книжок порівнювати нема з чим, і еквівалентність там не стверджується.
Великий корпус: те, для чого BloomSpan і задумували
Gutenberg-BookCorpus-Cleaned, σ = 20, мінімальна довжина 10. Час у секундах, пам'ять у МБ, OOM — не вистачило 40 ГБ.
| книжок | BloomSpan, с | BloomSpan, МБ | FHK, с | FHK, МБ | DFI, с | DFI, МБ | прискорення | фраз |
|---|---|---|---|---|---|---|---|---|
| 1 000 | 1,73 | 5 095 | 19,08 | 6 591 | 20,17 | 9 138 | 11,0× | 31 |
| 3 000 | 4,16 | 7 836 | 60,34 | 7 856 | 67,25 | 29 393 | 14,5× | 120 |
| 5 000 | 6,64 | 6 977 | 101,33 | 11 238 | OOM | OOM | 15,3× | 217 |
| 8 000 | 10,41 | 8 853 | 160,37 | 16 708 | OOM | OOM | 15,4× | 375 |
| 10 000 | 13,59 | 12 044 | 199,34 | 20 764 | OOM | OOM | 14,7× | 516 |
| 15 000 | 20,80 | 14 979 | 308,67 | 31 549 | OOM | OOM | 14,8× | 1 034 |
| 20 000 | 27,67 | 20 839 | — | — | OOM | OOM | — | 1 964 |
| 30 000 | 44,61 | 29 385 | 662,24 | 38 461 | OOM | OOM | 14,8× | 3 673 |
| 50 000 | 383,27 | 38 873 | OOM | OOM | OOM | OOM | — | — |
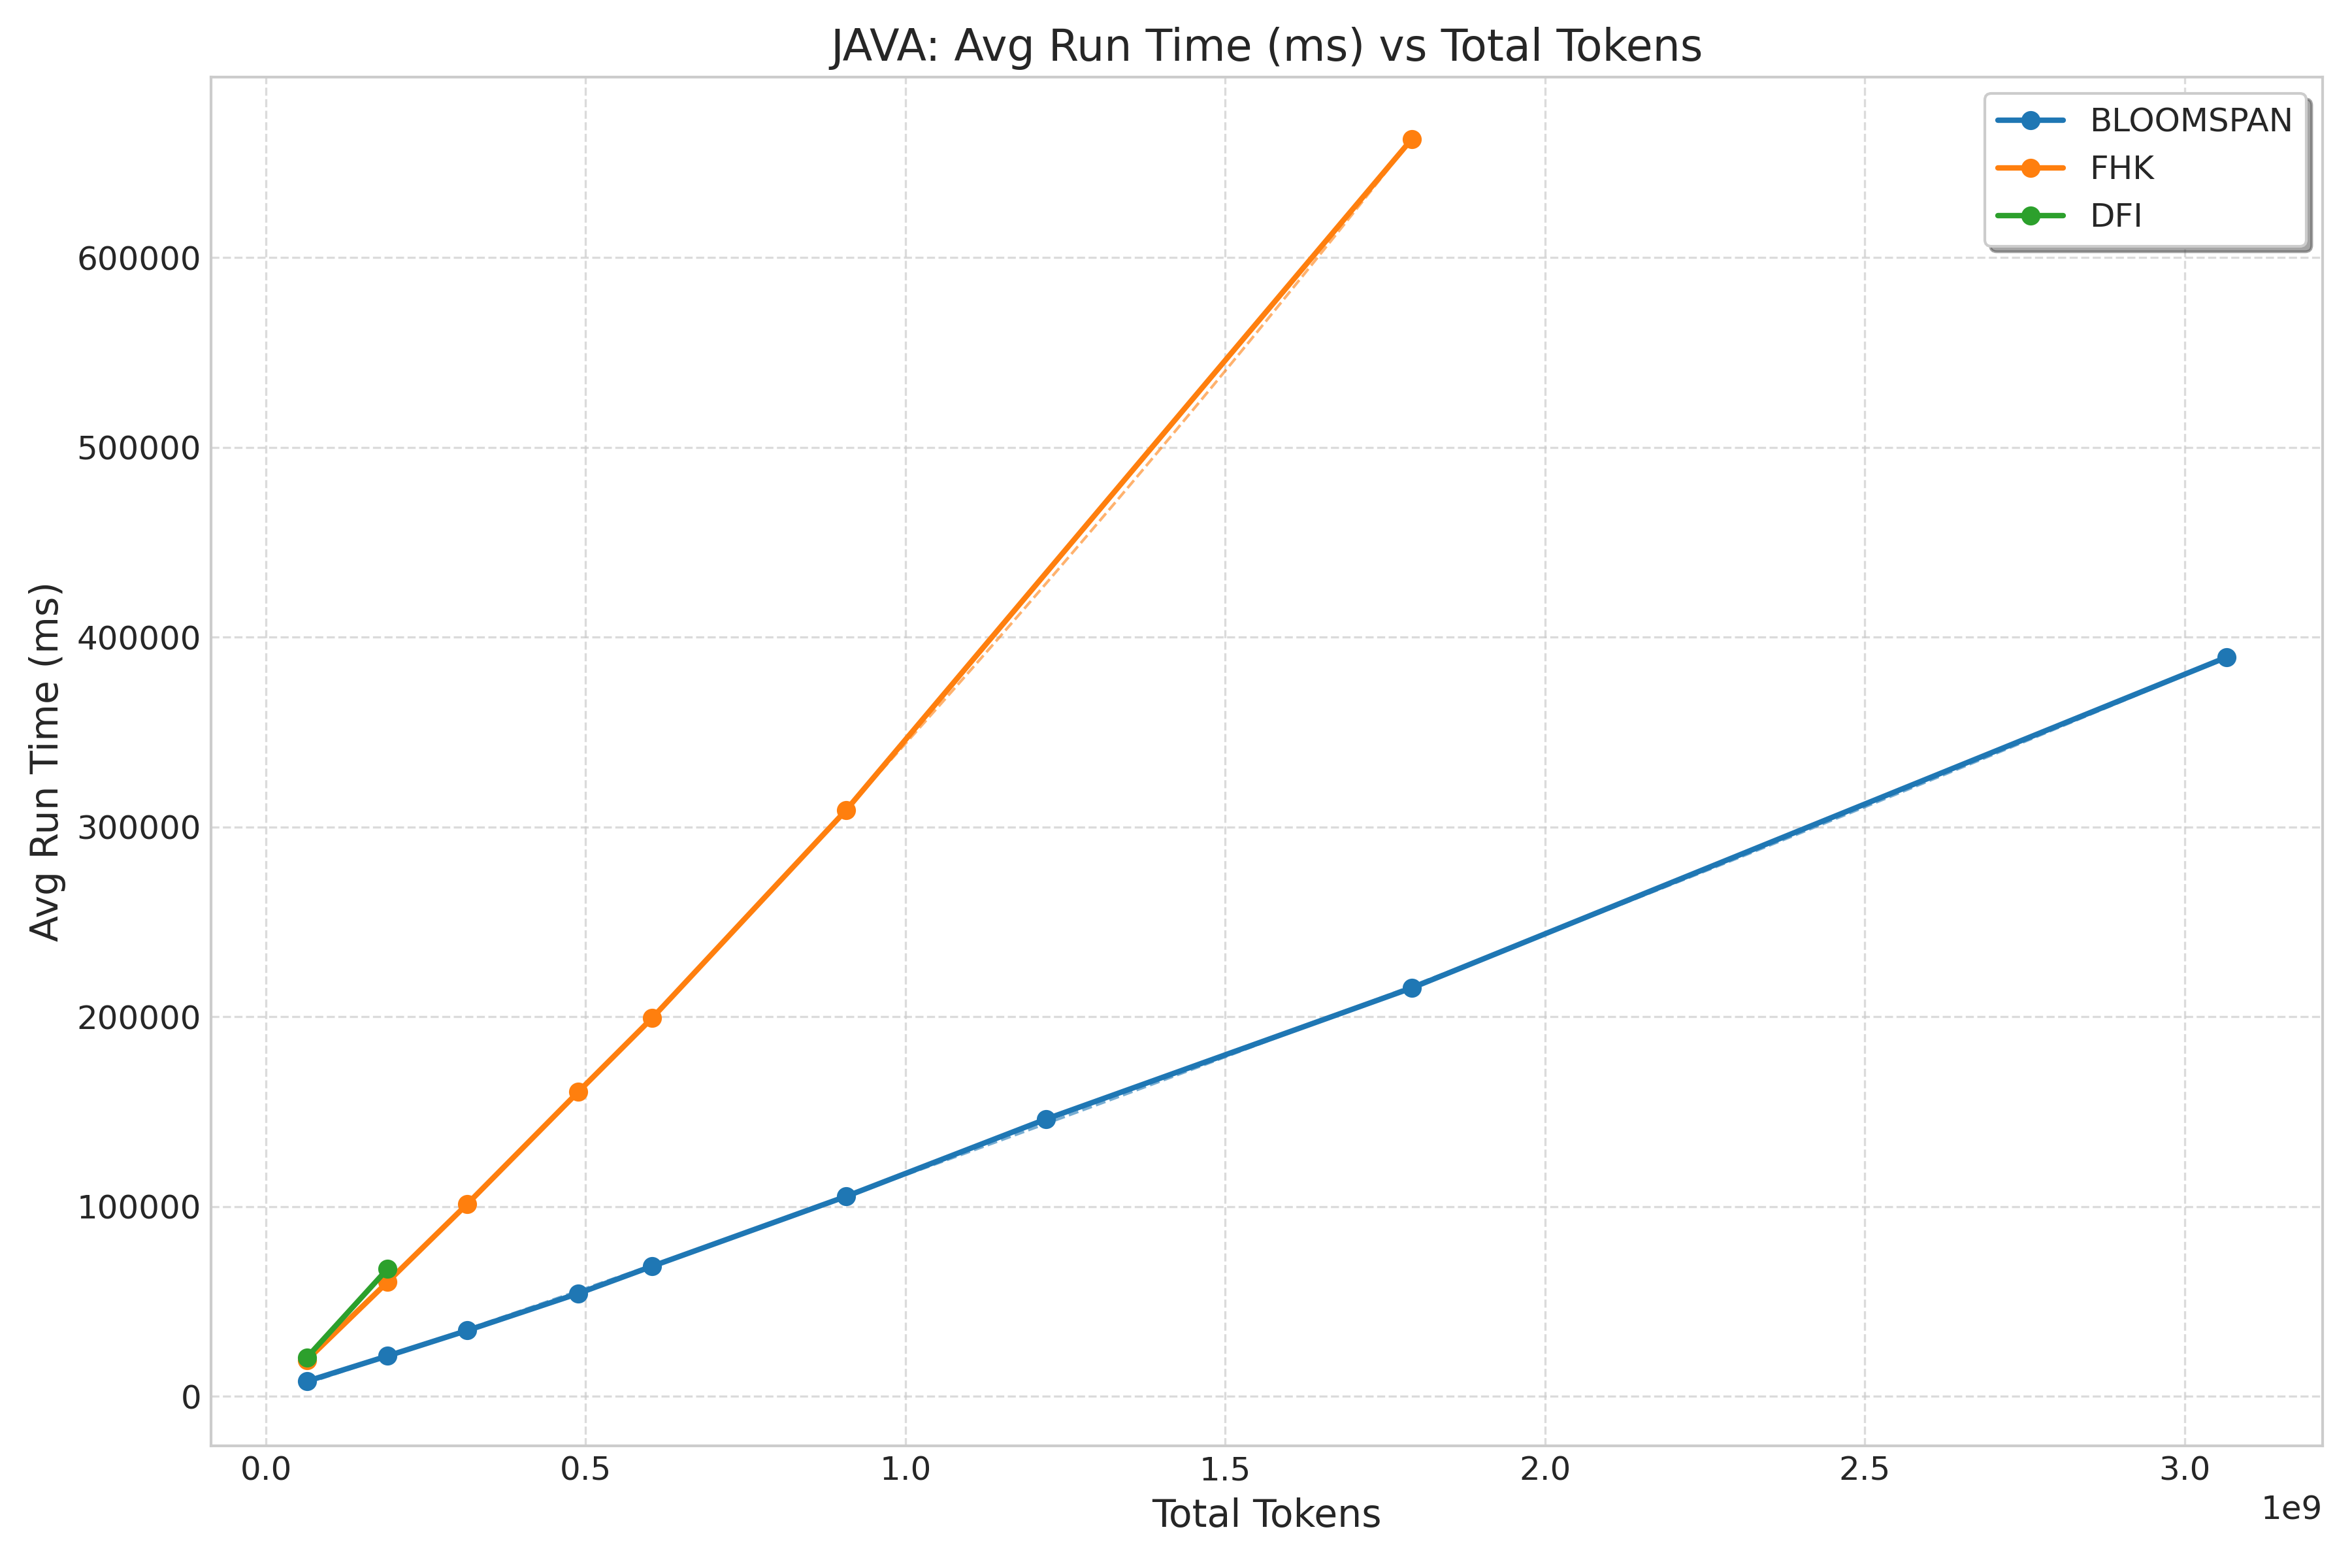
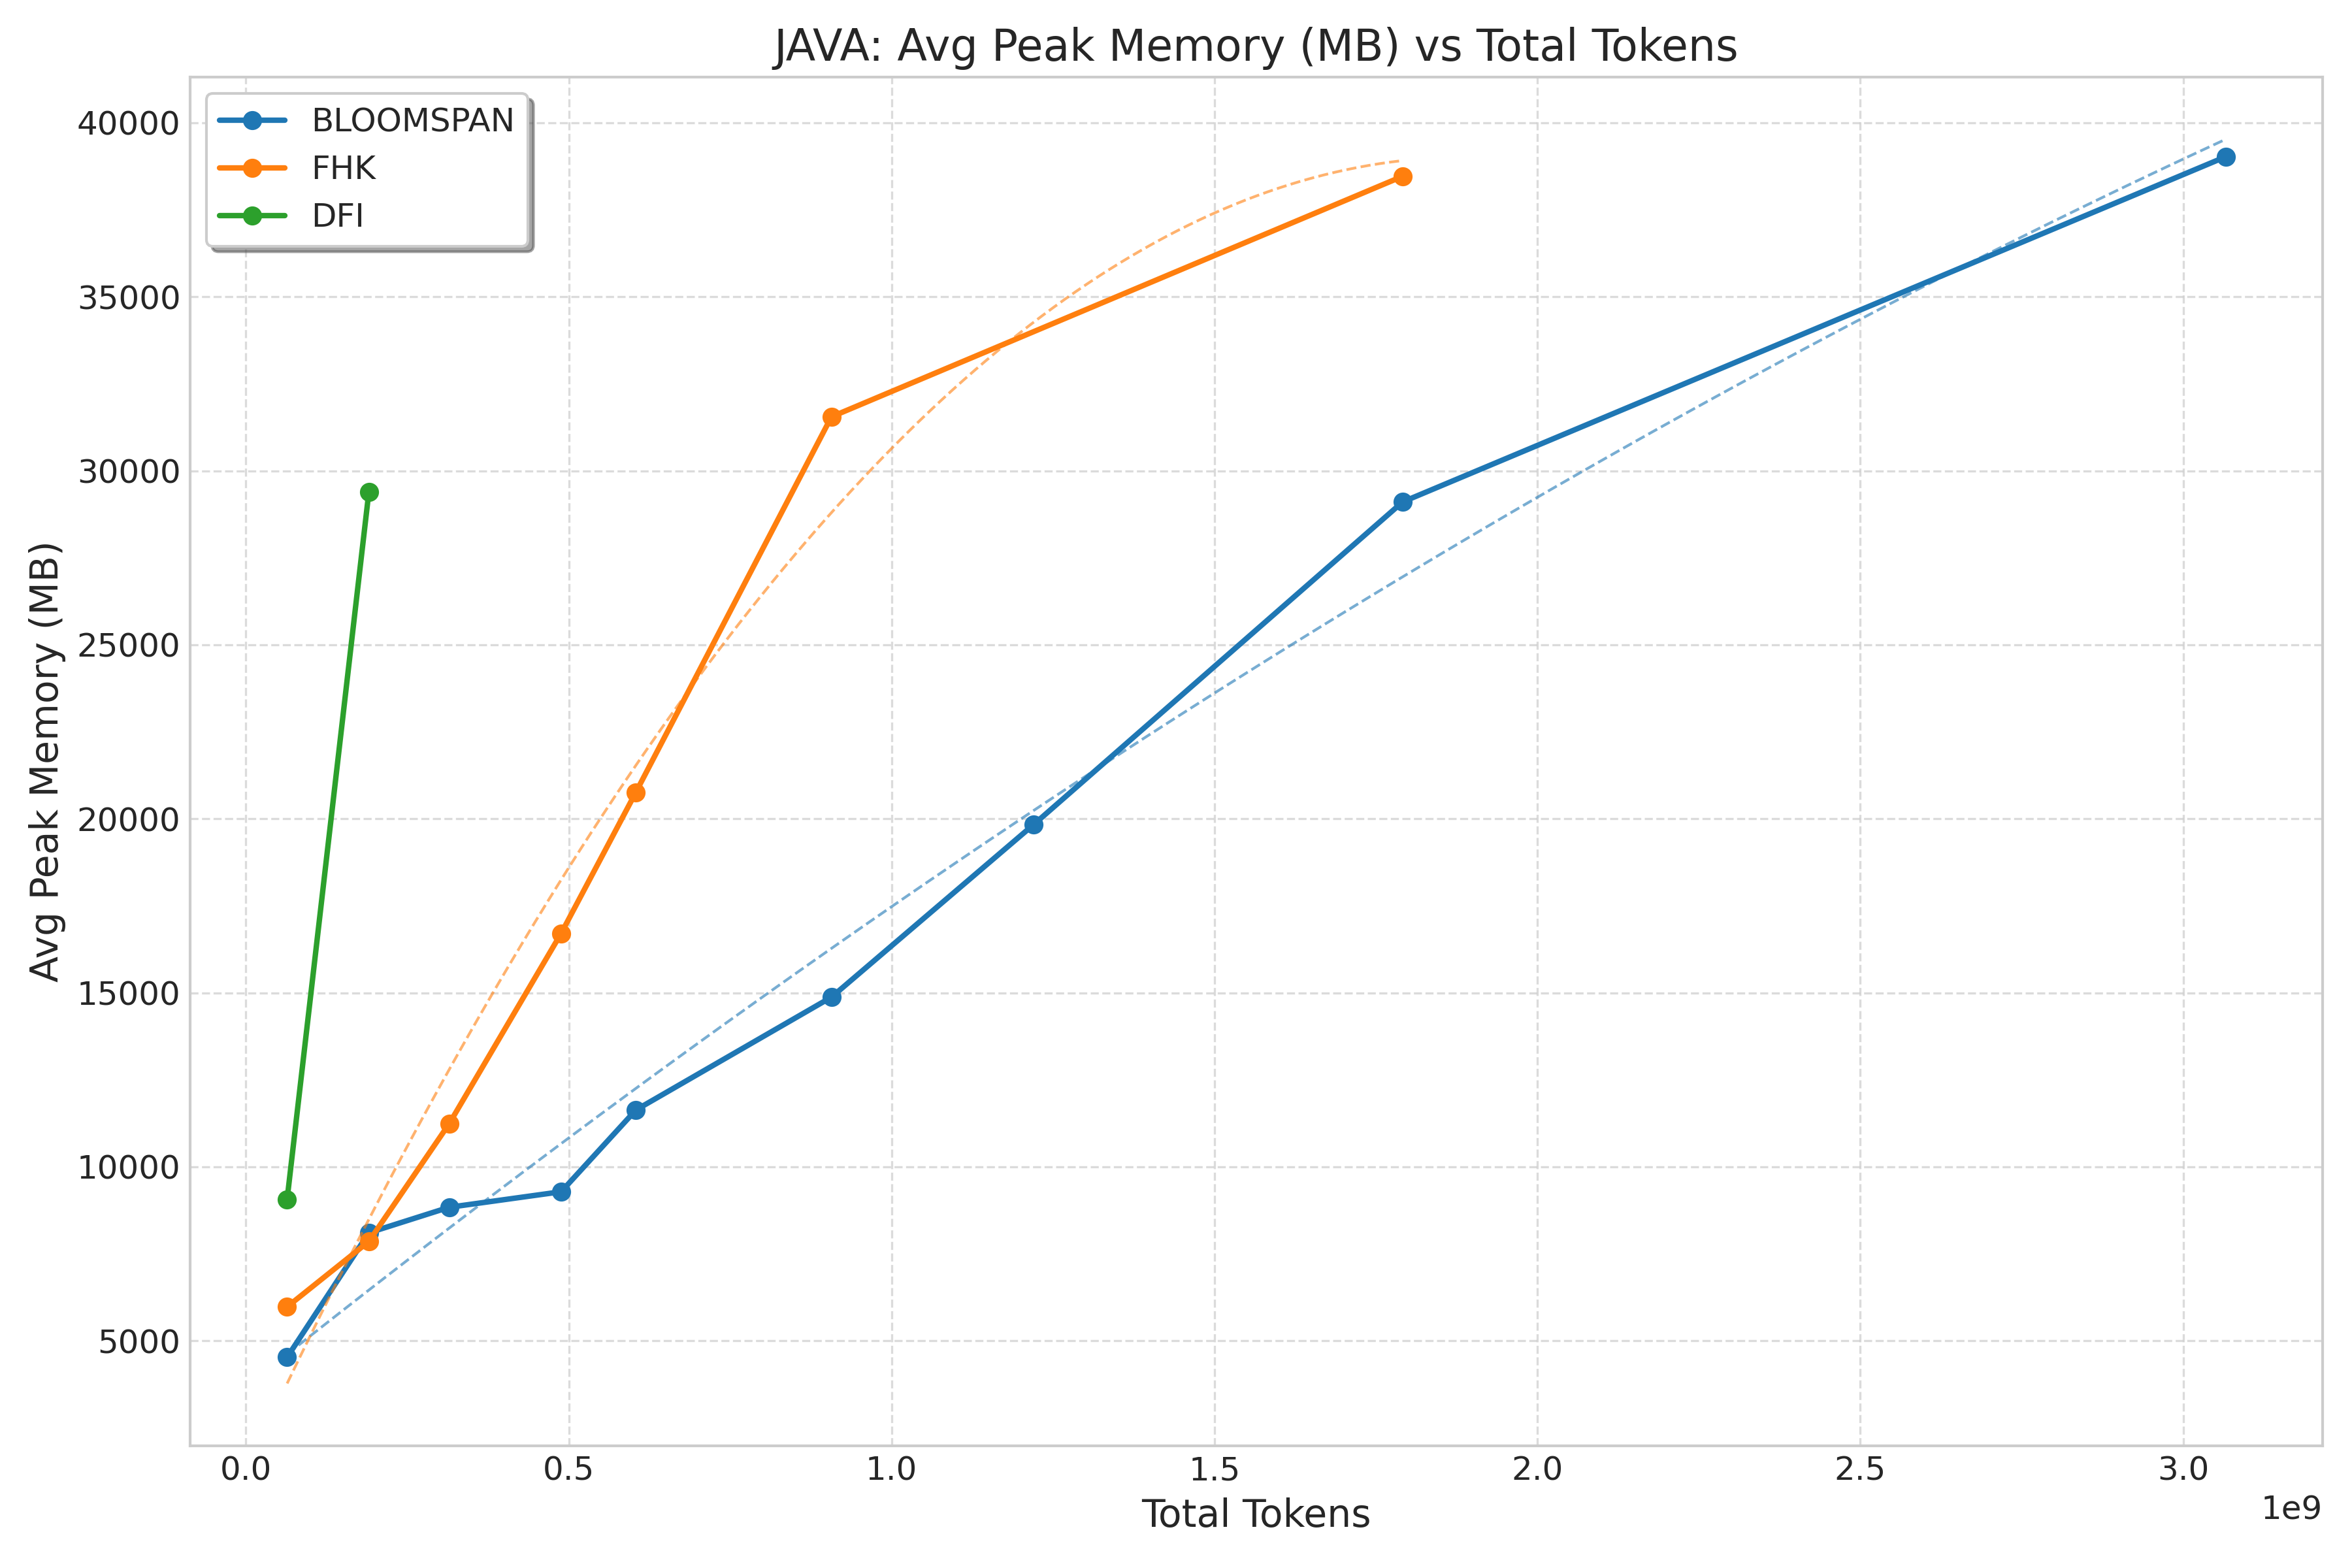
Що тут видно:
- В 11–15 разів швидше за FHK в усіх точках, де дорахували обидва.
- Розрив у пам'яті зростає з розміром: на 15 000 книжках — 15,0 ГБ проти 31,5 ГБ.
- DFI зі своєю sparse-таблицею RMQ (
O(n log n)пам'яті) з'їдає 29 ГБ уже на 3000 книжках і падає на 5000. FHK доходить до 30 000 книжок (≈1,7 млрд токенів). BloomSpan — єдиний, хто дорахував 50 000 книжок (≈3,07 млрд токенів) у 40 ГБ. - Масштабування майже лінійне: до 30 000 книжок вартість обробки одного токена тримається в діапазоні 0,021–0,027 мкс — за зростання входу в 28 разів. Нахил у логарифмічних координатах — 0,98.
- На 50 000 книжках лінійність ламається: вартість стрибає до 0,125 мкс на токен. Причина — фраз стає багато, і перевірка максимальності, вартість якої залежить від розміру відповіді, виходить на перший план. Нахил за всіма дев'ятьма точками — 1,24.
Де BloomSpan програє
Було б нечесно показувати лише зручну таблицю. Є три режими, де BloomSpan не найкращий.
Синтетика 1 (рідкісні вставки в унікальний фон). До 10 000 документів усі стрингологічні алгоритми масштабуються приблизно лінійно й ідуть майже нарівні. На 12 000 документах відбувається перелом, і далі FHK швидший та ощадливіший: на 30 000 документах FHK — 15,3 с і 38,9 ГБ, BloomSpan — 38,2 с і впирається в ліміт купи.
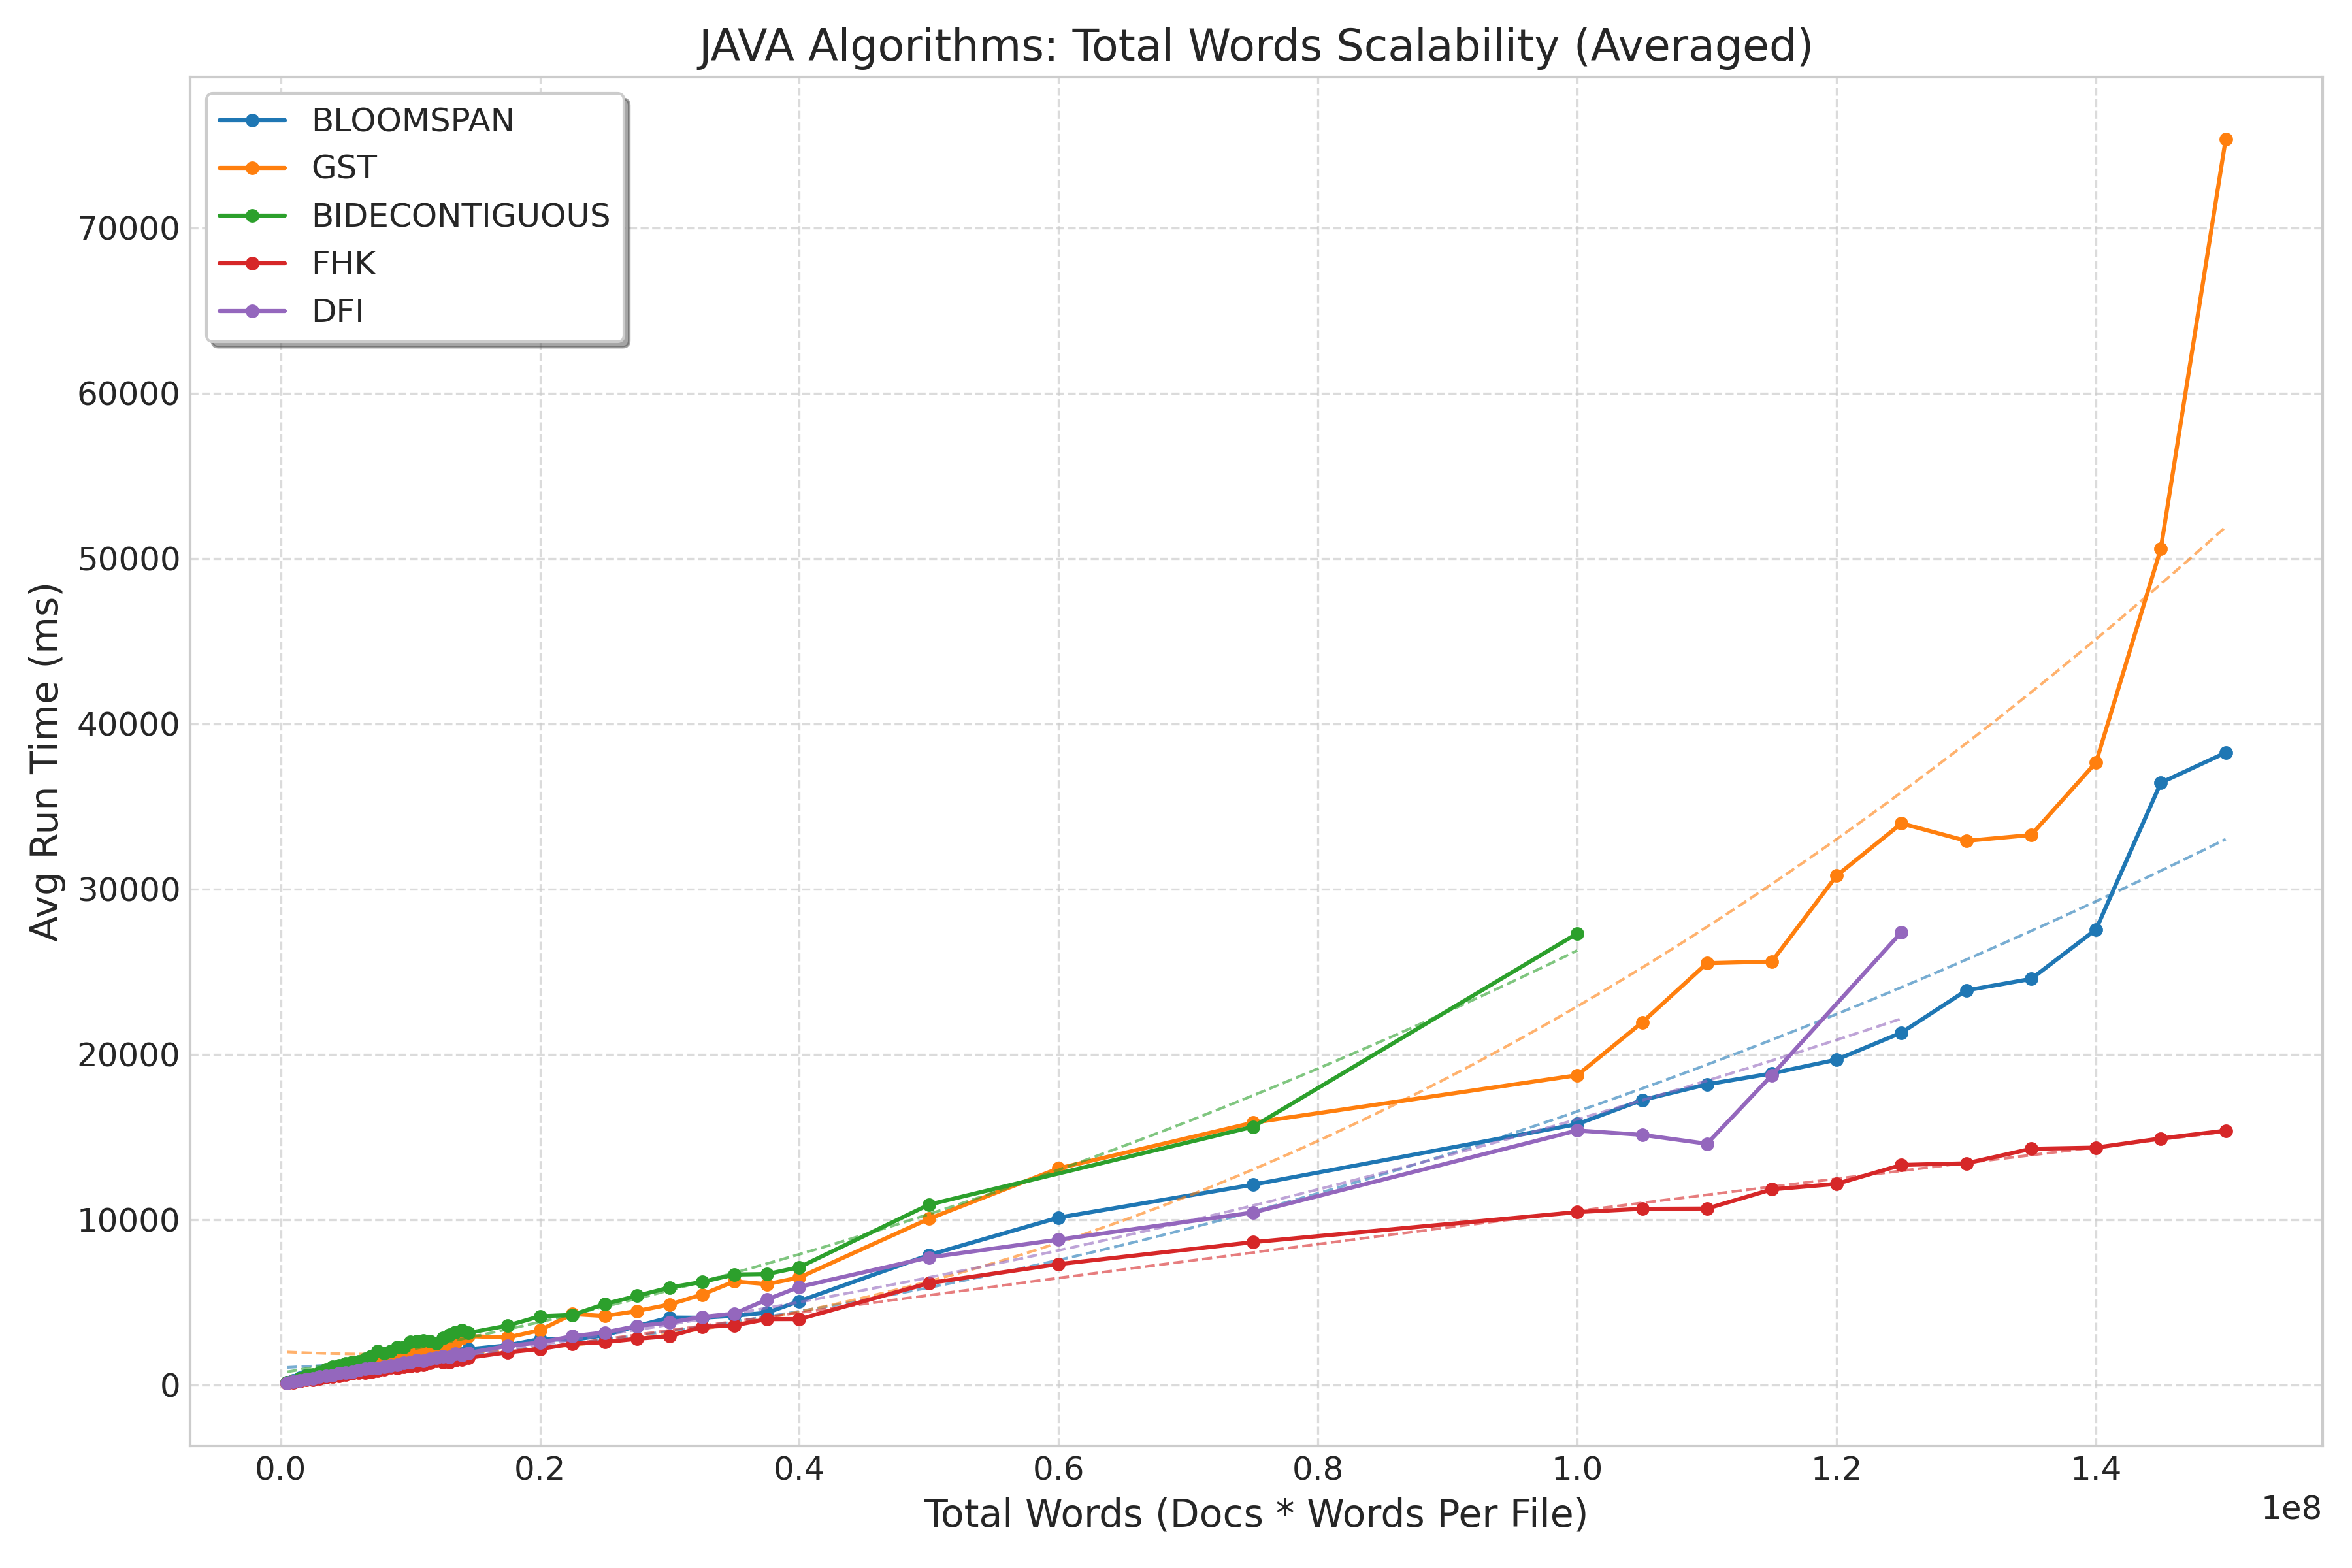
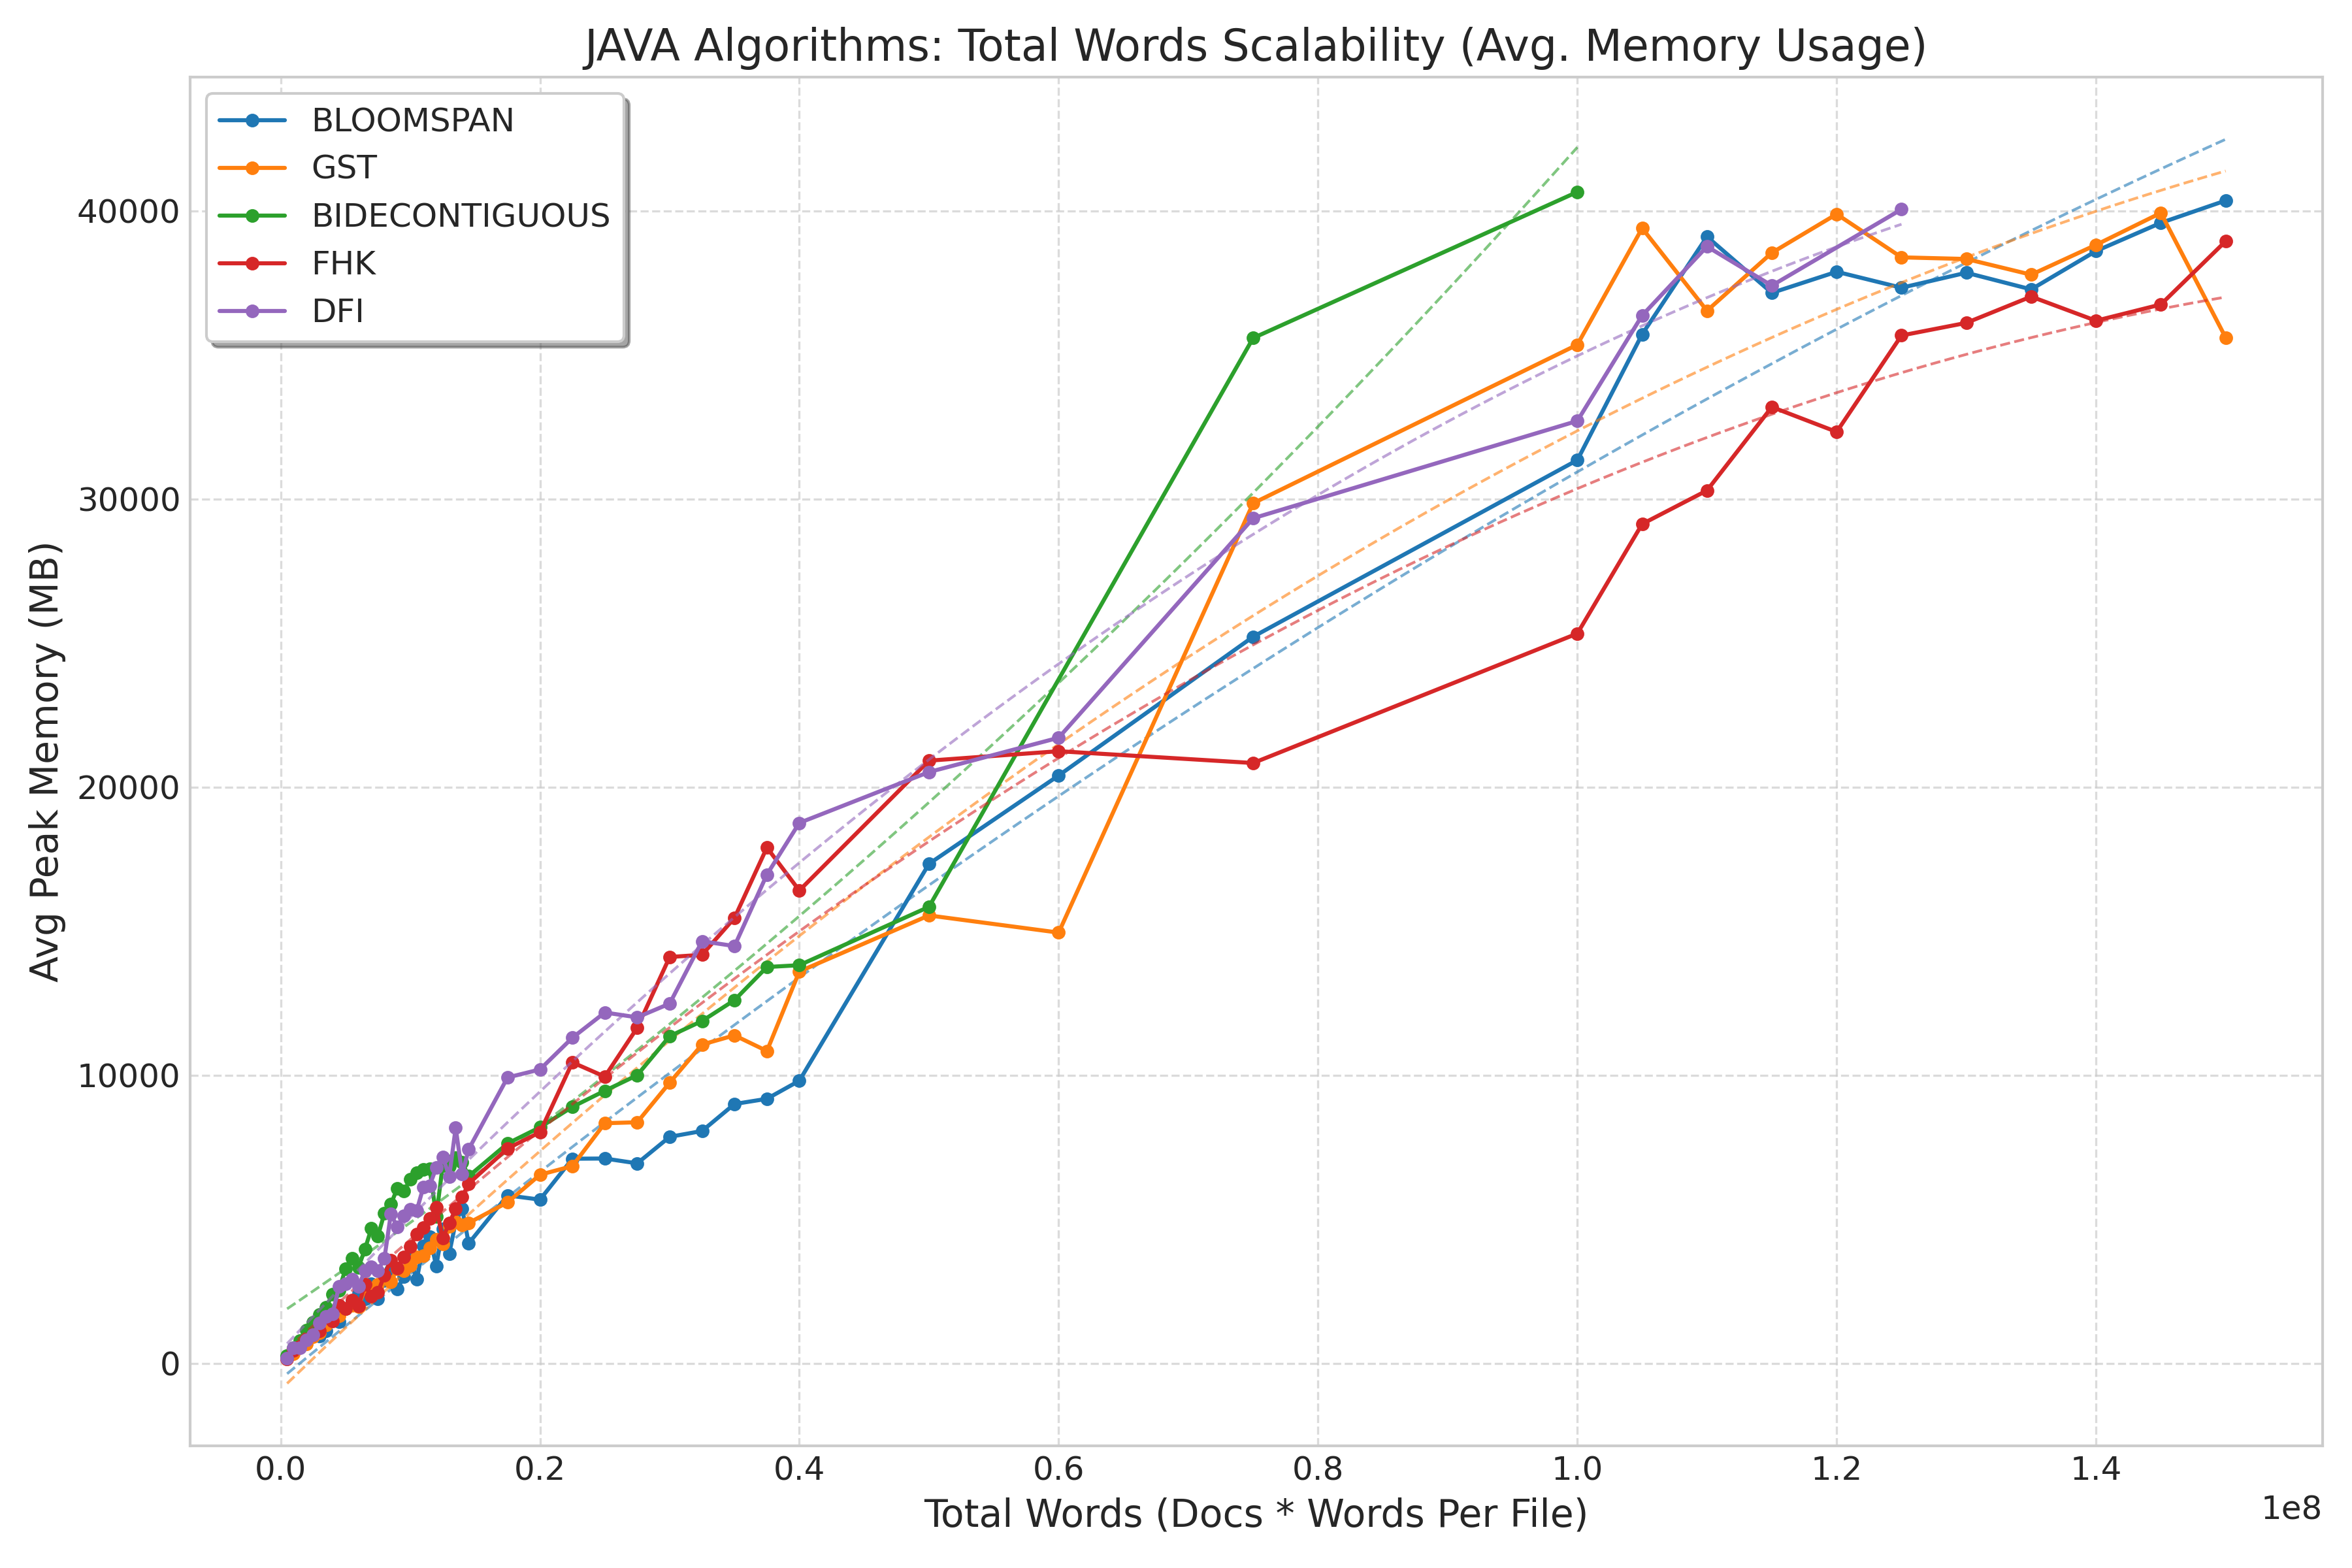
Синтетика 2 (щільні вкладені перекриття). Спеціально побудований найгірший випадок. FHK — 10,5 с, BloomSpan — 12,6 с, DFI — 14,9 с, BIDE+ (неперервний, максимальний) — 16,8 с. Решта SPMF-алгоритмів — OOM.
Gutenberg-8k за м'якого порогу σ = 10. До 1000 книжок BloomSpan на ≈20% швидший за FHK/DFI. Починаючи з 3000 книжок FHK/DFI на 10–20% швидші: за м'якого порогу частих фраз стає дуже багато (≈218 тисяч на 5000 книжках), і знову домінує перевірка максимальності. На 8000 книжках BloomSpan падає через брак пам'яті, а FHK і DFI дораховують.
| книжок | BloomSpan, мс | FHK, мс | DFI, мс | BIDE+, мс | GST, мс |
|---|---|---|---|---|---|
| 100 | 713 | 625 | 655 | 1 275 | 2 373 |
| 500 | 3 201 | 3 896 | 4 016 | 13 241 | 27 170 |
| 1 000 | 6 608 | 8 425 | 8 313 | OOM | OOM |
| 3 000 | 28 550 | 25 427 | 25 185 | OOM | OOM |
| 5 000 | 141 023 | 117 228 | 111 864 | OOM | OOM |
| 8 000 | OOM | 2 214 653 | 1 461 332 | OOM | OOM |
Чому так: «форма» корпусу
Різницю пояснює не розмір, а структура даних. Зручна міра — кількість
фраз у розбитті Лемпеля–Зіва, поділена на кількість токенів (c/n): грубо
кажучи, наскільки текст «стискається» завдяки повторам.
- Синтетика 1: фон з унікальних слів,
c/n ≈ 1: кожен токен фону новий, тому кожна LZ-фраза складається з одного токена (LZ78-розбиття згенерованого корпусу з 1000 документів дає 0,99999). У фоні повторів немає взагалі — за побудовою кожне «слово» трапляється рівно один раз. У всьому корпусі повторюються лише три вставлені фрази — кілька десятків токенів на десятки й сотні мільйонів. Розподіл плаский. Фільтр Блума відсікає фон, але FHK дає з ним раду не гірше — і без окремого проходу фільтра, тож фільтр тут — чистий оверхед. - Синтетика 2: майже кожна n-грама зі вставленої родини часта. Фільтру нема чого відсікати, вся робота — у перевірці максимальності. А LCP-інтервали FHK якраз природно «згортають» вкладені перекриття.
- Природна мова (Gutenberg):
c/n ≈ 0,27, близько 7,94 біта на токен. Ципфівський хвіст рідкісних n-грам, який фільтр зрізає на 98%, і помірна кількість не патологічно вкладених повторів. Це та форма даних, для якої проєктували BloomSpan. Вебкорпус після краулера — теж природний текст, лише з більшою кількістю шаблонних повторів; за цією мірою варто очікувати, що він ближчий до Gutenberg, ніж до будь-якої із синтетик (сам яc/nдля вебкорпусу в цих експериментах не вимірював).
Практичне правило: суворий поріг і великий корпус природного тексту — BloomSpan. М'який поріг, багато знайденого або дані зі щільними вкладеними повторами — суфіксні методи.
Частина 6. Назад до індексу
Від списку фраз до відповіді «скільки сміття»
Список максимальних фраз — це відповідь на запитання «що повторюється». Але початкове запитання було «скільки».
Тут стає в пригоді маска покриття з Частини 4. Після завершення роботи алгоритму в ній позначено саме ті позиції корпусу, які належать хоча б одному входженню якоїсь знайденої фрази. Отже:
- частка позначених позицій у всьому корпусі — це частка тексту індексу, що складається з повторюваних фрагментів;
- частка позначених позицій у кожному документі — це «засміченість» конкретного документа. Розподіл цієї величини за документами одразу показує, чи є в індексі сторінки, які майже цілком складаються з шаблону (кандидати на викидання), і які сайти/розділи засмічені сильніше за інші;
- сортування фраз за
|P| × df(P)— це список «головних пожирачів індексу»: який саме фрагмент займає найбільше токенів.
Тобто та сама структура, яка прискорює алгоритм, після його завершення стає основною метрикою.
Як обирати σ і мінімальну довжину
Два параметри працюють як дві ручки.
- σ відповідає за «наскільки масово». Занизький — до відповіді потрапляють будь-які збіги: цитати, сталі вирази, однакові характеристики двох схожих товарів. До того ж, як видно з таблиць вище, зростає обсяг відповіді й падає швидкість. Зависокий — пропускаються шаблони невеликих сайтів. Розумно починати з порогу, прив'язаного до розміру типового сайту в корпусі, а не до розміру корпусу.
- Мінімальна довжина відсікає сталі словосполучення. Фраза з 3–4 слів із високою підтримкою — це частіше мова, ніж шаблон. Дисклеймери й футери зазвичай довші за 10 токенів.
На що звернути увагу
Точний збіг — це обмеження. Шаблон зі змінною частиною («Показано 1–20 із 345 товарів», «© 2019», «© 2024», ім'я автора в підписі) розпадається на кілька фраз між змінними вставками. Кожну з них окремо буде знайдено, але як шматки, а не як один шаблон. Урахування «майже однакових» фраз (з допуском на редакційну відстань) — наступний крок, якого в BloomSpan поки немає.
Повторюється — не завжди означає сміття. В e-commerce той самий опис нерідко повторюється в картках усіх кольорів і розмірів одного товару. У новинах — цитата з офіційної заяви в усіх замітках на цю тему. У законодавстві — типові формулювання, які й є контентом. Алгоритм знаходить повтори; рішення, які з них шум, — доменне, і його треба ухвалювати, дивлячись на верхівку списку.
Токенізація губить пунктуацію та регістр. Для пошуку шаблонів це радше плюс (дрібні відмінності в оформленні не заважають збігу), але під час зворотного мапінгу знайденої фрази на вихідний текст це треба враховувати.
Підсумок
Задача «знайти всі довгі фрагменти, що дослівно повторюються в багатьох документах» має вигляд вправи на хеш-таблицю. На мільярдах токенів вона перетворюється на вибір між трьома поганими варіантами: хеш-таблиця n-грам не вміщується в пам'ять, алгоритми sequential pattern mining тонуть у комбінаториці пропусків, а точні суфіксні методи будують дорогі структури для кожного токена корпусу, навіть для тих 98%, з яких не починається жодна часта фраза.
BloomSpan спирається на те, що природний текст підпорядковується закону Ципфа:
- лічильний фільтр Блума відсікає переважну більшість кандидатів за один лінійний прохід і, оскільки помиляється лише вгору, не губить жодної частої фрази;
- пріоритет за Ψ = |P| × df(P) змушує спершу знаходити наймасивніші шаблони;
- ріст у глибину безпосередньо в корпусі обходиться без проєційованих баз;
- раннє відсікання за лівим сусідом, інвертований індекс за найрідкіснішим токеном і маска покриття прибирають дублювальну роботу.
На 3 млрд токенів це в 11–15 разів швидше за FHK, удвічі ощадливіше щодо пам'яті, і алгоритм дораховує там, де інші не вміщуються в 40 ГБ. На м'яких порогах і синтетиці зі щільними повторами він програє суфіксним методам, і це варто знати заздалегідь.
А для початкової задачі головне навіть не швидкість: після роботи алгоритму маска покриття дає саме ту відповідь, заради якої все й затівалося, — яка частка індексу складається з повторюваних фрагментів і де саме вони лежать.
Discussion
Powered by GitHub Discussions — sign in with a GitHub account to join the conversation.