
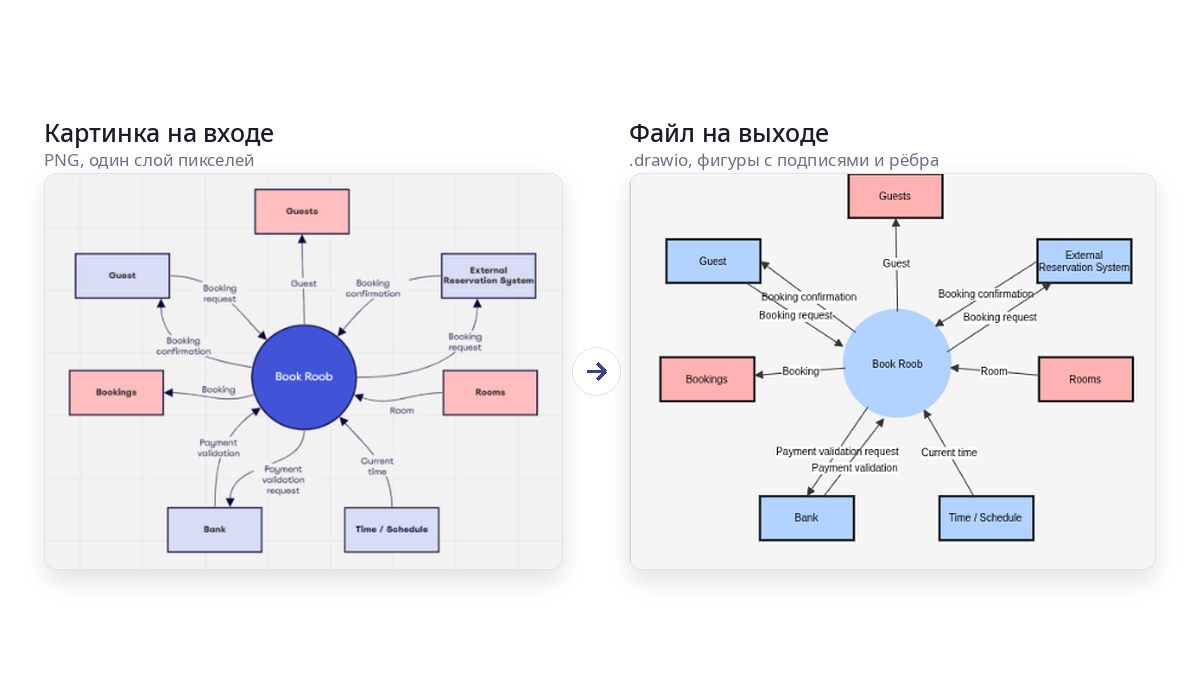
Навіщо це знадобилося
Я раз у раз потрапляю в ту саму ситуацію. Потрібна діаграма, яка існує лише як картинка: скриншот архітектурної схеми з чужої презентації, PNG зі старої документації, експорт із PDF, вихідний файл якого загубився разом з автором. Виправити в ній треба одну стрілку й два підписи, а перемальовувати доводиться все.
Хотілося інструмента, якому віддаєш растрове зображення, а отримуєш, скажімо, .drawio, де кожен прямокутник — прямокутник, кожен підпис — текст, а кожна стрілка — ребро між двома вузлами. Далі редагуй що треба.
Як я до цього йшов — від складання прямокутників з окремих відрізків до зв'язки комп'ютерного зору з мультимодальною моделлю, з розбором того, що ламається дорогою. Усі картинки в статті — результат прогону на моїй машині, без ручного доопрацювання, тож помилок на них видно чимало. Код лежить на GitHub, посилання наприкінці. Користуйтеся на здоров'я.
У цьому рішенні активно використано і AI, і комп'ютерний зір. Почнімо із зору, бо на вході все-таки картинка.
Трасувальник розв'язує іншу задачу
Перше, що спадає на думку, — узяти трасувальник: potrace, Image Trace в Illustrator, будь-який «raster to vector». Такі інструменти дають контури та криві Безьє. Картинка перестає розпадатися на пікселі під час збільшення, але редагованою схемою не стає. Прямокутник перетворюється на замкнену криву, ще й з артефактами, текст — на набір силуетів літер, стрілка — на залиту фігуру. Пересунути вузол так, щоб за ним потягнулася стрілка, не можна, бо ні вузла, ні стрілки у файлі немає.
Тут потрібна об'єктна модель. Список вузлів з координатами, розміром, формою, підписом і стилем плюс список ребер з напрямком і підписами. Це вже зворотна розробка — за фінальним рендером відновити документ, з якого він вийшов.
Що відновлюємо? Межі й форму вузлів — на картинці це замкнені контури та їхня геометрія. Вкладеність — один прямокутник усередині іншого. Підписи вузлів — текст у межах вузла. Зв'язки — лінії між вузлами й наконечники. Підписи зв'язків — текст біля лінії. Стилі — колір заливки, колір і тип рамки.
Перші два пункти — чиста геометрія, їх покриває комп'ютерний зір. Останні чотири вимагають розуміння того, що намальовано. Лінію між блоками ще можна знайти за пікселями, а от напрямок стрілки, підпис і колір словами — це вже не так просто. Різниця між цими пунктами й визначила всю архітектуру, але зрозумів я це не одразу.
Спроба зібрати прямокутники з відрізків
Перший прототип (зараз він лежить у репозиторії як legacy/vectorizer.py) виходив з того, що схема складається з ліній. Отже, треба знайти лінії, а з них зібрати фігури.
Одразу скажу, що цей прототип прожив недовго. Але розповісти про нього варто, бо lessons learned часто найцінніше, що читач може винести з таких статей. Повторити рішення за кимось — великого розуму не треба.
Конвеєр був такий. Спершу так звана бінаризація, у три шари. Адаптивний поріг за середнім, градієнт Собеля для слабоконтрастних меж, Canny поверх градієнта і стоншення до ліній завтовшки в піксель.
Не лякайтеся, зараз поясню. Градієнт Собеля — це спосіб виміряти, наскільки різко змінюється яскравість у кожній точці картинки. Береться віконце три на три пікселі й прикладається до зображення двічі. Один раз воно порівнює лівий стовпчик із правим, удруге — верхній рядок із нижнім, причому середнім пікселям у кожній трійці дають подвійну вагу, щоб шум менше заважав. Виходять два числа — наскільки яскравість зростає по горизонталі й наскільки по вертикалі. З них за теоремою Піфагора складається сила перепаду, а заразом можна обчислити і його напрямок. Там, де картинка рівна, наприклад посеред чистого аркуша чи всередині жирного штриха, це число близьке до нуля; там, де світле переходить у темне, воно підскакує. Принадність у тому, що градієнтові байдужа сама яскравість, йому важлива лише різниця між сусідами. Наприклад, бліда олівцева лінія на сірому тлі, яку поріг за середнім проковтне як «приблизно тло», однаково дасть помітний сплеск, бо межа в неї все ж таки є. Тому другий шар і ловив те, що пропускав перший.
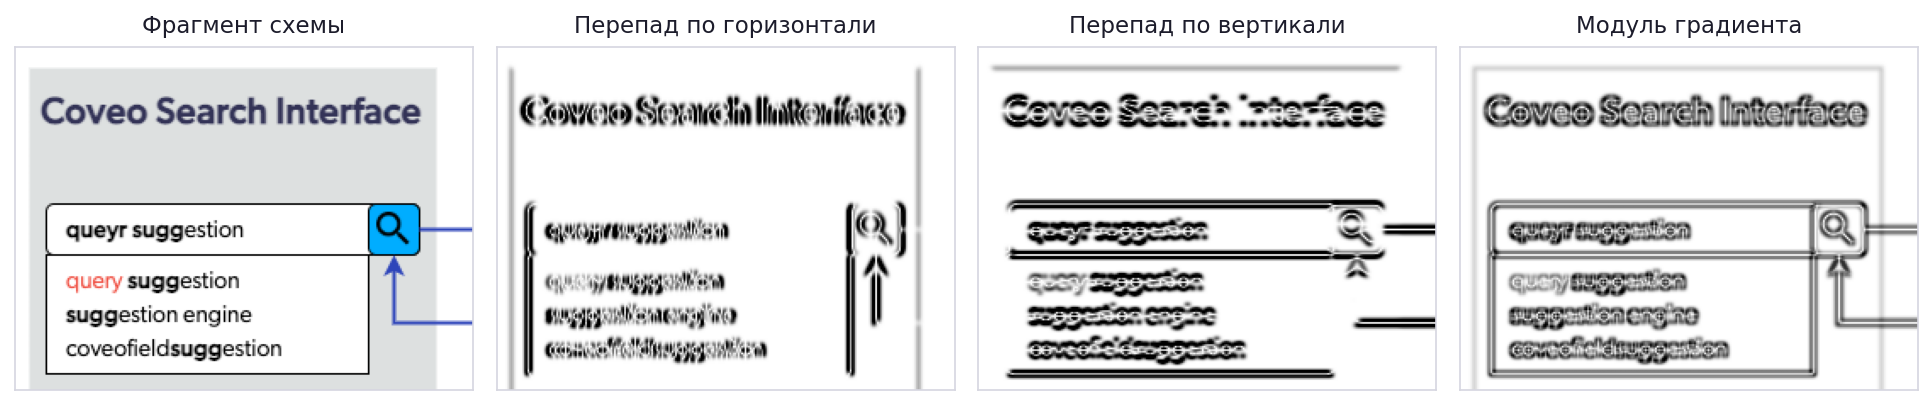
Canny — це наступний крок, який перетворює розмиту карту перепадів на чіткі контури. Собель-бо відповідає чесно, але неохайно. Навколо кожної межі в нього виходить широка смуга, де перепад «досить сильний», і незрозуміло, де саме проходить лінія. Canny спершу трохи розмиває картинку, щоб окремі шумні пікселі не вдавали з себе межі, потім іде вздовж кожної такої смуги й лишає в ній тільки гребінь, тобто ті точки, де перепад сильніший, ніж у сусідів упоперек межі. Усе інше гаситься, і смуга худне до ниточки. А далі точки з перепадом вищим за верхній поріг беззастережно оголошуються межею, нижчі за нижній — відкидаються, а ті, що посередині, лишаються, тільки якщо вони торкаються вже прийнятих. Завдяки цьому слабка ділянка лінії, яка сама по собі не пройшла б відбору, виживає, бо тримається за сильну, а самотня цятка шуму такої самої яскравості зникає, бо їй нема за що триматися. На виході замість сірої карти маємо чорно-білий малюнок з тонких зв'язних ліній.
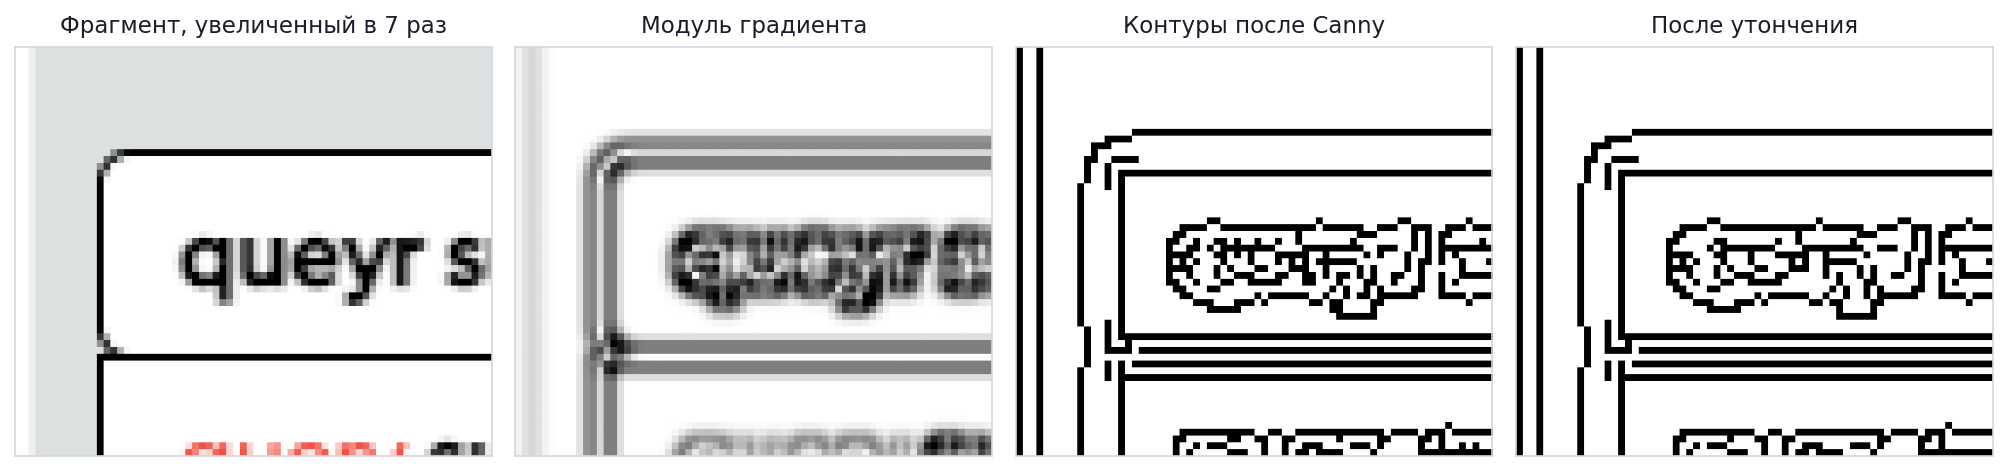
Дрібні зв'язні компоненти площею менш ніж 100 пікселів відкидалися як текст. Потім морфологією шукалася «сітка» схеми. Вона потрібна, щоб зрештою схема мала охайний вигляд. Під час переведення з растру завжди щось «скаче», і треба притягувати до сітки, якщо можливо.
Тут використовуються підходи, які науково називаються ерозією та дилатацією. Конкретно в цьому випадку ще й ядром завширшки cols // 40, яке лишає тільки довгі горизонталі, і ядром заввишки rows // 40 — тільки вертикалі.
Ці два мудрі слова — найпростіші дії над чорно-білою картинкою, і разом вони працюють як сито за формою.
Для ерозії береться «ядро», у нашому випадку смужка заввишки в один піксель і завдовжки в одну сорокову ширини картинки (для зображення в 1024 пікселі це 25 пікселів). Ерозія прикладає цю смужку до кожної точки й лишає точку зафарбованою, тільки якщо зафарбовано все, що під смужкою. Горизонтальна лінія, довша за 25 пікселів, таке випробування проходить, хоча й коротшає з кінців. А от літера, вертикальна лінія завтовшки в кілька пікселів чи цятка шуму зникають повністю, бо смужка в них ніде не вміщається.
Дилатація робить навпаки. Вона зафарбовує точку, якщо під смужкою є хоч один зафарбований піксель, і так відрощує лініям, що вижили, з'їдені кінці. Те, що зникло, вже не повернеться, бо відрощувати нема з чого.
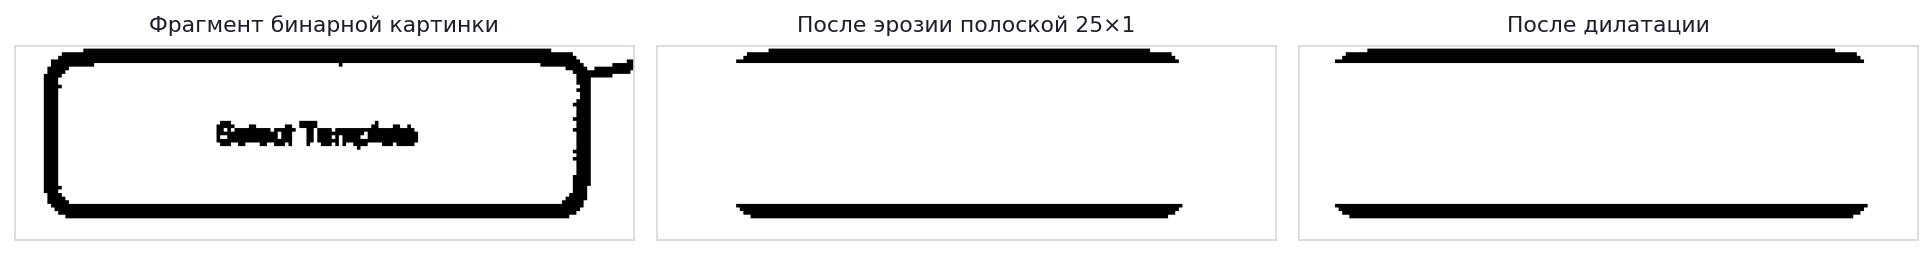
Зрештою на картинці лишаються тільки довгі горизонталі. Потім смужку ставлять вертикально, заввишки в одну сорокову висоти картинки, і в той самий спосіб отримують лише довгі вертикалі. Ділення на сорок замість фіксованої кількості пікселів потрібне, щоб «довге» означало одне й те саме на маленькій і на великій картинці.
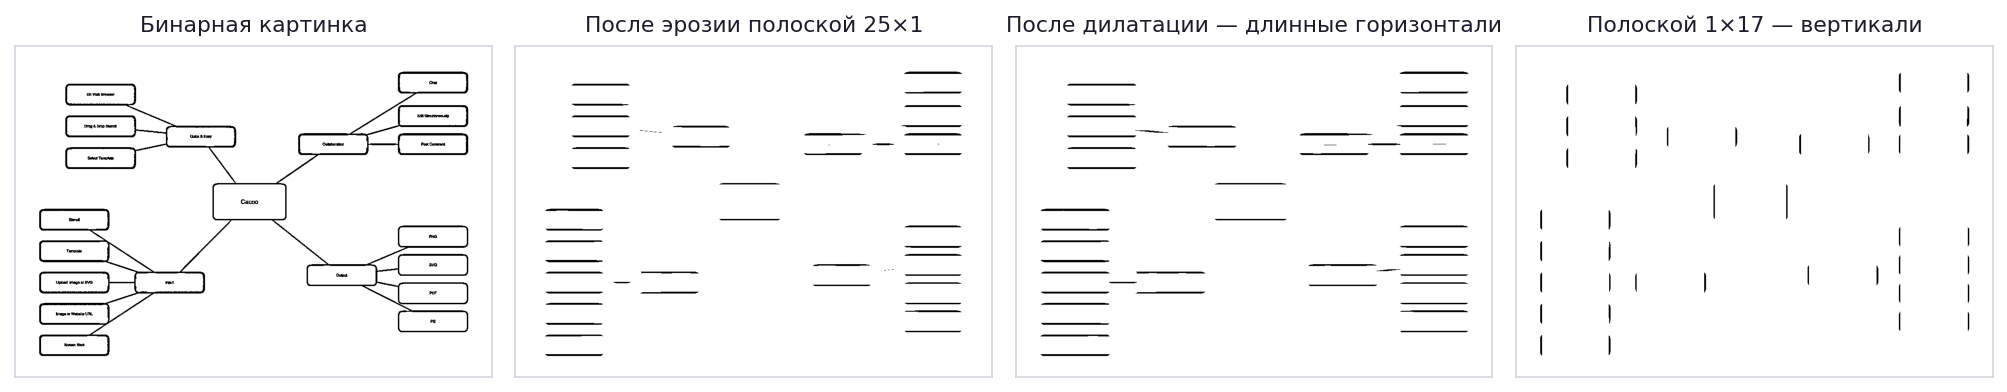
За знайденими координатами сітки йшов прохід пікселями рядок за рядком, який діставав відрізки навіть там, де алгоритм Гафа їх не бачив. Далі — злиття колінеарних відрізків з перевіркою, що розрив між ними не проходить усередині блока і не перетинає порожнечу, довшу за 15 пікселів.
Що за Гаф? Усе просто. Перетворення Гафа — це спосіб знайти на картинці прямі за допомогою голосування. Через одну зафарбовану точку можна провести скільки завгодно прямих, і сама точка не знає, на якій із них лежить. Тому вона голосує за всі одразу. Кожна пряма описується двома числами, кутом нахилу й відстанню від кута картинки, і для всіх можливих пар заводять таблицю лічильників. Точка перебирає кути з кроком, скажімо, в градус, для кожного обчислює, на якій відстані пройшла б через неї пряма з таким нахилом, і додає одиницю у відповідну клітинку. Коли проголосували всі точки, у таблиці видно піки. Якщо сто точок справді лежать на одній прямій, то всі сто віддали голос за ту саму клітинку, а решта їхніх голосів розмазалася по таблиці тонким шаром. Клітинки, де голосів більше за поріг, оголошуються знайденими прямими.
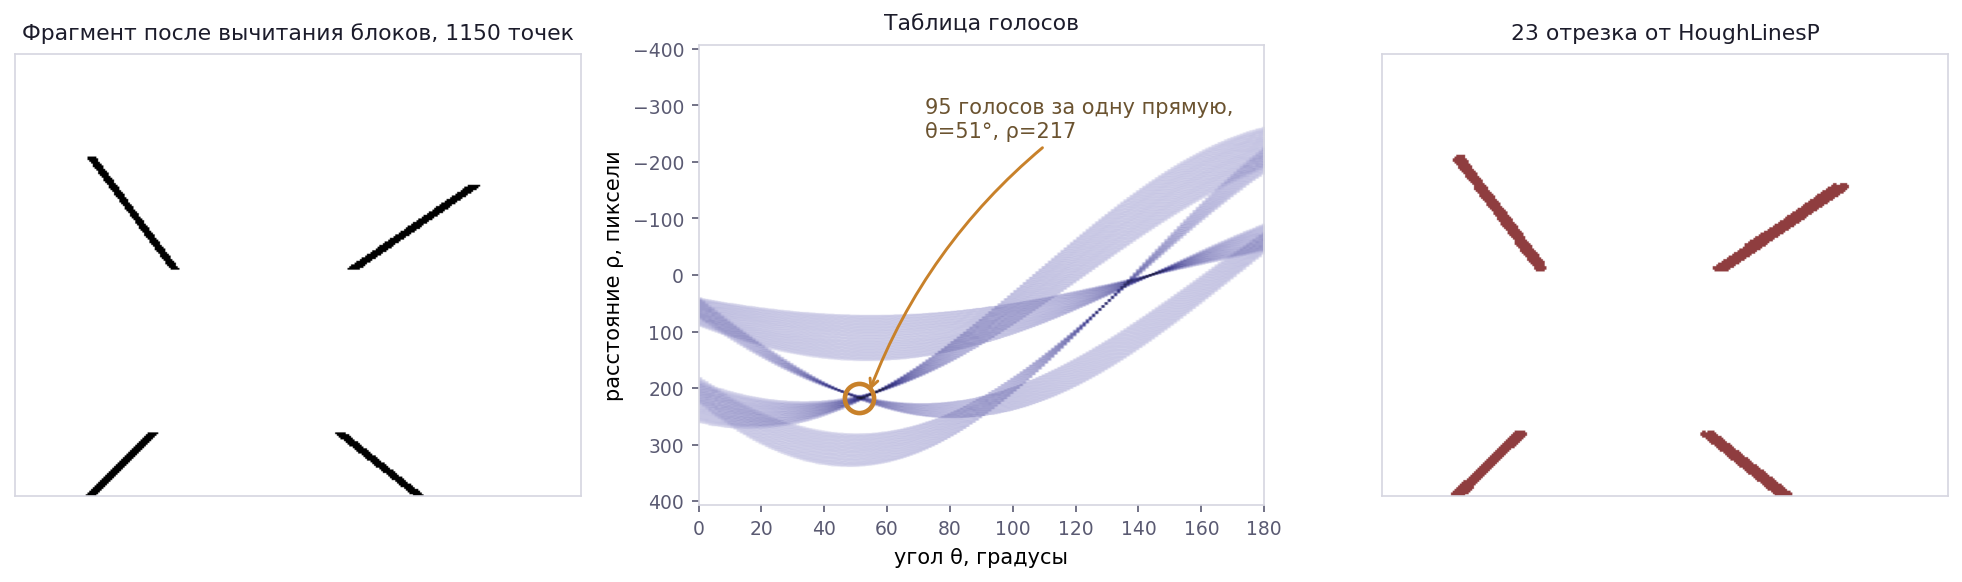
Принадність методу в тому, що йому не заважають розриви. Пунктир або лінія, перекреслена текстом, набирають голоси так само, як суцільна. Слабкість у тому, що короткий відрізок набирає мало голосів і тоне під порогом, а товста чи трохи нерівна лінія ділить свої голоси між сусідніми клітинками й теж може не дотягти. Саме в таких місцях прохід сіткою рядок за рядком і знаходив те, чого Гаф не бачив.
Класичний варіант повертає нескінченні прямі, без початку й кінця. Тому в OpenCV зазвичай беруть HoughLinesP, імовірнісну версію. Вона голосує не всіма точками, а випадковою вибіркою, і, знайшовши пряму, проходить уздовж неї картинкою та повертає конкретні відрізки з координатами кінців. Параметрів у неї два — мінімальна довжина відрізка й максимальний розрив, який ще вважається тією самою лінією.
І нарешті синтез прямокутників — перебір пар горизонталей і пар вертикалей з перевіркою, що всі чотири кути зійшлися:
G = min(w, h) * 0.15
d_tl = dist(v1['p1'], h1['p1'])
d_bl = dist(v1['p2'], h2['p1'])
d_tr = dist(v2['p1'], h1['p2'])
d_br = dist(v2['p2'], h2['p2'])

if max(d_tl, d_bl, d_tr, d_br) <= G:
    # чотири відрізки зійшлися кутами — вважаємо це прямокутником
На виході був SVG з ліній і прямокутників — вектор, який, як і раніше, не був схемою. Ні підписів, ні зв'язків, ні знання про те, що блок A з'єднаний з блоком B.
Тож здебільшого я його поховав.
З цього прототипу в нинішній код перейшли три прийоми — маскувати знайдені блоки перед пошуком ліній, перевіряти, що розрив між відрізками не перетинає блок, і прилипати кінцями до меж блоків. Решту довелося викинути.
Контур замість чотирьох відрізків
Наступна думка очевидна, коли вже набив ґулі на попередній: замкнена фігура й так надходить із findContours цілою, збирати її з відрізків нема потреби.
Нинішній детектор робить так:
gray    = cv2.cvtColor(image, cv2.COLOR_BGR2GRAY)
blurred = cv2.GaussianBlur(gray, (3, 3), 0)
thresh  = cv2.adaptiveThreshold(blurred, 255, cv2.ADAPTIVE_THRESH_GAUSSIAN_C,
                                cv2.THRESH_BINARY_INV, 11, 2)
canny   = cv2.Canny(blurred, 30, 100)
binary  = cv2.bitwise_or(thresh, canny)
binary  = cv2.morphologyEx(binary, cv2.MORPH_OPEN, np.ones((2, 2), np.uint8))
Для тих, хто бачить код OpenCV уперше, — трохи поясню.
cvtColor переводить картинку у відтінки сірого. Колір для пошуку меж не потрібен, а одне число на піксель обробляти простіше, ніж три. BGR у назві — не одруківка: OpenCV з історичних причин зберігає канали в порядку «синій, зелений, червоний».
GaussianBlur трохи розмиває картинку віконцем три на три, щоб зерно стиснення й поодинокі шумні пікселі потім не перетворилися на хибні межі. Нуль наприкінці означає «силу розмиття добери сам за розміром вікна».
adaptiveThreshold — адаптивний поріг. Звичайний поріг порівнює кожен піксель з одним числом на всю картинку й ламається, якщо тло десь світліше, а десь темніше. Адаптивний порівнює піксель із середнім значенням у його околі, тут це квадрат 11 на 11, причому ближчі сусіди важать більше за дальших. Якщо піксель темніший за це середнє хоча б на 2, він вважається «чорнилом». BINARY_INV перевертає результат: чорнило стає білим, тло — чорним. Так заведено в OpenCV, де біле означає об'єкт, а чорне — порожнечу.
Далі вже знайомий Canny з нижнім порогом 30 і верхнім 100. bitwise_or об'єднує дві картинки — піксель білий, якщо він білий хоча б на одній із них. І останнє, morphologyEx — морфологічне відкриття, та сама ерозія з дилатацією, що й у старому прототипі, тільки ядром два на два. Усе, що дрібніше за такий квадратик, зникає, решта зберігає форму.
Часто пишуть, що адаптивний поріг бере заливки. З вікном 11 на 11 це не зовсім так: усередині рівної заливки піксель дорівнює середньому за сусідами, і поріг він не проходить. Насправді поріг бере штрихи, текст і контрастні краї заливок, Canny добирає слабкі межі там, де заливки немає, а морфологічне відкриття прибирає пісок.
Потім закриття ядром 5×5 затягує розриви, і отриманою картинкою проходить findContours.
Що за закриття? Далі треба залатати рамки. Після порога й Canny в них майже завжди лишаються дірочки в один-два пікселі. Десь лінія була блідою, десь її перебило згладжування. Оку це непомітно, а для алгоритму рамка з дірочкою — уже не замкнена фігура, її внутрішня частина зливається з тлом ззовні. Тому всі лінії спершу потовщуються на кілька пікселів у кожен бік, і дрібні розриви при цьому зростаються. Потім лінії знову худнуть на стільки ж, але місця, що зрослися, вже не розходяться. Саме це й називається морфологічним закриттям, ядро в нього п'ять на п'ять, тож заростають розриви до чотирьох пікселів. Після цього до роботи береться findContours, який проходить межею кожної області на картинці й повертає її цілою, готовим списком точок уздовж периметра. Ось це і є ті самі замкнені фігури, які старий прототип насилу збирав із чотирьох відрізків.
Далі кожен контур класифікується за набором метрик, як-от круглість 4πS/P², заповненість «площа до площі описаного прямокутника», співвідношення сторін, гладкість як кількість точок контуру на одиницю периметра, кількість вершин після approxPolyDP і після опуклої оболонки, відхилення кутів від 90°.
Якщо в опуклої оболонки 3 вершини — це трикутник. Якщо круглість більша за 0,8 і сторони майже рівні — хай це буде коло. Якщо круглість більша за 0,62 і контур гладкий, то пробуємо знайти в цьому еліпс чи циліндр. Чотири вершини, заповненість менша за 0,62, сторони мінімального прямокутника — від 0,55, то назвемо це ромбом, а якщо кути відхиляються більш ніж на 18 градусів, то паралелограмом. В усіх інших випадках назвемо фігуру прямокутником.
Очевидно, що для таких правил правильніше було б використати ML, але це наступний етап колись у майбутньому.
Окрема перевірка відрізняє циліндр (значок бази даних) від еліпса. У циліндра ширина маски в середніх рядках майже стала, тому беруться рядки від чверті до трьох чвертей висоти, і якщо розкид ширини менший за 10%, це циліндр. Так собі критерій, але для прототипу згодиться. Знову ж таки, це чудовий напрям для ML.
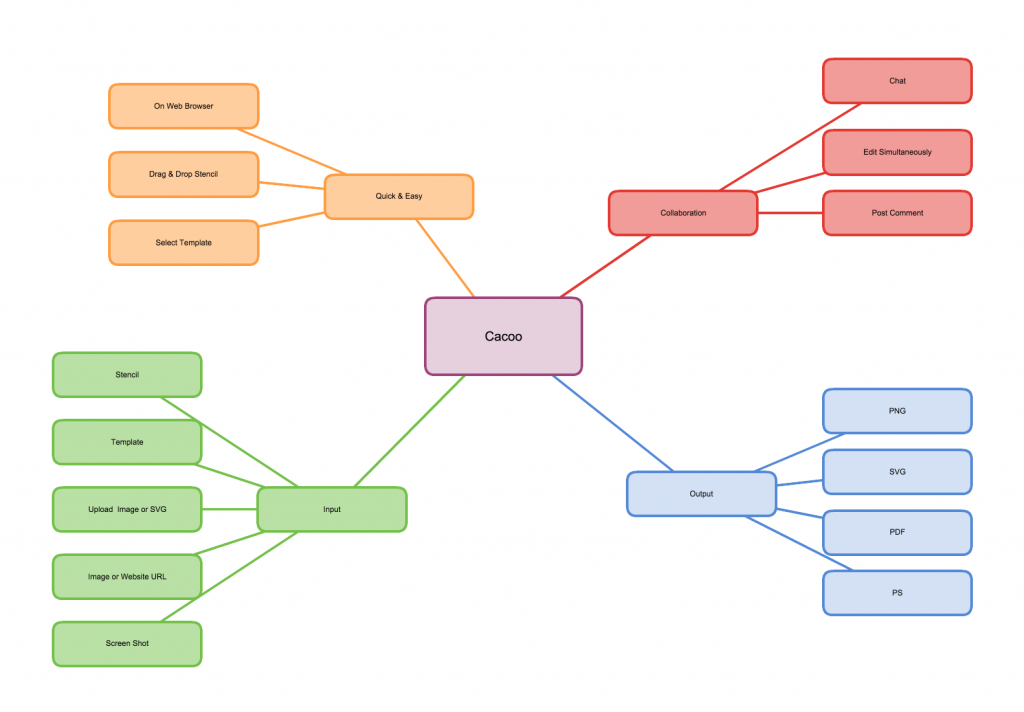
Можна показати на двох тестових картинках. Перша — проста mind map з Cacoo, 1024×712 — двадцять блоків із заливкою, заокруглені кути, лінії без стрілок.
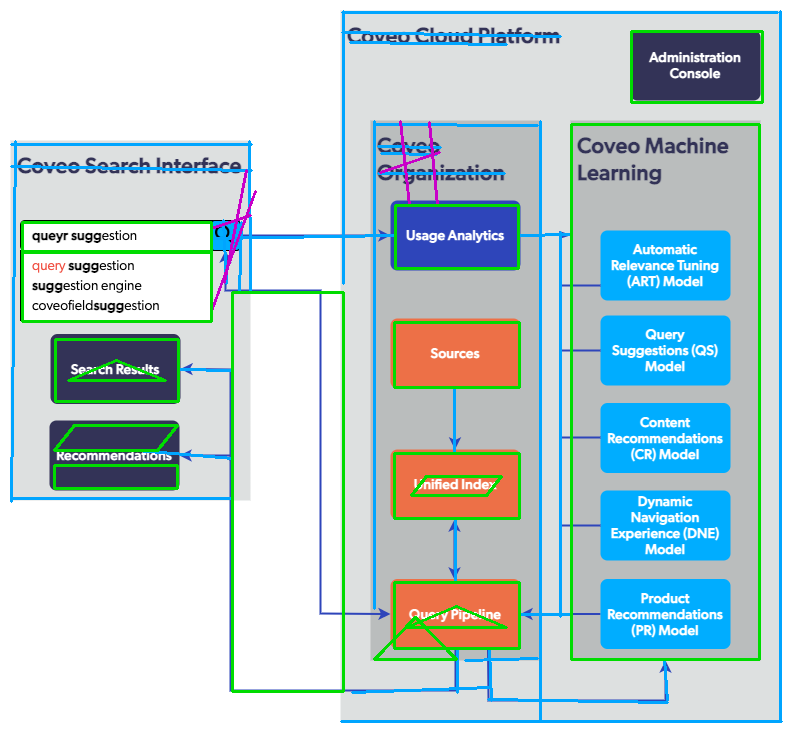
Друга — схема архітектури Coveo, 791×731 — вкладені контейнери, блоки з багаторядковими підписами, стрілки зі зламами й тло в контейнерів.
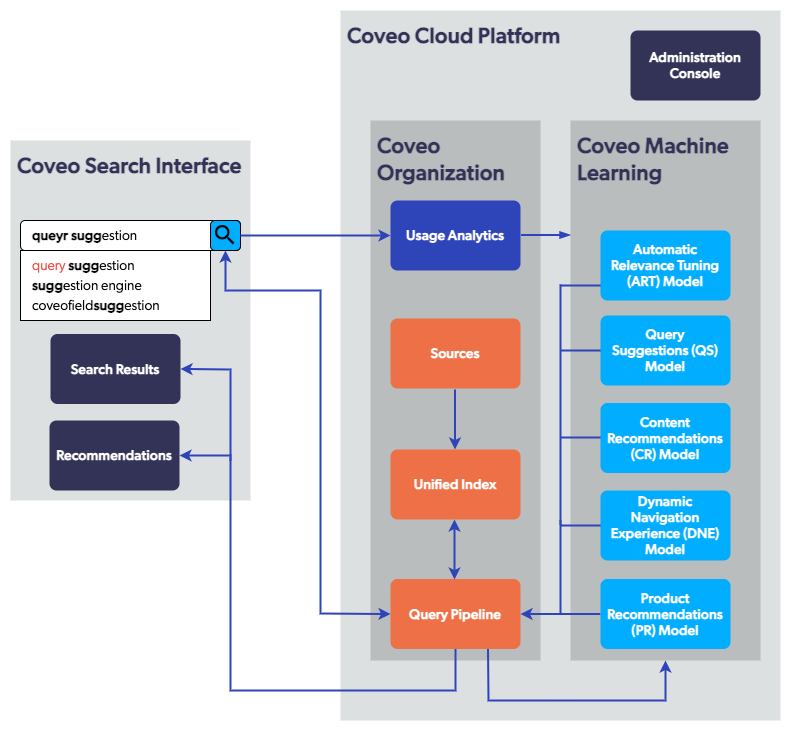
На першій детектор знаходить 23 фігури за 7 мс, на другій — 16 фігур за 4 мс. Це на Core Ultra 9 285K, без відеокарти й без мережі. Не те щоб це було щось особливе, просто все подальше, що пов'язане з моделлю, працює на три-чотири порядки повільніше.
Дублікати прибираються за IoU з порогом 0,5, бо одна рамка зазвичай дає і зовнішній, і внутрішній контур.
Дірки замість рамок
Я перевірив зв'язність на схемі Coveo. Після морфологічного закриття вся діаграма — одна зв'язна компонента. Рамка зовнішнього контейнера, рамка вкладеного блока, стрілки між ними — усе це компонента номер один із вісімнадцяти. Лінії торкаються рамок, рамки торкаються рамок, і картинка склеюється в один потворний блоб.
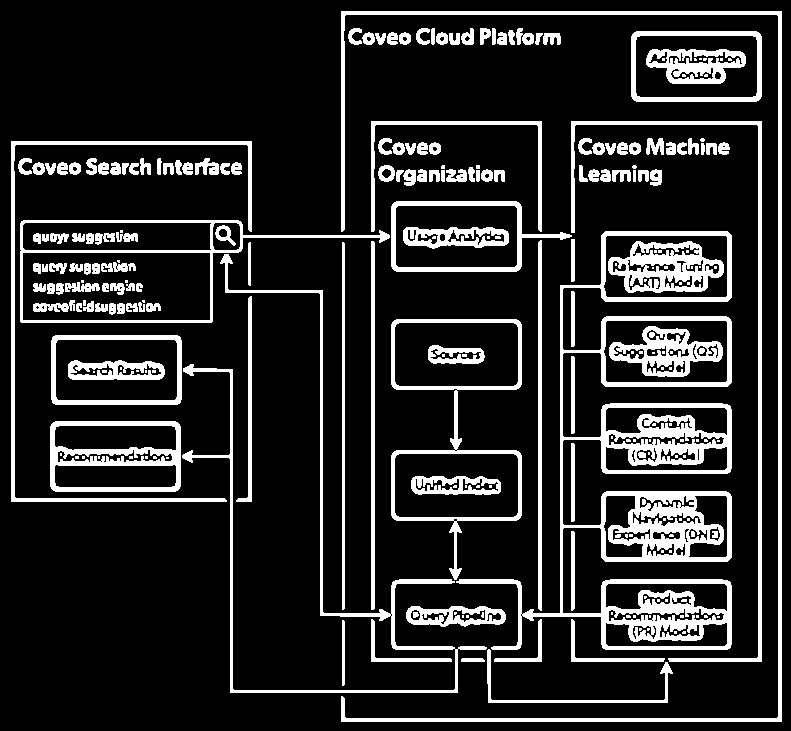
Отже, окремих зовнішніх контурів у блоків немає. Те, що доходить до класифікатора, — це дірки. Біла внутрішня частина блока, сіре тло контейнера за винятком усього вкладеного. Тому координати блока завжди трохи менші за видимі. Блок Sources на картинці займає приблизно (390,318)–(521,391), а детектор повертає (394,322)–(519,387).
Із цього випливають збої, які я до цієї перевірки бачив, але не вмів пояснити.
По-перше, найбільший контейнер зникає.
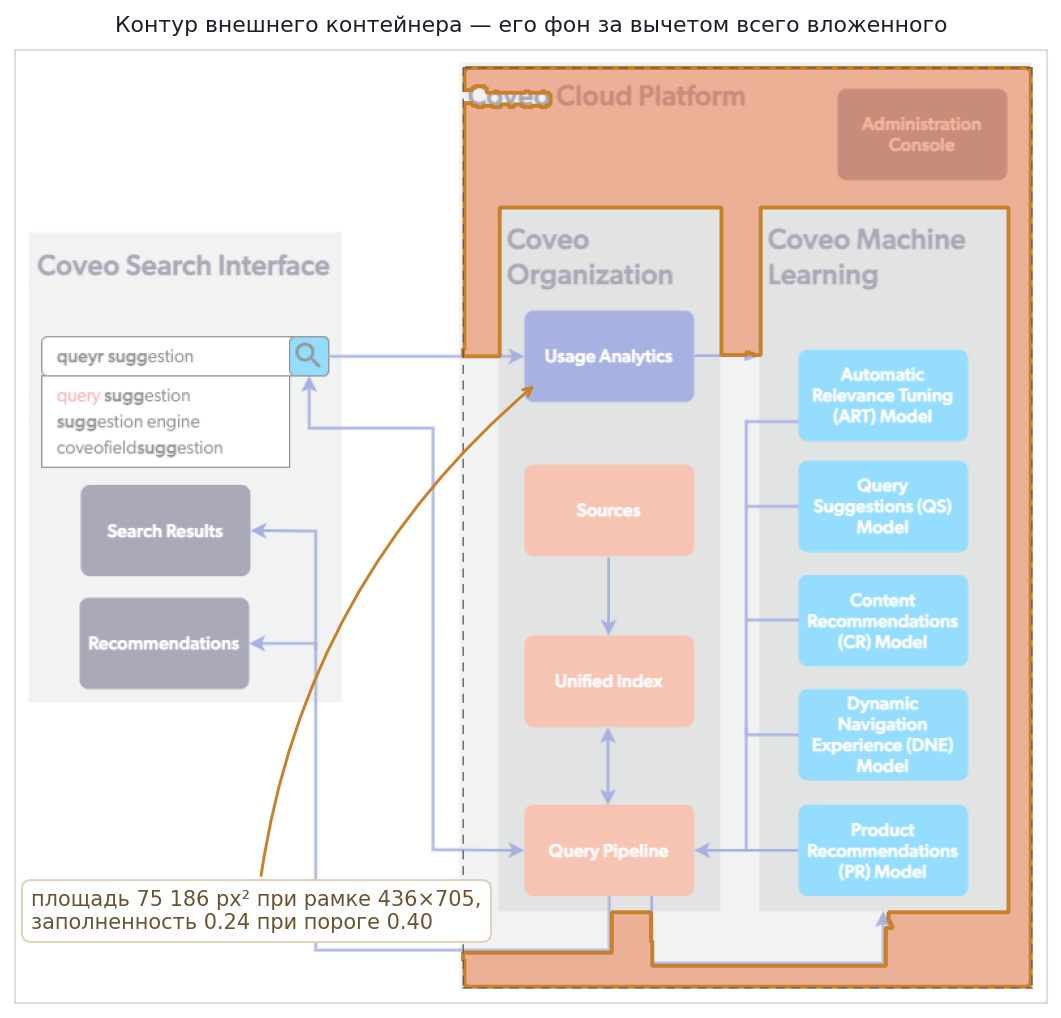
Його дірка — це тло за винятком вкладених блоків і ліній. Площа такої фігури — 75 186 px² за описаного прямокутника 436×705, тобто заповненість 0,24 за порога 0,40. Контейнер відкидається як надто дірявий.
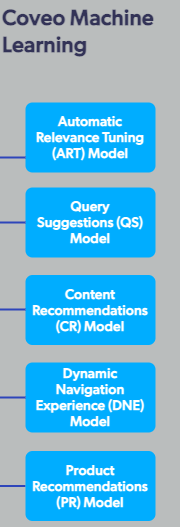
По-друге, блоки з довгим текстом зникають. У п'яти блакитних блоків у колонці Coveo Machine Learning підписи на три-чотири рядки дотягуються до країв і ріжуть дірку на смужки. У списку контурів замість п'яти блоків лежать шматки їхньої внутрішньої частини — смужки 123×28 із заповненістю 0,5–0,64 і п'ятьма вершинами. Перевірка «чотири вершини або опуклий із заповненістю понад 0,72» їх не пропускає.
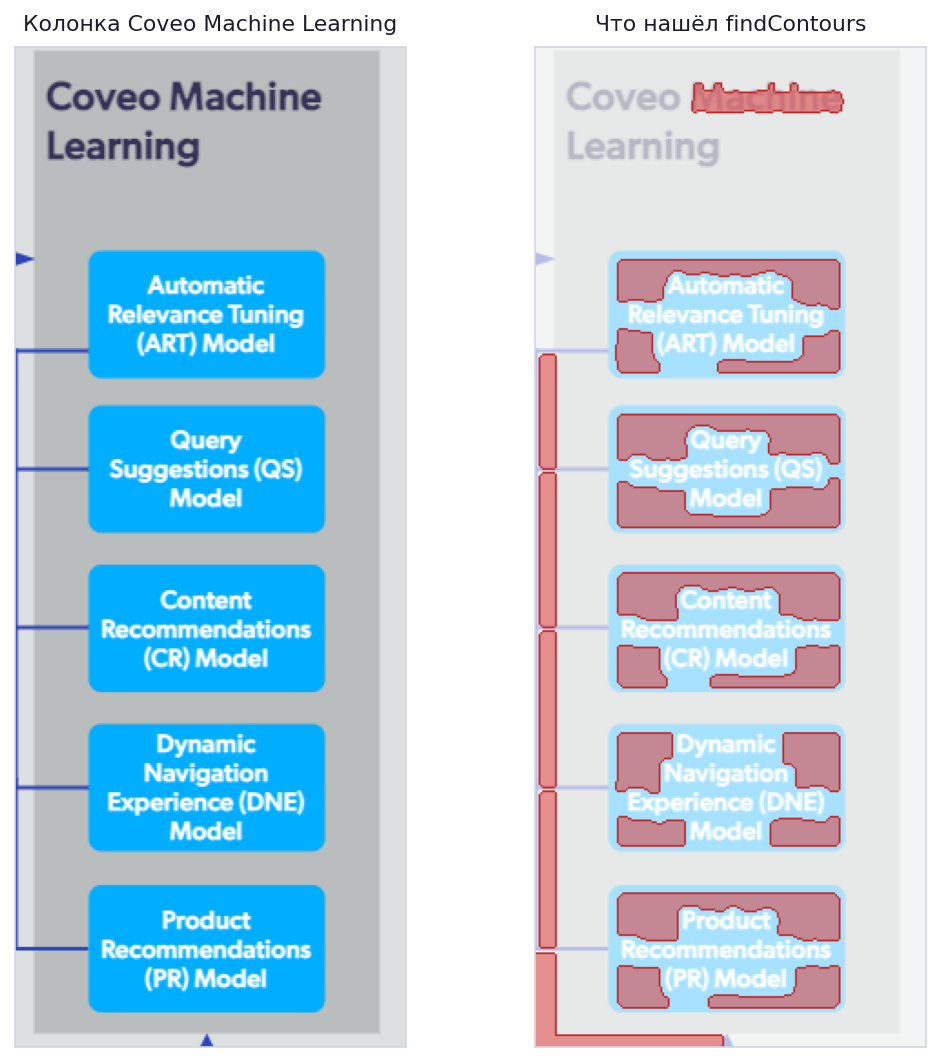
findContours повернув у цьому місці. Це шматки внутрішньої частини блоків, розрізані рядками підпису; контуру самої рамки серед них немає в жодного з п'яти блоків.По-третє, з'являються фігури, яких немає. Дірка між трьома лініями, що перетинаються, — трикутник за всіма метриками, і класифікатор записує її як трикутник. На mind map таких три, на схемі Coveo ще три плюс два паралелограми, що склалися з тексту.
Підсумок для схеми Coveo... 16 знайдених фігур — 11 справжніх блоків, три фантомні трикутники й два паралелограми. Плюс втрачено п'ять блакитних блоків і зовнішній контейнер.
На mind map результат помітно кращий — 20 блоків із 20 плюс три фантомні трикутники між лініями, що розходяться.
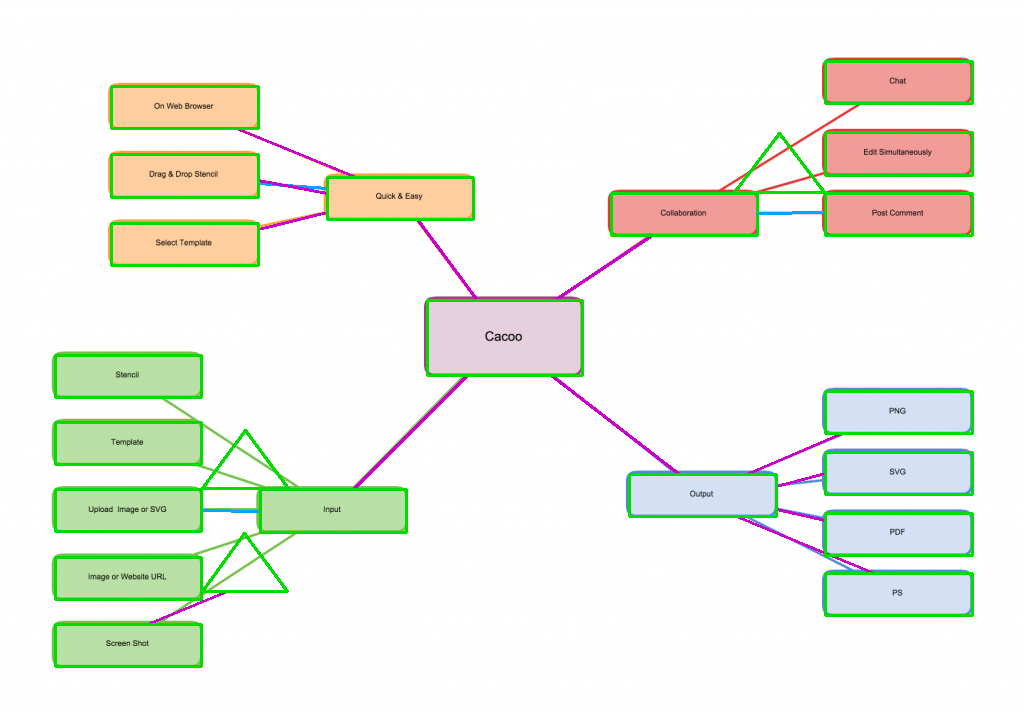
Підкручування порогів цього не виправляє. Потрібен детектор, який шукає блок за заливкою, а не за межею. Заливка в блока однорідна, і текст усередині її не розрізає. Мій старий прототип, до речі, вмів шукати блоки за насиченістю в HSV — я прогнав його на цій самій картинці, і він знайшов саме три блоки, усі темно-сині. Тож просто повернути його замало.
Сегментація нейромережею
Якщо класичні контури ламаються на складних картинках, логічно спробувати модель сегментації. І я спробував дві.
Mask R-CNN через detectron2 з вагами COCO. Модель навчена на фотографіях і на схемі шукає котів, стільці й людей. Нічого корисного на діаграмах вона не дала, і в залежностях проєкту detectron2 так і не з'явився.
Segment Anything. Ця сегментує що завгодно, зокрема й схеми. Проблема якраз протилежна. SAM повертає всі області підряд і не знає, що таке «блок діаграми». Для однієї картинки це сотні масок — рамки, заливки, літери, шматки стрілок.
Тому поверх масок стоїть набір фільтрів.
Фільтр stability_score, predicted_iou має поріг 0,88 і відсікає непевні маски, які викидаються зовсім. Фільтр за площею відсікає надто дрібні об'єкти, на жаль, разом із текстовими блоками (налаштування — 0,2% від площі картинки). Також відсікаються різноманітні повернуті області, бо зазвичай на діаграмах таких немає (так, це спірно). Нахил до 10 градусів просто притискається до осей — схеми малюють за сіткою, і кілька градусів зазвичай означають згладжування під час растеризації, а не задум автора.
Усе, що не пройшло фільтрів, не викидається, а позначається як фрагмент. З прапорцем --embed-fragments фрагменти потрапляють у .drawio картинками в base64. Іконку з трьох кривих інструмент однаково не перетворить на фігуру, тож хай вона лишиться іконкою, що стоїть у потрібному місці.
Чого не дає комп'ютерний зір
Після детектора в мене є координати, форми й вкладеність. Немає тексту, напрямку стрілок, підписів на зв'язках і кольорів, названих словами.
Класичний OCR тут вимагає чимало мороки. Текст дрібний, лежить поверх кольорової заливки, у блоці буває три рядки з різним вирівнюванням. А для стрілок класичного рішення немає взагалі — наконечник треба шукати окремим детектором і зіставляти з кінцем лінії.
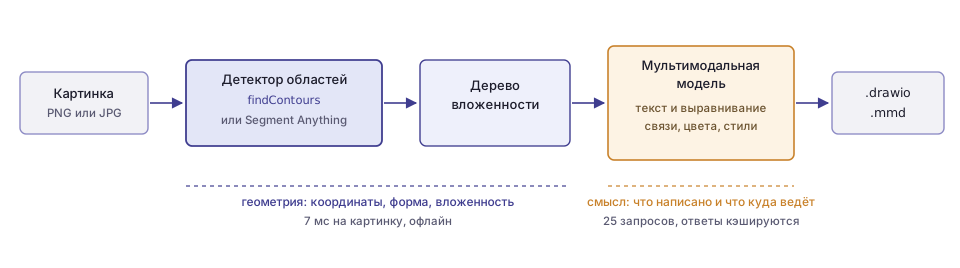
Тому семантику я віддав мультимодальній моделі. У моєму випадку я використав моделі Gemini, але різниці особливої немає, згодиться будь-яка. Проте віддав не всю задачу — просити в моделі піксельні координати блоків не надто вдала ідея, бо перевірити їх нема чим, там часто галюцинації, а комп'ютерний зір видає ті самі координати точно, відтворювано й безплатно. Поділ вийшов такий: геометрія — CV, зміст — модель.
Три запити на одну картинку
Зрештою до моделі надсилаються три запити.
Перший — OCR, і надсилається кроп одного блока. Тобто фрагментик картинки, для схем це часто якийсь блок. Окрім тексту, модель повертає, як вирівняно текст відносно блока, і по горизонталі, і по вертикалі. Це потім переноситься в draw.io.
Другий запит — зв'язки. Надсилається вся картинка, а від моделі ми чекаємо на масив із (src, dst, direction, label, style, color). Третій запит — стилі блоків. Кожен елемент — (border color, bg color, border style, border width).
Для другого й третього запитів картинку спершу розмічають. Поверх копії зображення малюються знайдені фігури, і в центрі кожної червоним пишеться її номер. Модель отримує зображення та список на кшталт Box 7: "Usage Analytics" at (55,339)-(178,401) і відповідає номерами, а не описами. Це знімає задачу зіставлення відповіді з геометрією.
Промпт для зв'язків має такий вигляд:
Find all connections (arrows, lines) between boxes. Return a JSON array where each item has:
- "src": source box ID (integer)
- "dst": destination box ID (integer)
- "direction": "forward", "backward", "bidirectional", or "none"
- "label": text label on the arrow/line ("" if none)
- "style": "solid", "dashed", or "dotted"
- "color": one of [black, white, gray, red, green, blue, ...]
Наскільки це працює. На mind map модель повернула 19 зв'язків — якраз стільки, скільки ребер у дереві з 20 вузлів, і топологія збіглася з картинкою. Центральний вузол з'єднаний із чотирма гілками, кожна гілка — зі своїм листям. Усі зв'язки з direction: none і порожніми підписами, що теж правильно: стрілок і підписів на цій схемі немає.
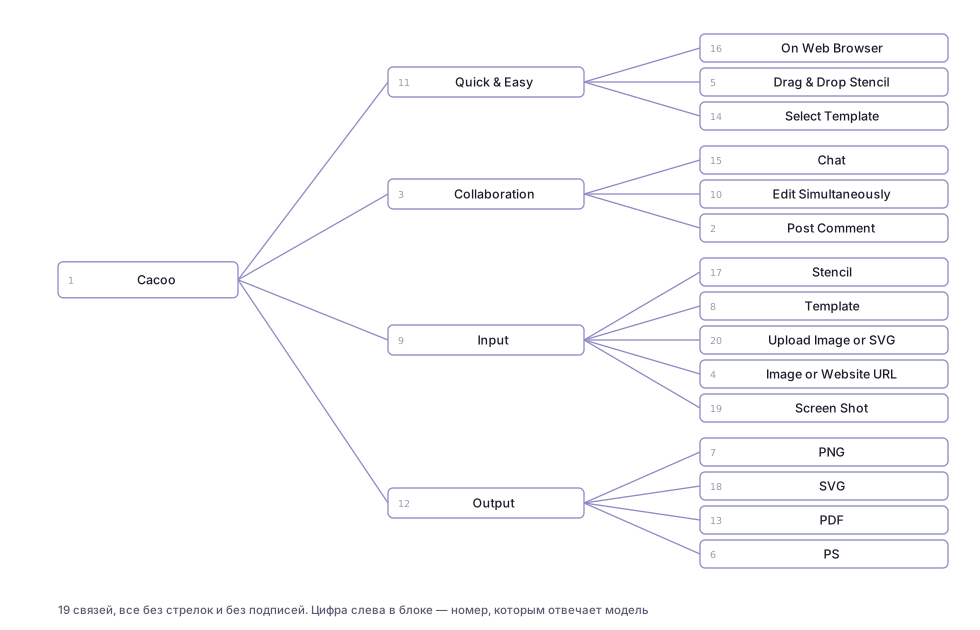
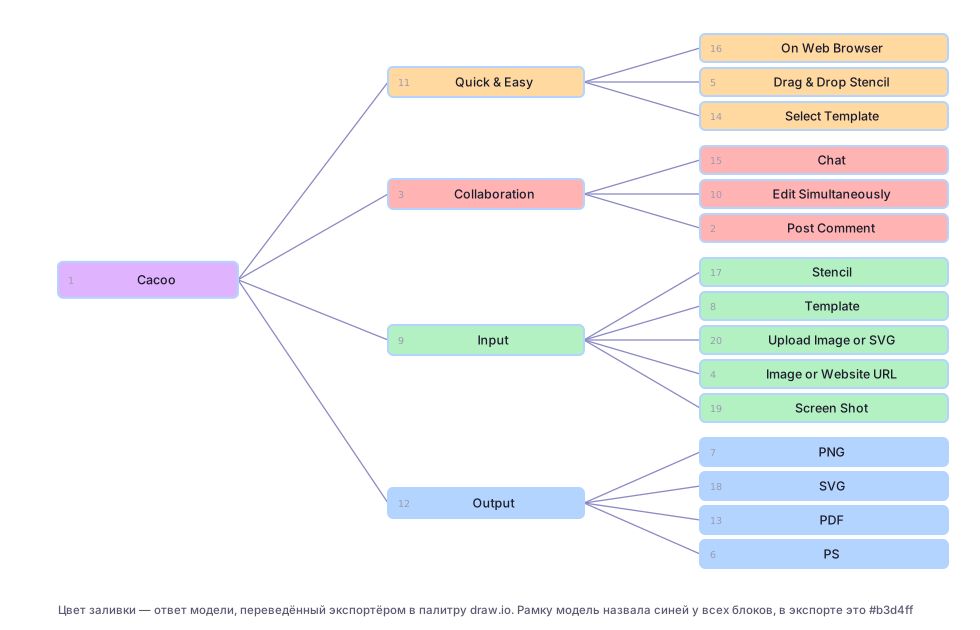
Зі стилями цікавіше. Модель повернула стилі для 21 фігури з 23, і набір кольорів тла назвала точно: 6 зелених, 5 синіх, 4 червоні, 4 помаранчеві і 1 фіолетовий — саме те, що намальовано, двадцять блоків по гілках. Двадцять першій фігурі дістався білий. А колір рамки вона назвала синім у всіх 21 фігури, хоча в кожної гілки схеми рамка свого кольору. Тобто заливку, яка займає велику площу, модель бачить, а тонку рамку — домислює.
OCR читає текст дослівно, разом з одруківками автора. На схемі Coveo в полі пошуку написано «queyr suggestion», і саме це потрапило в підпис блока. Для реконструкції так і треба.
Вирівнювання модель теж повертає, і воно доходить до draw.io. У контейнерів на схемі Coveo підпис стоїть угорі ліворуч, модель повернула align: left, valign: top, і в .drawio клітинка отримала align=left;verticalAlign=top.
Ціна. На mind map із 23 знайденими фігурами це 23 запити OCR плюс два загальні, тобто 25 звернень до API на одну картинку. Тому всі три кроки кешуються в temp/ — повторний прогін тієї самої картинки не витрачає жодного запиту. Складати всі кропи в один запит я поки не взявся, хоча це перше, що треба зробити для швидкості.
Навіщо потрібна вкладеність
Для кожного блока шукається найтісніший блок, що його охоплює, — він і стає батьківським, а обхід у ширину від коренів роздає глибину. Дерево обчислюється за один прохід і коштує недорого.
Головний споживач дерева — OCR. У кроп контейнера потрапляють усі вкладені блоки зі своїми підписами, і модель прочитає їх усі та склеїть в один рядок. Тому перед запитом області «дітей» у кропі забілюються, і модель бачить лише власний підпис контейнера.
На схемі Coveo цей механізм не спрацював — із причини, описаної в розділі про дірки. П'ять блакитних блоків не знайшлися, дітей у контейнера немає, маскувати нічого, і в запит пішов ось такий кроп:
А ще вкладеність поки не доходить до експорту. У .drawio всі клітинки лежать з parent="1", у Mermaid немає subgraph. Дерево існує лише заради чистого OCR, хоча дані для справжньої вкладеності вже обчислено.
Лінії, які нікуди не ведуть
Геометричний пошук зв'язків вмикається прапорцем --enable-connections і влаштований так.
Спершу з бінарної картинки віднімаються блоки. Листові закриваються повністю із запасом 8 пікселів, а контейнери — тільки смугою вздовж рамки завширшки 14 пікселів, інакше разом із контейнером зникнуть усі зв'язки всередині нього. Рештою картинки проходить HoughLinesP (пам'ятаєте, що це таке? прогорніть угору, тепер уже не забудете), відрізки діляться на горизонтальні, вертикальні й діагональні з допуском 5 градусів, колінеарні зливаються з перевіркою, що розрив не проходить через блок. Далі відрізок перевіряється на покриття. Уздовж нього беруться пікселі вихідної картинки, і якщо зафарбовано менш ніж 4%, відрізок вигаданий. Кінці прилипають до меж блоків у радіусі 60 пікселів, дублікати прибираються.
На mind map зрештою лишається 15 відрізків (3 горизонтальні та 12 діагональних), на схемі Coveo — 39 (19 горизонтальних, 14 вертикальних, 6 діагональних). На накладеннях вище це бузкові й блакитні лінії, і геометрія в них правильна: лінії йдуть від краю блока до краю блока.
Водночас у .mmd і .drawio ці лінії не потрапляють. Зв'язки в експорті повністю від моделі, а результат Гафа малюється лише в налагоджувальні картинки, і це головний незакритий пункт проєкту. Два джерела доповнюють одне одного ідеально: лінії дають факт з'єднання й точки кріплення, модель — напрямок, підпис і стиль. Зараз, якщо модель вигадає зв'язок, якого на картинці немає, перевірити його нема чим — хоча дані для перевірки вже лежать у сусідній змінній.
Mermaid і draw.io
Експорт іде одразу у два формати, і вони розв'язують різні задачі.
Mermaid зберігає топологію й втрачає координати. Розкладку він робить сам. Форма вузла кодується синтаксисом, стилі — окремими директивами:
flowchart TD
    box1["Cacoo"]
    box9["Input"]
    box17[("Stencil")]
    box1 --- box9
    box9 --- box17
    style box1 fill:purple,stroke:blue,stroke-width:2px
Draw.io зберігає все інше. Це mxGraphModel з піксельними координатами вихідної картинки, тож результат лягає поверх оригіналу. Клітинка одного блока має такий вигляд (переноси рядків мої, у файлі це один рядок):
<mxCell id="box7" value="Usage Analytics"
        style="rounded=0;whiteSpace=wrap;html=1;fillColor=#b3d4ff;strokeColor=#333333;
               strokeWidth=2;dashed=0;align=center;verticalAlign=middle;"
        vertex="1" parent="1">
  <mxGeometry x="55" y="339" width="123" height="62" as="geometry" />
</mxCell>
Колір модель називає словом зі списку з дванадцяти назв, а експортер перетворює слово на конкретний пастельний відтінок. yellow перетворюється на #fffacc, cyan перетворюється на #b3f0f0. Тому палітра на виході схожа на вихідну, але не збігається з нею. Ось вихідна схема та її реконструкція:
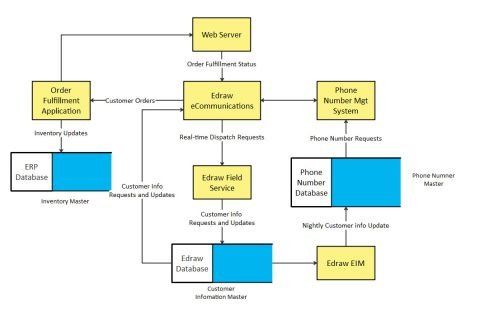
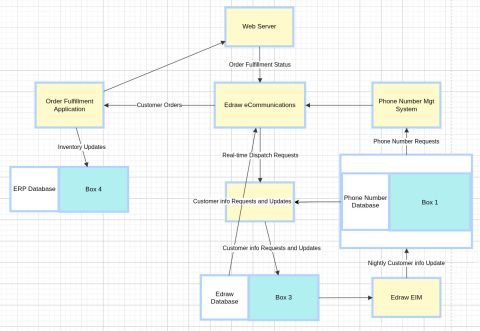
Підписи, стрілки й розташування відновилися, а значки баз даних розпалися. Двоколірний значок — біла ліва частина й блакитна права — дає два окремі контури, і права половина лишається прямокутником без тексту, тобто «Box 4» поруч з «ERP Database». Це той самий випадок, заради якого в SAM-гілці зроблено вшивання фрагментів картинкою.
Друга типова прикраса — накладання підписів на ребрах. Draw.io ставить підпис посередині ребра, і якщо два ребра йдуть поруч, два підписи опиняються в одній точці:
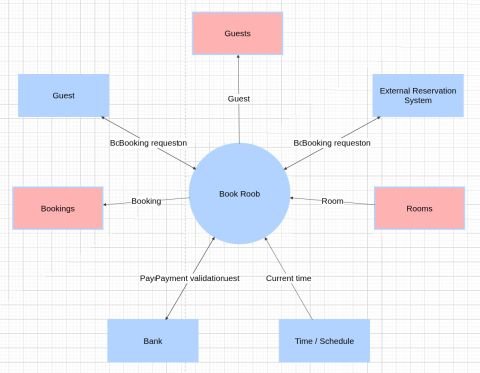
«BcBooking requeston» — це «Booking confirmation» і «Booking request», що наклалися. Лікується розведенням точок кріплення, і геометрія для цього знову ж таки вже є в лініях Гафа.
Граблі, на які я наступив
Кеш із ключем за порядковим номером. Результат OCR кладеться у файл temp/<картинка>_box<N>_ocr.json, де N — номер блока в порядку обходу контурів. Порядок залежить від детектора й від версії OpenCV. Коли я розклав моноліт на модулі, нумерація з'їхала, а кеш лишився. Сьогодні, поки писав статтю, я це й побачив. У кропі diag1_box11.png написано «On Web Browser», а в сусідньому diag1_box11_ocr.json — «Quick & Easy». Уся розмітка з'їхала на сусідні блоки, і експорт став нісенітницею, хоча й детектор, і модель відпрацювали правильно. Ключем має бути вміст кропа, скажімо його хеш разом із координатами.
Кешування помилок. Якщо запит упав, у кеш пишеться {"text": ""}, і наступний прогін бере цю порожнечу як готову відповідь. Після проблем із ключем чи мережею доводиться вручну видаляти temp/*_ocr.json. Правильніше не писати кеш, коли перехоплено виняток.
Де взяти
Репозиторій: github.com/raliev/diag-vectorizer. Потрібні Python 3.10+, OpenCV і ключ Google AI Studio у змінній GEMINI_API_KEY. Гілка з SAM додатково потребує torch, segment-anything і чекпойнта sam_vit_h_4b8939.pth на 2,5 ГБ, який кладеться в корінь проєкту.
python -m venv .venv
.venv/bin/pip install -r requirements.txt
export GEMINI_API_KEY=...

# звичайний прогін: контури + модель
python diag.py input/diag1.png

# плюс геометричний пошук ліній (поки лише в налагоджувальні картинки)
python diag.py input/diag1.png --enable-connections

# гілка SAM, із вшиванням нерозпізнаних фрагментів картинками
python diag.py input/diag1.png --algorithm sam \
    --sam-checkpoint sam_vit_h_4b8939.pth --embed-fragments
На виході output/<ім'я>.mmd і output/<ім'я>.drawio, у temp/ — кропи, налагоджувальні накладення й кеш відповідей моделі. Насамперед варто відкрити temp/<ім'я>_overlay.png. За ним одразу видно, що детектор знайшов, що пропустив і що вигадав, а це пояснює майже будь-яку дивину в підсумковому файлі.
Що далі
Найближче за користю — звести геометрію й модель в одному місці. Лінії Гафа підтверджують або спростовують кожен зв'язок, який назвала модель, і дають точки кріплення; модель лишає за собою напрямок, підпис і стиль.
Далі — детектор, який шукає блоки за заливкою. Це розв'язує проблему зниклих блоків з довгим текстом, зниклого зовнішнього контейнера і заразом фантомних трикутників між лініями.
Потім — один запит замість двадцяти трьох. Усі кропи йдуть до моделі одним повідомленням або текст читає локальна OCR-модель, а Gemini відповідає лише за стрілки й кольори.
І вкладеність в експорт: parent у mxCell в draw.io і subgraph у Mermaid. Дерево вже обчислено, лишилося його записати.
Що далі, частина друга. Фантазії
Якщо ви дочитали до цього місця, то вже поділюся баченням майбутнього «на повну котушку».
Загалом у мене була ширша ідея AI-інструмента для діаграм, і все, що описано вище, — лише перший крок до неї.
Ідея в тому, що мастер-документом для діаграми — у Confluence чи будь-де ще — слугує текст. Опис може бути (і має бути) доволі докладним, щоб діаграма виходила саме такою, якою її уявляє автор. Саму діаграму при цьому безпосередньо не редагують, редагують лише опис. Точніше, посувати кружечки можна, але після цього система має оновити текст так, щоб генерація з нього давала саме те, що насував користувач.
Діаграма має відповідати опису настільки, наскільки це можливо. Якщо відповідності досягти не можна — умовно, трикутник із трьома тупими кутами намалювати не вийде, — система робить усе можливе й пояснює словами, що не вдалося. Тоді користувач змінює постановку задачі, доки результат його не влаштує.
Але тут є пастка: автор міг натрапити на вдалий результат випадково, своїм кривим текстом. Якщо перегенерувати, вийде щось інше, і не факт, що добре. Тому систему можна попросити скласти за готовою діаграмою такий опис, з якого генератор відтворить її в точності. Він вийде багатослівнішим і багатошаровим, зате надійно фіксуватиме результат. Якими словами і в якому обсязі треба описувати, щоб результат був відтворюваним, — незрозуміло, це одна із задач для дослідження.
Відтоді ви працюєте вже не з діаграмою, а з текстом. Потрібна діаграма — компілюєте текст і отримуєте те, що треба. Причому й текст ви правите не вручну, а через LLM. Просите додати блок — опис змінюється, але так, щоб раптом не змінилося геть усе.
На виході діаграма має бути в об'єктній формі, з якої вже можна отримати і растр (PNG), і вектор (SVG, EPS). Було б чудово ще й подавати на вхід готові діаграми чи шаблони, щоб система брала з них стилі та усталені конвенції — що як зображати.
Загалом, ось такі фантазії. Якщо хтось уявляє, як це реалізувати, — давайте обговоримо.
А тим, що вже готове, — користуйтеся на здоров'я, і якщо можете зробити краще — робіть. Це наблизить нас до справжнього AI-редактора діаграм.
Discussion
Powered by GitHub Discussions — sign in with a GitHub account to join the conversation.