
Зачем это понадобилось
У меня регулярно повторяется одна и та же ситуация. Нужна диаграмма, которая существует только картинкой: скриншот архитектурной схемы из чужой презентации, PNG из старой документации, экспорт из PDF, исходник которого потерян вместе с автором. Поправить в ней надо одну стрелку и две подписи, а перерисовывать приходится целиком.
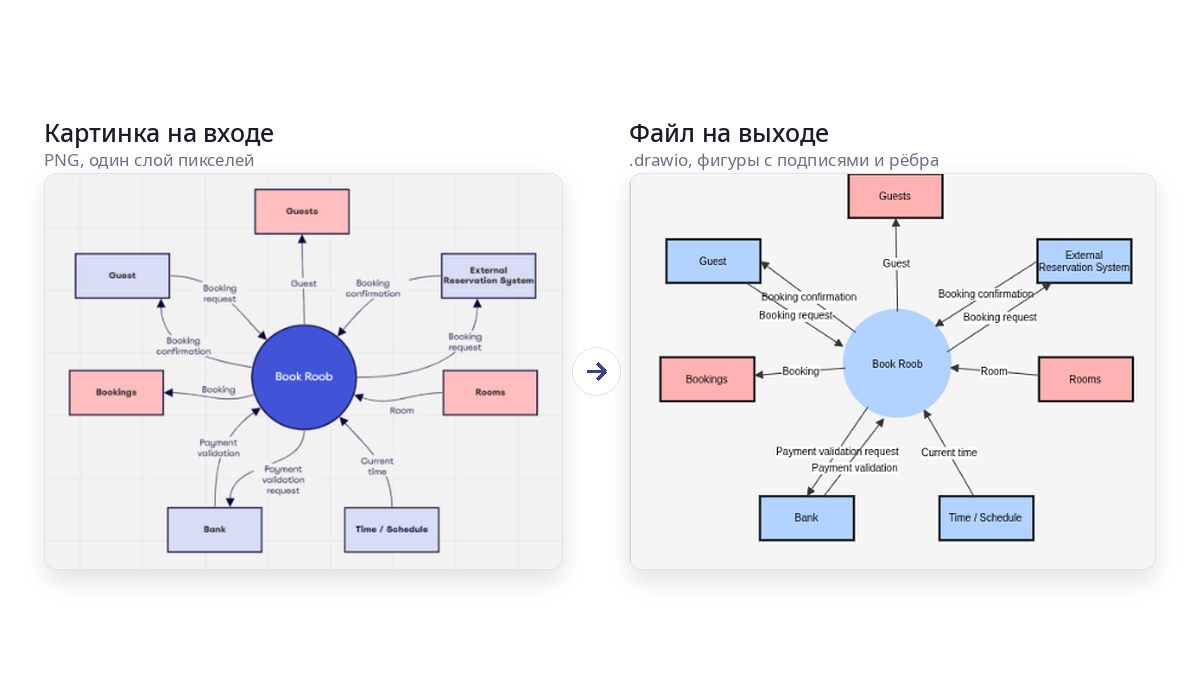
Хотелось инструмента, которому отдаёшь растровое изображение, а получаешь, например,
.drawio, где каждый прямоугольник — прямоугольник, каждая подпись — текст, а каждая
стрелка — ребро между двумя узлами. Дальше правь что нужно.
Как я к этому шёл — от сборки прямоугольников из отдельных отрезков до связки компьютерного зрения с мультимодальной моделью, с разбором того, что ломается по дороге. Все картинки в статье — результат прогона на моей машине, без ручной доводки, поэтому ошибок на них видно достаточно. Код лежит на GitHub, ссылка в конце. Пользуйтесь на здоровье.
В этом решении используется активно AI и компьютерное зрение. Начнём со зрения, потому что всё-таки на входе — картинка.
Трассировщик решает другую задачу
Первое, что приходит в голову, — взять трассировщик: potrace, Image Trace в Illustrator, любой «raster to vector». Такие инструменты дают контуры и кривые Безье. Картинка перестаёт пикселизоваться при увеличении, но редактируемой схемой не становится. Прямоугольник превращается в замкнутую кривую, причём ещё и с артефактами, текст — в набор силуэтов букв, стрелка — в залитую фигуру. Передвинуть узел так, чтобы за ним потянулась стрелка, нельзя, потому что ни узла, ни стрелки в файле нет.
Здесь нужна объектная модель. Список узлов с координатами, размером, формой, подписью и стилем плюс список рёбер с направлением и подписями. Это уже обратная разработка — по финальному рендеру восстановить документ, из которого он получился.
Что восстанавливаем? Границы и форма узлов — на картинке это замкнутые контуры и их геометрия. Вложенность — один прямоугольник внутри другого. Подписи узлов — текст внутри границ. Связи — линии между узлами и наконечники. Подписи связей — текст рядом с линией. Стили — цвет заливки, цвет и тип рамки.
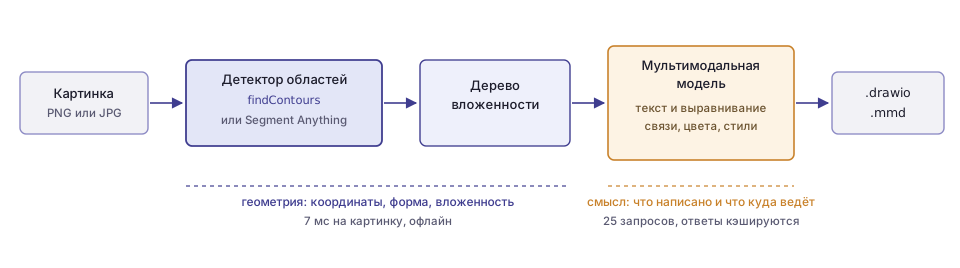
Первые два — чистая геометрия, их закрывает компьютерное зрение. Последние четыре требуют понимания того, что нарисовано. Линию между блоками ещё можно найти по пикселям, а направление стрелки, подпись и цвет словами — уже не так просто. Разница между этими строками и определила всю архитектуру, но понял я это не сразу.
Попытка собрать прямоугольники из отрезков
Первый прототип (сейчас он лежит в репозитории как legacy/vectorizer.py) исходил из того,
что схема состоит из линий. Значит, надо найти линии, а из них собрать фигуры.
Сразу скажу, что этот прототип долго не прожил. Но рассказать о нём надо, потому что lessons learned часто самое важное, что читатель может взять из таких статей. Повторить решение за кем-то много ума не надо.
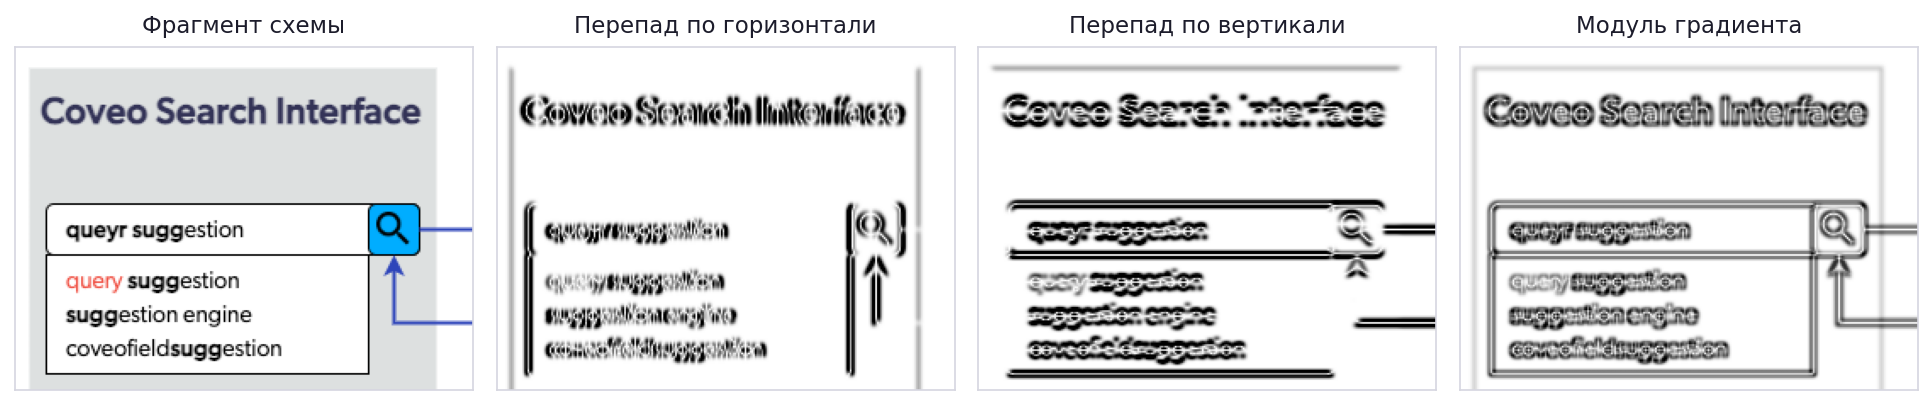
Конвейер был такой. Сначала так называемая бинаризация, в три слоя. Адаптивный порог по среднему, градиент Собеля для слабоконтрастных границ, Canny поверх градиента и утончение до линий толщиной в пиксель.
Не пугайтесь, сейчас расскажу. Градиент Собеля — это способ измерить, насколько резко меняется яркость в каждой точке картинки. Берётся окошко три на три пикселя и прикладывается к изображению дважды. Один раз оно сравнивает левый столбец с правым, другой раз — верхнюю строку с нижней, причём средним пикселям в каждой тройке даётся двойной вес, чтобы шум меньше мешал. Получаются два числа — насколько яркость растёт по горизонтали и насколько по вертикали. Из них по теореме Пифагора складывается сила перепада, а заодно можно вычислить и направление этого перепада. Там, где картинка ровная, например посреди чистого листа или внутри жирного штриха, это число близко к нулю; там, где светлое переходит в тёмное, оно подскакивает. Прелесть в том, что градиенту безразлична сама яркость, ему важна только разница между соседями. Например, бледная карандашная линия на сером фоне, которую порог по среднему проглотит как «примерно фон», всё равно даст заметный всплеск, потому что граница-то у неё есть. Поэтому второй слой и ловил то, что первый пропускал.
Canny же — это следующий шаг, который превращает размытую карту перепадов в чёткие контуры. Собель ведь отвечает честно, но неряшливо. Вокруг каждой границы у него получается широкая полоса, где перепад «довольно сильный», и непонятно, где именно проходит линия. Canny сначала слегка размывает картинку, чтобы отдельные шумные пиксели не притворялись границами, затем идёт вдоль каждой такой полосы и оставляет в ней только гребень, то есть те точки, где перепад сильнее, чем у соседей поперёк границы. Всё остальное гасится, и полоса худеет до ниточки. А дальше точки с перепадом выше верхнего порога объявляются границей безоговорочно, ниже нижнего выбрасываются, а те, что посередине, оставляются, только если они соприкасаются с уже принятыми. Благодаря этому слабый участок линии, который сам по себе не прошёл бы отбор, выживает, потому что держится за сильный, а одинокое пятнышко шума той же яркости исчезает, потому что держаться ему не за что. На выходе вместо серой карты получается чёрно-белый рисунок из тонких связных линий.
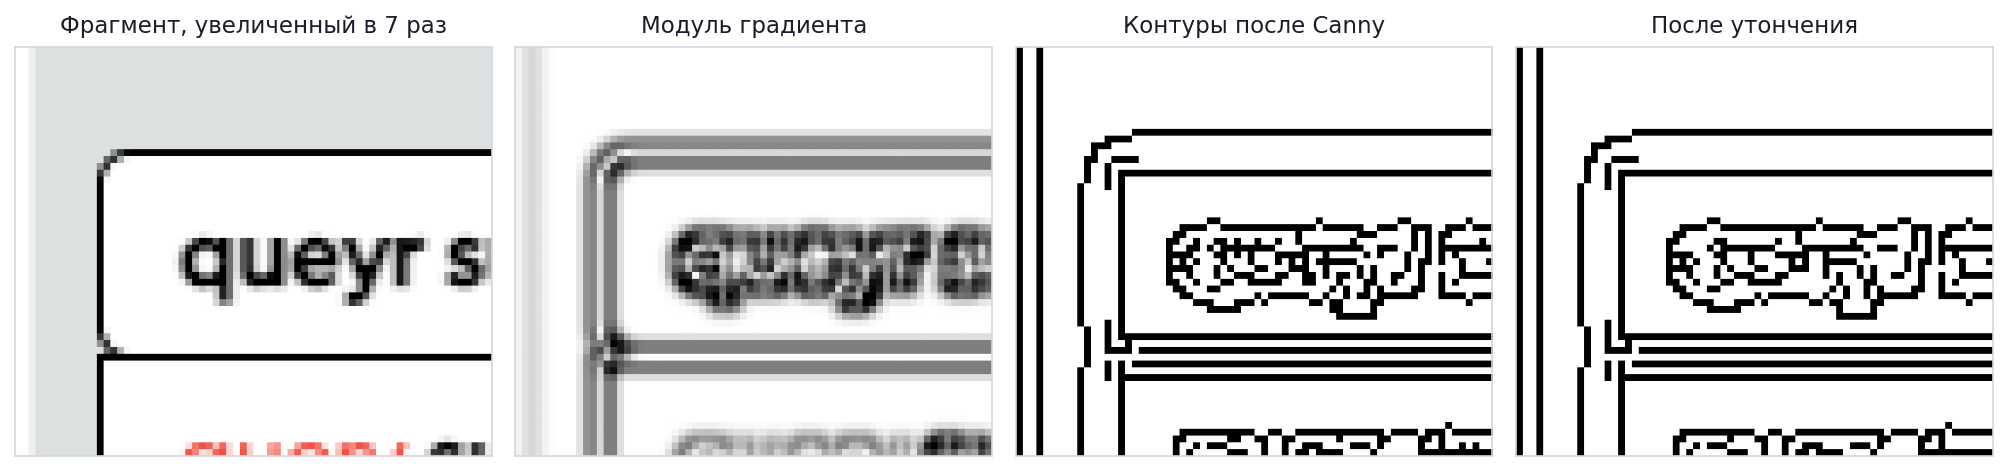
Мелкие связные компоненты площадью меньше 100 пикселей выбрасывались как текст. Потом морфологией искалась «сетка» схемы. Она нужна, чтобы в итоге схема смотрелась аккуратно. При переводе из растра всегда что-то «скачет», и нужно притягивать к сетке, если возможно.
Здесь используются подходы, которые по науке называются эрозия и дилатация. Конкретно в этом
случае ещё и ядром шириной cols // 40, что оставляет только длинные горизонтали, и ядром
высотой rows // 40 — только вертикали.
Эти два умных слова — простейшие действия над чёрно-белой картинкой, и вместе они работают как сито по форме.
В случае эрозии берётся «ядро», в нашем случае полоска высотой в один пиксель и длиной в одну сороковую ширины картинки (для изображения в 1024 пикселя это 25 пикселей). Эрозия прикладывает эту полоску к каждой точке и оставляет точку закрашенной, только если закрашено всё, что под полоской. Горизонтальная линия длиннее 25 пикселей такое испытание проходит, хотя и укорачивается с концов. А вот буква, вертикальная линия толщиной в пару пикселей или пятнышко шума исчезают целиком, потому что полоска в них нигде не помещается.
Дилатация делает обратное. Она закрашивает точку, если под полоской есть хоть один закрашенный пиксель, и тем самым отращивает выжившим линиям съеденные концы. То, что исчезло, уже не вернётся, так как отращивать не из чего.
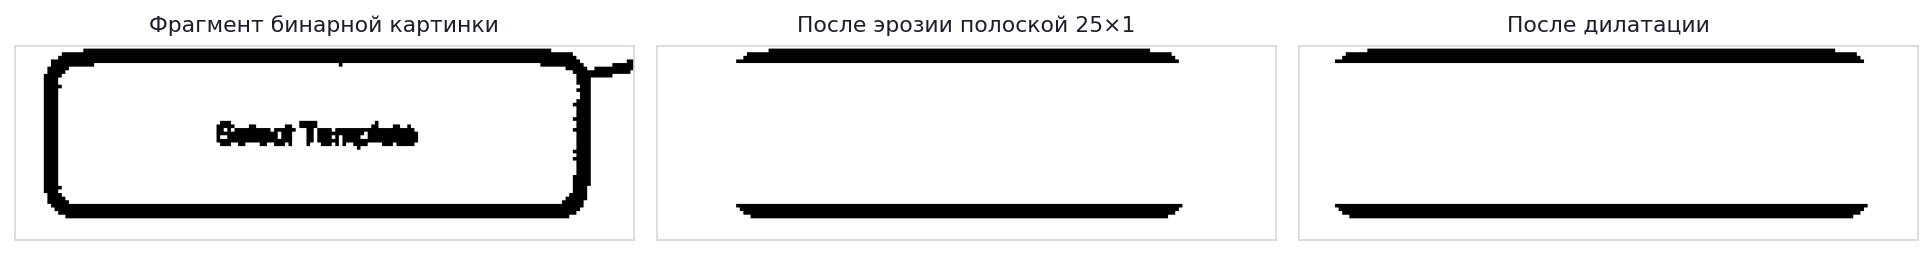
В итоге на картинке остаются только длинные горизонтали. Потом полоску ставят вертикально, высотой в одну сороковую высоты картинки, и тем же способом получают только длинные вертикали. Деление на сорок вместо фиксированного числа пикселей нужно, чтобы «длинное» означало одно и то же на маленькой и на большой картинке.
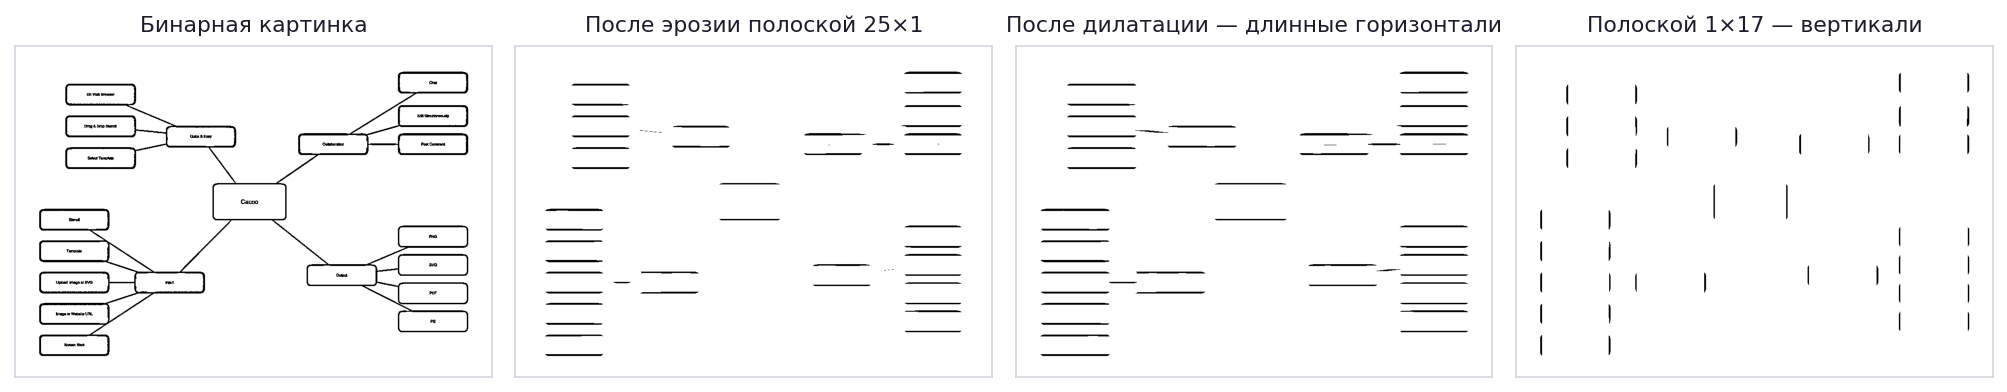
По найденным координатам сетки шёл построчный проход пикселей, который доставал отрезки даже там, где алгоритм Хафа их не видел. Дальше — слияние коллинеарных отрезков с проверкой, что разрыв между ними не проходит внутри блока и не пересекает пустоту длиннее 15 пикселей.
Что за Хаф? Всё просто. Преобразование Хафа — это способ найти на картинке прямые с помощью голосования. Через одну закрашенную точку можно провести сколько угодно прямых, и сама по себе точка не знает, на какой из них лежит. Поэтому она голосует за все сразу. Каждая прямая описывается двумя числами, углом наклона и расстоянием от угла картинки, и для всех возможных пар заводится таблица счётчиков. Точка перебирает углы с шагом, скажем, в градус, для каждого вычисляет, на каком расстоянии прошла бы через неё прямая с таким наклоном, и добавляет единицу в соответствующую ячейку. Когда проголосовали все точки, в таблице видны пики. Если сто точек действительно лежат на одной прямой, то все сто отдали голос за одну и ту же ячейку, а остальные их голоса размазались по таблице тонким слоем. Ячейки, где голосов больше порога, объявляются найденными прямыми.
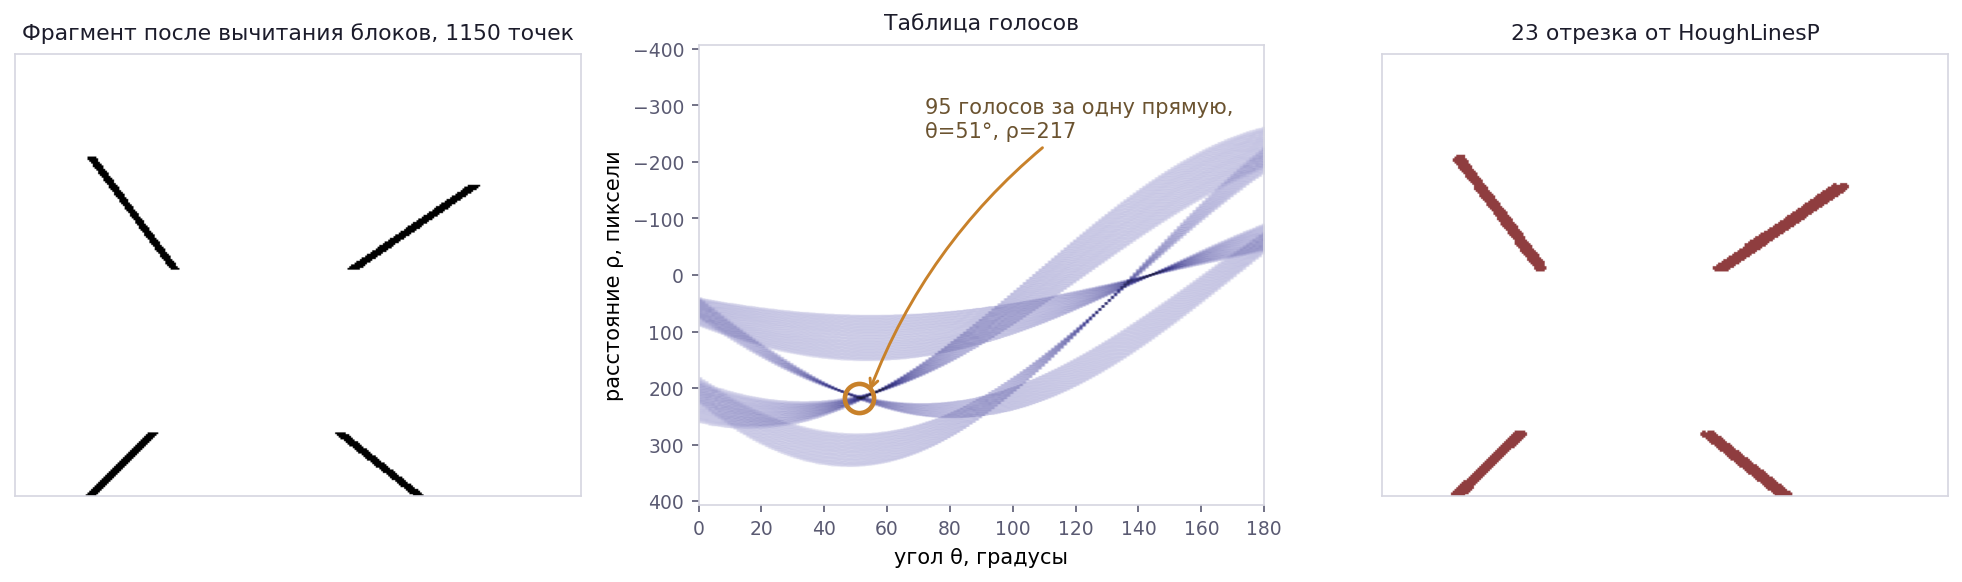
Прелесть метода в том, что ему не мешают разрывы. Пунктир или линия, перечёркнутая текстом, набирают голоса так же, как сплошная. Слабость в том, что короткий отрезок набирает мало голосов и тонет под порогом, а толстая или чуть неровная линия делит свои голоса между соседними ячейками и тоже может не дотянуть. Именно в таких местах построчный проход по сетке и находил то, чего Хаф не видел.
Классический вариант возвращает бесконечные прямые, без начала и конца. В OpenCV поэтому
обычно берут HoughLinesP, вероятностную версию. Она голосует не всеми точками, а случайной
выборкой, и, найдя прямую, проходит вдоль неё по картинке и возвращает конкретные отрезки с
координатами концов. Параметров у неё два — минимальная длина отрезка и максимальный разрыв,
который ещё считается той же линией.
И наконец синтез прямоугольников — перебор пар горизонталей и пар вертикалей с проверкой, что все четыре угла сошлись:
G = min(w, h) * 0.15
d_tl = dist(v1['p1'], h1['p1'])
d_bl = dist(v1['p2'], h2['p1'])
d_tr = dist(v2['p1'], h1['p2'])
d_br = dist(v2['p2'], h2['p2'])

if max(d_tl, d_bl, d_tr, d_br) <= G:
    # четыре отрезка сошлись углами — считаем это прямоугольником
На выходе получался SVG из линий и прямоугольников — вектор, который по-прежнему не был схемой. Ни подписей, ни связей, ни знания о том, что блок A соединён с блоком B.
Поэтому в существенной части я его похоронил.
Из этого прототипа в текущий код переехали три приёма — маскировать найденные блоки перед поиском линий, проверять, что разрыв между отрезками не пересекает блок, и прилипать концами к границам блоков. Остальное пришлось выбросить.
Контур вместо четырёх отрезков
Следующая мысль очевидна, когда уже набил шишки на предыдущей — замкнутая фигура и так
приходит из findContours целиком, собирать её из отрезков незачем.
Текущий детектор делает так:
gray    = cv2.cvtColor(image, cv2.COLOR_BGR2GRAY)
blurred = cv2.GaussianBlur(gray, (3, 3), 0)
thresh  = cv2.adaptiveThreshold(blurred, 255, cv2.ADAPTIVE_THRESH_GAUSSIAN_C,
                                cv2.THRESH_BINARY_INV, 11, 2)
canny   = cv2.Canny(blurred, 30, 100)
binary  = cv2.bitwise_or(thresh, canny)
binary  = cv2.morphologyEx(binary, cv2.MORPH_OPEN, np.ones((2, 2), np.uint8))
Для тех, кто видит код OpenCV в первый раз — немного расскажу.
cvtColor переводит картинку в оттенки серого. Цвет для поиска границ не нужен, а одно число на пиксель обрабатывать проще, чем три. BGR в названии не опечатка, OpenCV по историческим причинам хранит каналы в порядке «синий, зелёный, красный».
GaussianBlur слегка размывает картинку окошком три на три, чтобы зерно сжатия и одиночные шумные пиксели не превратились потом в ложные границы. Ноль в конце означает «силу размытия подбери сам по размеру окна».
adaptiveThreshold — адаптивный порог. Обычный порог сравнивает каждый пиксель с одним числом на всю картинку и ломается, если фон местами светлее, местами темнее. Адаптивный сравнивает пиксель со средним по его окрестности, здесь это квадрат 11 на 11, причём ближние соседи весят больше дальних. Если пиксель темнее этого среднего хотя бы на 2, он считается «чернилами». BINARY_INV переворачивает результат: чернила становятся белыми, фон чёрным. Так принято в OpenCV, где белое означает объект, а чёрное пустоту.
Дальше уже знакомый Canny с нижним порогом 30 и верхним 100. bitwise_or объединяет две картинки — пиксель белый, если он белый хотя бы на одной из них. И последнее, morphologyEx — морфологическое открытие, та же эрозия с дилатацией, что и в старом прототипе, только ядром два на два. Всё, что мельче такого квадратика, исчезает, остальное сохраняет форму.
Часто пишут, что адаптивный порог берёт заливки. С окном 11 на 11 это не совсем так: внутри ровной заливки пиксель равен среднему по соседям и порог не проходит. На деле порог берёт штрихи, текст и контрастные края заливок, Canny добирает слабые границы там, где заливки нет, а морфологическое открытие убирает песок.
Потом замыкание ядром 5×5 заращивает разрывы, и по полученной картинке идёт findContours.
Что за замыкание? Дальше нужно залатать рамки. После порога и Canny в них почти всегда
остаются дырочки в один-два пикселя. Где-то линия была бледной, где-то её перебило
сглаживание. Для глаза это незаметно, а для алгоритма рамка с дырочкой уже не замкнутая
фигура, её внутренность сливается с фоном снаружи. Поэтому все линии сначала утолщаются на
пару пикселей в каждую сторону, и мелкие разрывы при этом срастаются. Потом линии обратно
худеют на столько же, но сросшиеся места уже не расходятся. Как раз это называется
морфологическим замыканием, ядро у него пять на пять, так что зарастают разрывы до четырёх
пикселей. После этого в дело идёт findContours, который проходит по границе каждой области
на картинке и возвращает её целиком, готовым списком точек по периметру. Вот это и есть те
самые замкнутые фигуры, которые старый прототип мучительно собирал из четырёх отрезков.
Далее каждый контур классифицируется по набору метрик, таких как круглость 4πS/P²,
заполненность «площадь к площади описывающего прямоугольника», отношение сторон, гладкость
как число точек контура на единицу периметра, количество вершин после approxPolyDP и после
выпуклой оболочки, отклонение углов от 90°.
Если 3 вершины у выпуклой оболочки — это треугольник. Если круглость больше 0.8 и стороны почти равны — пусть это будет круг. Если круглость больше 0.62 и контур гладкий, то пытаемся найти в этом эллипс или цилиндр. Четыре вершины, заполненность меньше 0.62, стороны минимального прямоугольника — от 0.55, то назовём это ромбом, а если углы отклоняются больше чем на 18 градусов, то параллелограммом. Во всех остальных случаях назовём фигуру прямоугольником.
Очевидно, что для таких правил правильнее было бы использовать ML, но это следующий этап когда-нибудь в будущем.
Отдельная проверка отличает цилиндр (значок базы данных) от эллипса. У цилиндра ширина маски в средних строках почти постоянна, поэтому берутся строки с четверти до трёх четвертей высоты, и если разброс ширины меньше 10%, это цилиндр. Так себе критерий, но для прототипа пойдёт. Опять же, это отличное направление для ML.
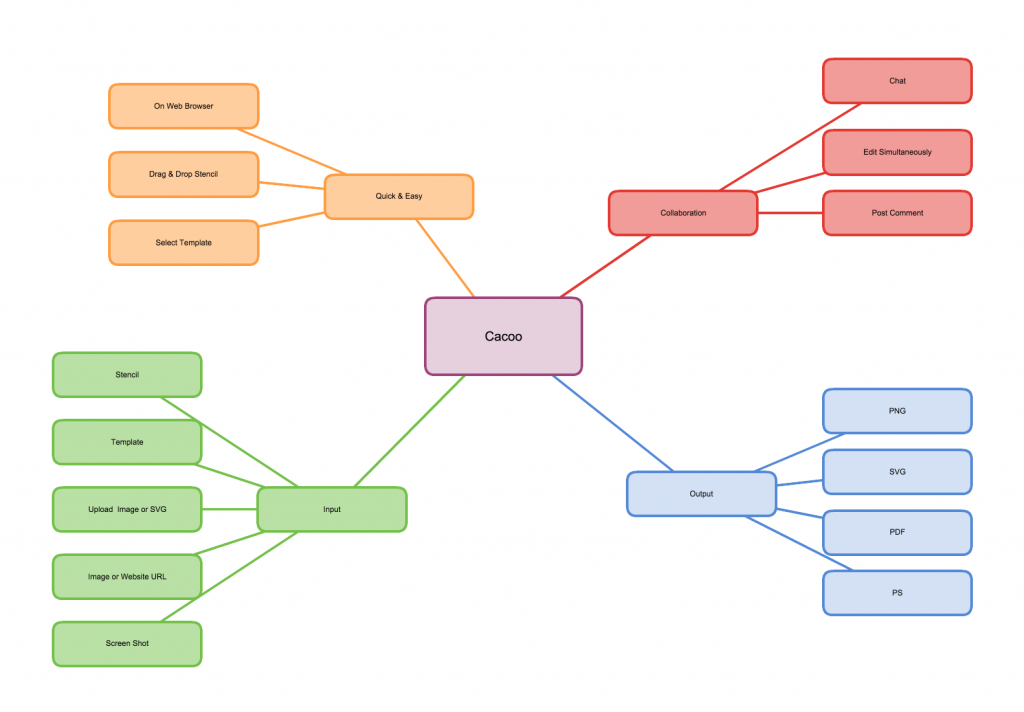
Можно показать на двух тестовых картинках. Первая — простая mind map из Cacoo, 1024×712 — двадцать блоков с заливкой, скруглённые углы, линии без стрелок.
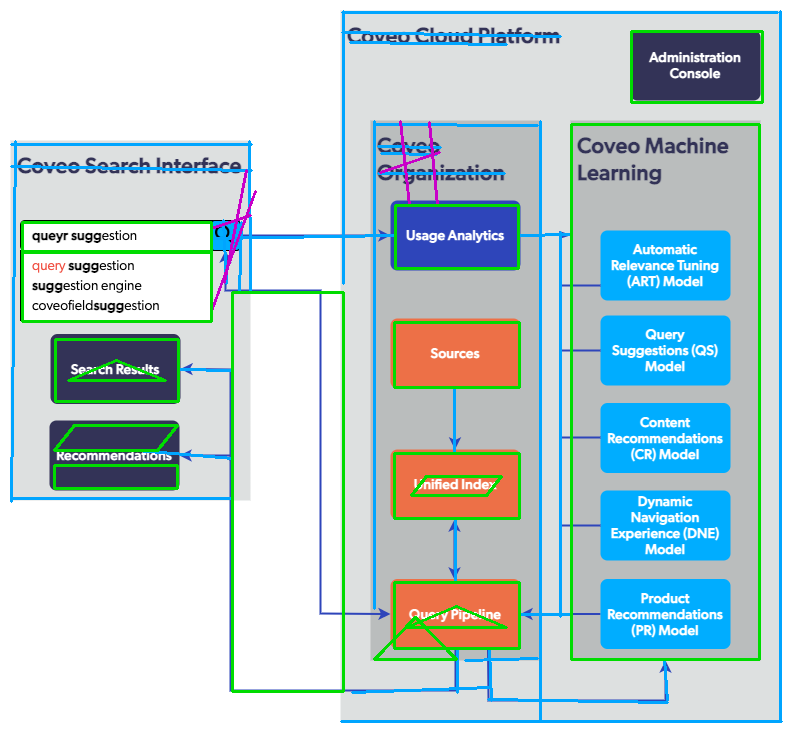
Вторая — схема архитектуры Coveo, 791×731 — вложенные контейнеры, блоки с многострочными подписями, стрелки с изломами и фон у контейнеров.
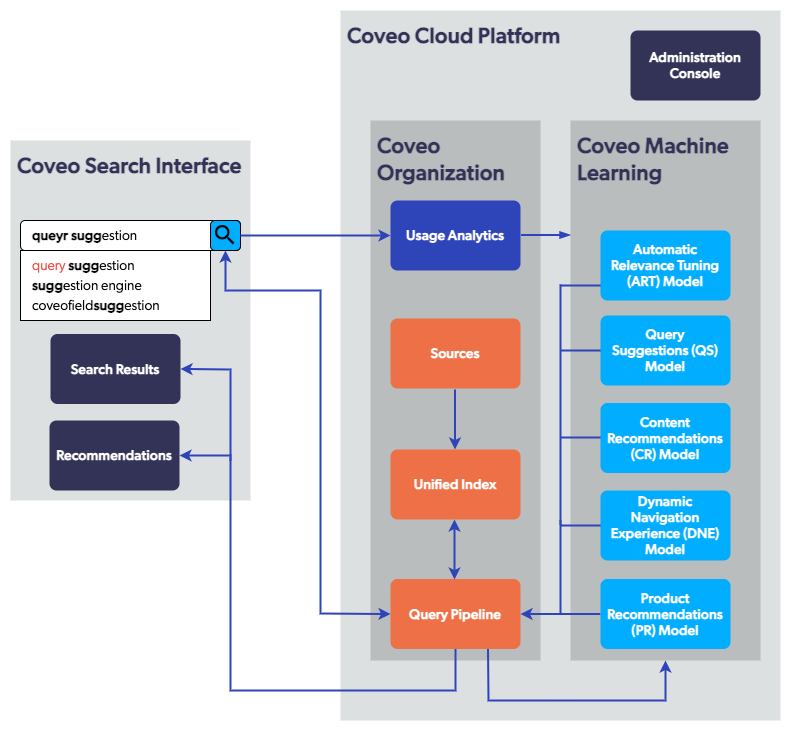
На первой детектор находит 23 фигуры за 7 мс, на второй — 16 фигур за 4 мс. Это на Core Ultra 9 285K, без видеокарты и без сети. Не то чтобы это было что-то особенное, просто всё дальнейшее, что связано с моделью, работает на три-четыре порядка медленнее.
Дубликаты убираются по IoU с порогом 0.5, потому что одна рамка обычно даёт и внешний, и внутренний контур.
Дырки вместо рамок
Так вот, я проверил связность на схеме Coveo. После морфологического замыкания вся диаграмма — одна связная компонента. Рамка внешнего контейнера, рамка вложенного блока, стрелки между ними — всё это компонента номер один из восемнадцати. Линии касаются рамок, рамки касаются рамок, и картинка склеивается в один уродливый блоб.
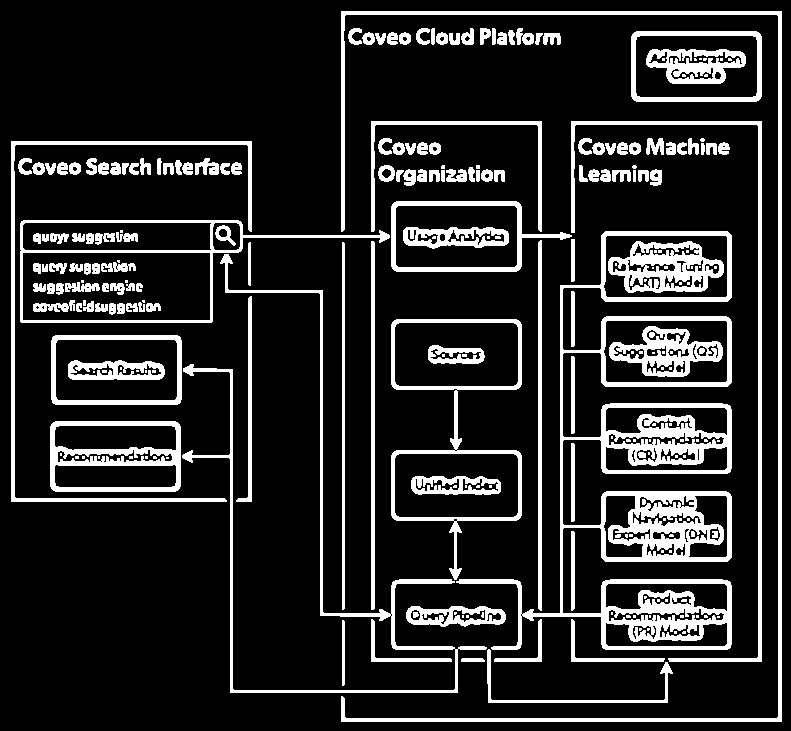
Значит, отдельных внешних контуров у блоков нет. То, что доходит до классификатора, — это дырки. Белая внутренность блока, серый фон контейнера за вычетом всего вложенного. Поэтому координаты блока всегда чуть меньше видимых. Блок Sources на картинке занимает примерно (390,318)–(521,391), а детектор возвращает (394,322)–(519,387).
Из этого следуют сбои, которые я до этой проверки видел, но не умел объяснить.
Во-первых, самый большой контейнер исчезал.
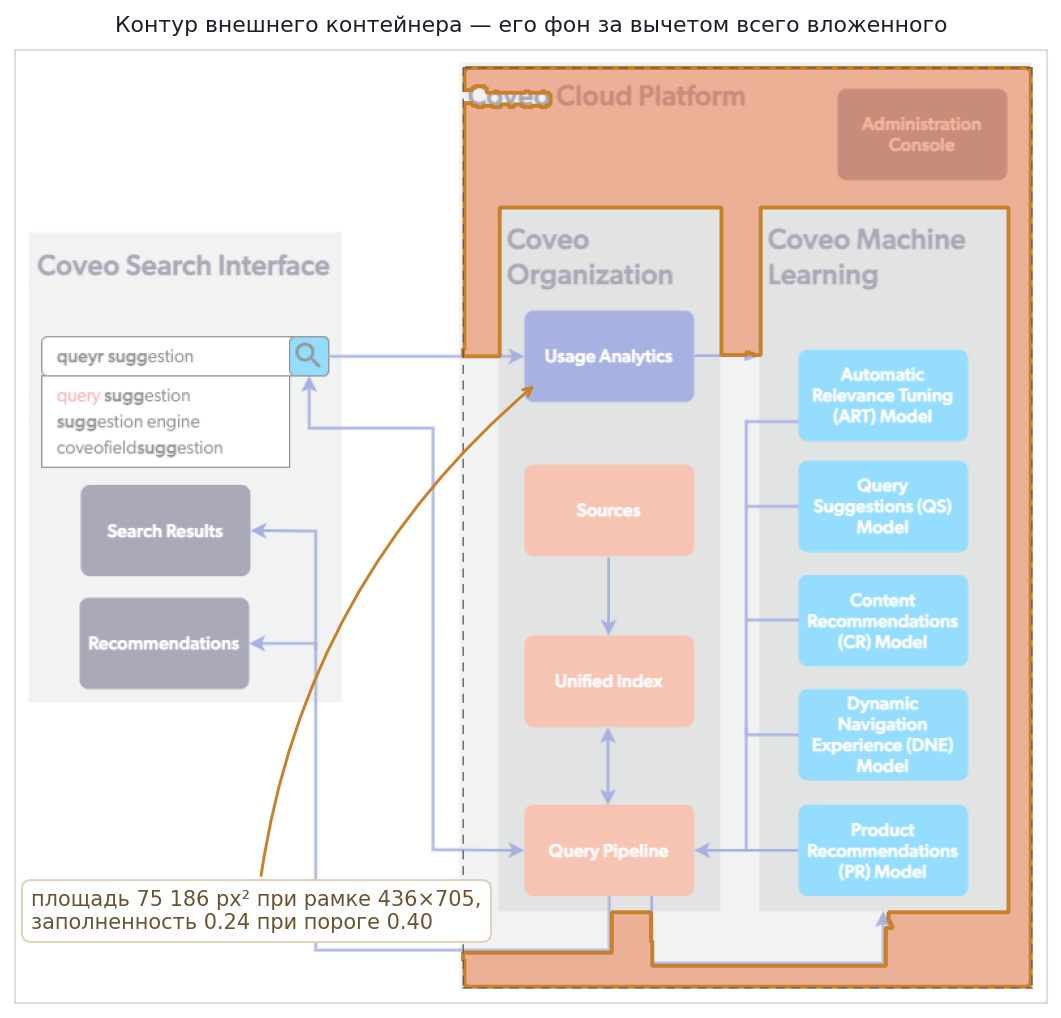
Его дырка — это фон за вычетом вложенных блоков и линий. Площадь такой фигуры 75 186 px² при описывающем прямоугольнике 436×705, то есть заполненность 0.24 при пороге 0.40. Контейнер отбрасывается как слишком дырявый.
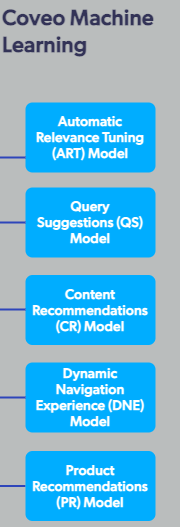
Во-вторых, блоки с длинным текстом исчезают. У пяти голубых блоков в колонке Coveo Machine Learning подписи в три-четыре строки дотягиваются до краёв и режут дырку на полоски. В списке контуров вместо пяти блоков лежат обрывки их внутренностей — полоски 123×28 с заполненностью 0.5–0.64 и пятью вершинами. Проверка «четыре вершины или выпуклый с заполненностью выше 0.72» их не пропускает.
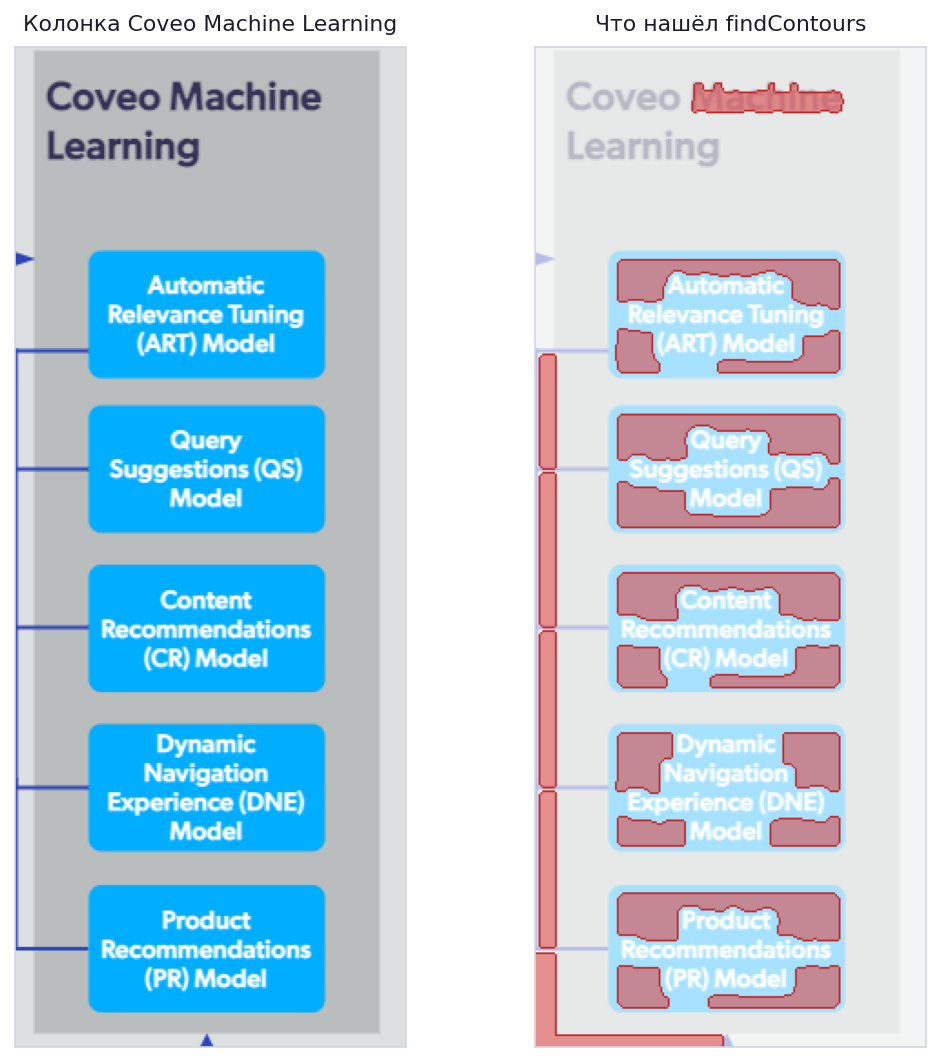
findContours вернул в этом месте. Это куски внутренности блоков, разрезанные строками подписи; контура самой рамки среди них нет ни у одного из пяти блоков.В-третьих, появляются фигуры, которых нет. Дырка между тремя пересекающимися линиями — треугольник по всем метрикам, и классификатор записывает его как треугольник. На mind map таких три, на схеме Coveo ещё три плюс два параллелограмма, сложившихся из текста.
Итог по схеме Coveo... 16 найденных фигур — 11 настоящих блоков, три фантомных треугольника и два параллелограмма. Плюс потеряны пять голубых блоков и внешний контейнер.
На mind map результат заметно лучше — 20 блоков из 20 плюс три фантомных треугольника между расходящимися линиями.
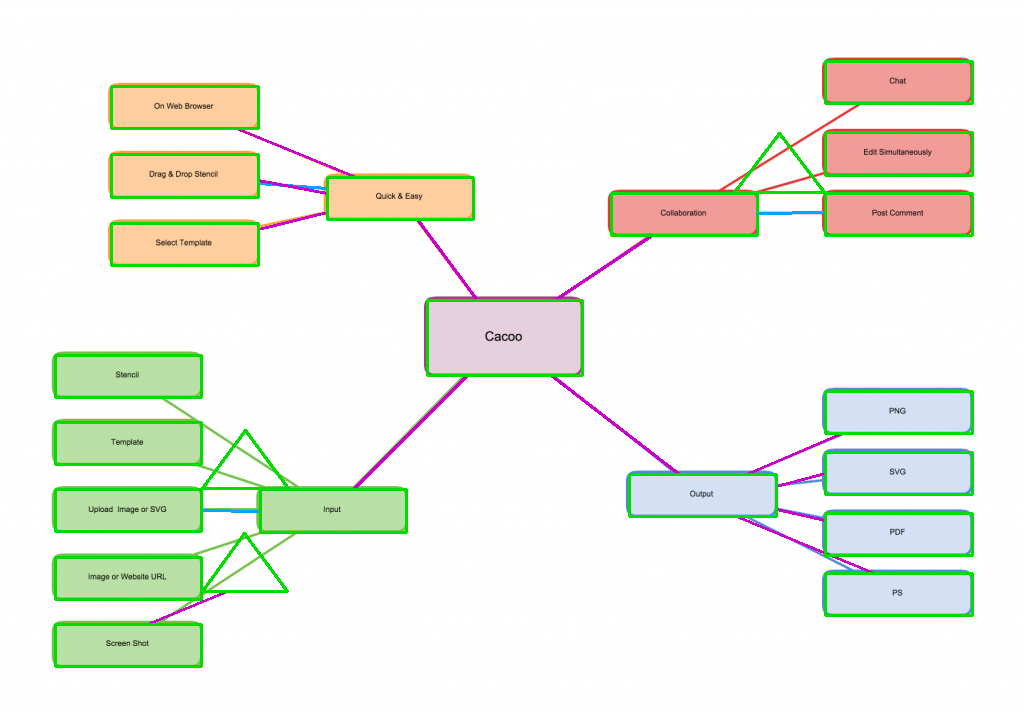
Подкрутка порогов это не чинит. Нужен детектор, который ищет блок по заливке, а не по границе. Заливка у блока однородная, и текст внутри её не разрезает. Мой старый прототип, кстати, умел искать блоки по насыщенности в HSV — я прогнал его на этой же картинке, и он нашёл ровно три блока, все тёмно-синие. Так что просто вернуть его недостаточно.
Сегментация нейросетью
Раз классические контуры ломаются на сложных картинках, логично попробовать модель сегментации. И я попробовал две.
Mask R-CNN через detectron2 с весами COCO. Модель обучена на фотографиях и на схеме ищет кошек, стулья и людей. Ничего полезного на диаграммах она не дала, и в зависимостях проекта detectron2 так и не появился.
Segment Anything. Эта сегментирует что угодно, в том числе схемы. Проблема ровно обратная. SAM возвращает все области подряд и не знает, что такое «блок диаграммы». Для одной картинки это сотни масок — рамки, заливки, буквы, куски стрелок.
Поэтому поверх масок стоит набор фильтров.
Фильтр stability_score, predicted_iou имеет порог 0.88 и отсекает неуверенные маски,
которые выбрасываются совсем. Фильтр по площади отсекает слишком мелкие объекты, к сожалению,
включая и текстовые блоки (настройка 0.2% от площади картинки). Также отсекаются
разнообразные повёрнутые области, потому что обычно на диаграммах таковых нет (да, спорно).
Наклон до 10 градусов просто прижимается к осям — схемы рисуют по сетке, и пара градусов
обычно означает сглаживание при растеризации, а не задумку автора.
Всё, что не прошло фильтры, не выбрасывается, а помечается как фрагмент. С флагом
--embed-fragments фрагменты попадают в .drawio картинками в base64. Иконку из трёх кривых
инструмент всё равно не превратит в фигуру, так пусть она останется иконкой, стоящей в нужном
месте.
Чего компьютерное зрение не даёт
После детектора у меня есть координаты, формы и вложенность. Нет текста, направления стрелок, подписей на связях и цветов, названных словами.
Классический OCR тут требует возни. Текст мелкий, лежит поверх цветной заливки, в блоке бывает три строки с разным выравниванием. А для стрелок классического решения нет вообще — наконечник нужно искать отдельным детектором и сопоставлять с концом линии.
Поэтому семантику я отдал мультимодальной модели. В моём случае я использовал модели Gemini, но разницы особо нет, пойдёт любая. Но отдал не всю задачу — просить у модели пиксельные координаты блоков не супер идея, потому что проверить их нечем, часто там галлюцинации, а компьютерное зрение выдаёт те же координаты точно, воспроизводимо и бесплатно. Разделение получилось такое: геометрия — CV, смысл — модель.
Три запроса на одну картинку
В модель в итоге отправляется три запроса.
Первый — OCR, и отправляется кроп одного блока. То есть фрагментик картинки, в случае схем это часто блок какой-нибудь. Возвращается кроме текста из модели как выровнен текст относительно блока, как по горизонтали, так и по вертикали. Это потом переносится в draw.io.
Второй запрос — связи. Отправляется вся картинка, а от модели мы ждём массив из (src, dst, direction, label, style, color). Третий запрос — стили по блоку. Каждый элемент — (border color, bg color, border style, border width).
Для второго и третьего запроса картинка сначала размечается. Поверх копии изображения
рисуются найденные фигуры, и в центр каждой красным пишется её номер. Модель получает
изображение и список вида Box 7: "Usage Analytics" at (55,339)-(178,401), и отвечает
номерами, а не описаниями. Это снимает задачу сопоставления ответа с геометрией.
Промпт для связей выглядит так:
Find all connections (arrows, lines) between boxes. Return a JSON array where each item has:
- "src": source box ID (integer)
- "dst": destination box ID (integer)
- "direction": "forward", "backward", "bidirectional", or "none"
- "label": text label on the arrow/line ("" if none)
- "style": "solid", "dashed", or "dotted"
- "color": one of [black, white, gray, red, green, blue, ...]
Насколько это работает. На mind map модель вернула 19 связей — ровно столько, сколько рёбер в
дереве из 20 узлов, и топология совпала с картинкой. Центральный узел соединён с четырьмя
ветками, каждая ветка со своими листьями. Все связи с direction: none и пустыми подписями,
что тоже верно: стрелок и подписей на этой схеме нет.
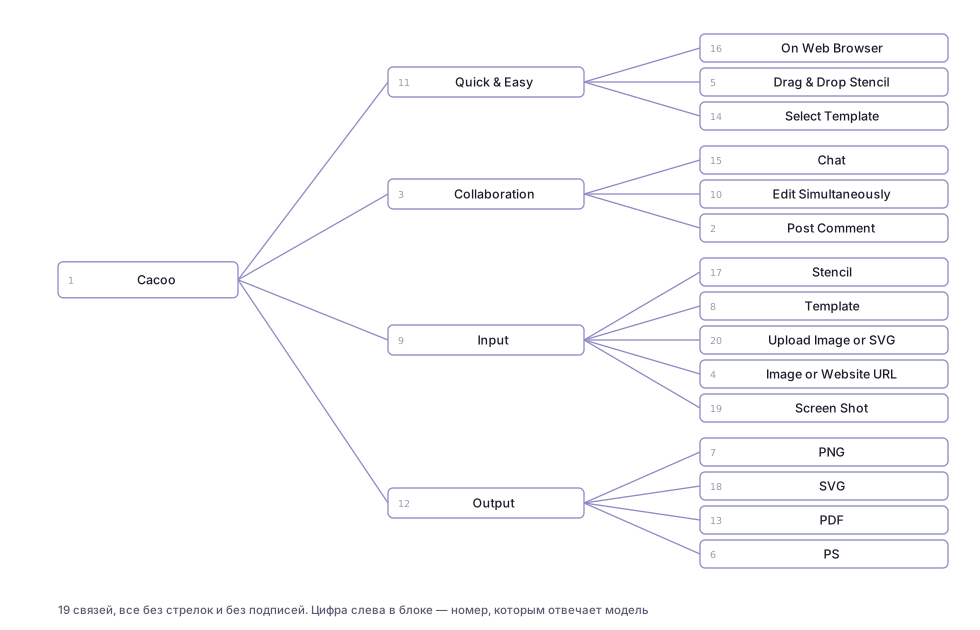
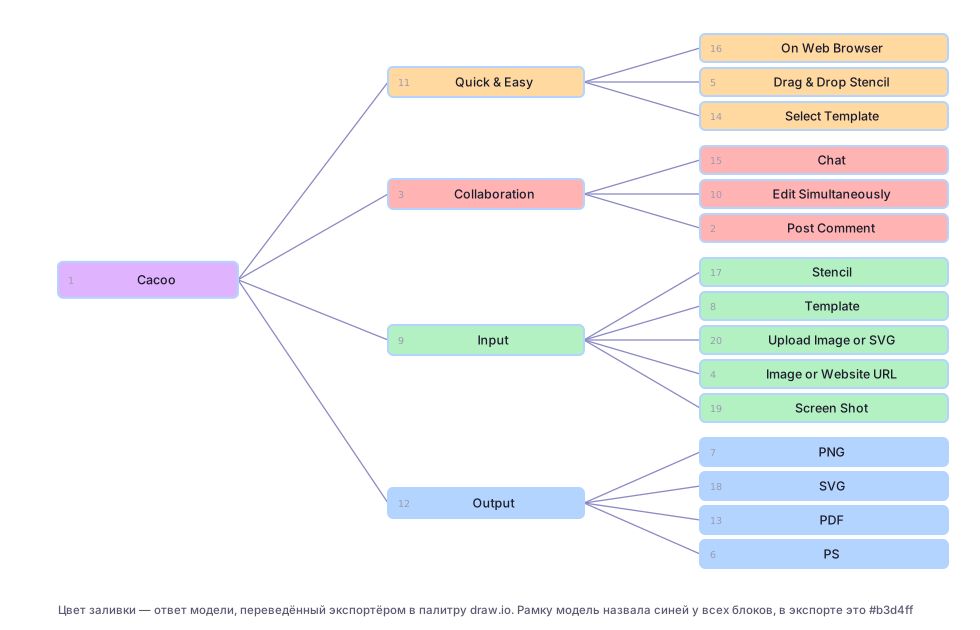
Со стилями интереснее. Модель вернула стили для 21 фигуры из 23, и набор цветов фона назвала точно: 6 зелёных, 5 синих, 4 красных, 4 оранжевых и 1 фиолетовый — ровно то, что нарисовано, двадцать блоков по веткам. Двадцать первой фигуре достался белый. А цвет рамки она назвала синим у всех 21 фигуры, хотя у каждой ветки схемы рамка своего цвета. То есть заливку, которая занимает большую площадь, модель видит, а тонкую рамку — додумывает.
OCR читает текст дословно, вместе с опечатками автора. На схеме Coveo в поле поиска написано «queyr suggestion», и ровно это приехало в подпись блока. Для реконструкции так и нужно.
Выравнивание модель тоже возвращает, и оно доезжает до draw.io. У контейнеров на схеме Coveo
подпись стоит сверху слева, модель вернула align: left, valign: top, и в .drawio ячейка
получила align=left;verticalAlign=top.
Цена. На mind map с 23 найденными фигурами это 23 запроса OCR плюс два общих, то есть 25
обращений к API на одну картинку. Поэтому все три шага кэшируются в temp/ — повторный
прогон той же картинки не тратит ни одного запроса. Складывать все кропы в один запрос я пока
не стал, хотя это первое, что надо сделать для скорости.
Зачем нужна вложенность
Для каждого блока ищется самый тесный объемлющий его блок — он и становится родителем, а обход в ширину от корней раздаёт глубину. Дерево считается за один проход и стоит недорого.
Главный потребитель дерева — OCR. В кроп контейнера попадают все вложенные блоки со своими подписями, и модель прочитает их все и склеит в одну строку. Поэтому перед запросом области «детей» в кропе забеливаются, и модель видит только собственную подпись контейнера.
На схеме Coveo этот механизм не сработал — по причине из раздела про дырки. Пять голубых блоков не нашлись, детей у контейнера нет, маскировать нечего, и в запрос ушёл вот такой кроп:
А ещё вложенность пока не доезжает до экспорта. В .drawio все ячейки лежат с parent="1", в
Mermaid нет subgraph. Дерево живёт только ради чистого OCR, хотя данные для настоящей
вложенности уже посчитаны.
Линии, которые никуда не идут
Геометрический поиск связей включается флагом --enable-connections и устроен так.
Сначала из бинарной картинки вычитаются блоки. Листовые закрываются целиком с запасом 8
пикселей, а контейнеры — только полосой по рамке шириной 14 пикселей, иначе вместе с
контейнером пропадут все связи внутри него. По остатку идёт HoughLinesP (помните, что это
такое? пролистайте наверх, теперь уже не забудете), отрезки делятся на горизонтальные,
вертикальные и диагональные с допуском 5 градусов, коллинеарные сливаются с проверкой, что
разрыв не проходит через блок. Дальше отрезок проверяется на покрытие. Вдоль него берутся
пиксели исходной картинки, и если закрашено меньше 4%, отрезок выдуман. Концы прилипают к
границам блоков в радиусе 60 пикселей, дубликаты убираются.
На mind map в итоге остаётся 15 отрезков (3 горизонтальных и 12 диагональных), на схеме Coveo — 39 (19 горизонтальных, 14 вертикальных, 6 диагональных). На наложениях выше это сиреневые и голубые линии, и геометрия у них верная: линии идут от края блока до края блока.
При этом в .mmd и .drawio эти линии не попадают. Связи в экспорте целиком от модели, а
результат Хафа рисуется только в отладочные картинки, и это главный незакрытый пункт проекта.
Два источника дополняют друг друга идеально: линии дают факт соединения и точки крепления,
модель — направление, подпись и стиль. Сейчас, если модель придумает связь, которой на
картинке нет, проверить её нечем — хотя данные для проверки уже лежат в соседней переменной.
Mermaid и draw.io
Экспорт идёт в два формата сразу, и они решают разные задачи.
Mermaid хранит топологию и теряет координаты. Раскладку он делает сам. Форма узла кодируется синтаксисом, стили — отдельными директивами:
flowchart TD
    box1["Cacoo"]
    box9["Input"]
    box17[("Stencil")]
    box1 --- box9
    box9 --- box17
    style box1 fill:purple,stroke:blue,stroke-width:2px
Draw.io хранит всё остальное. Это mxGraphModel с пиксельными координатами исходной картинки,
так что результат ложится поверх оригинала. Ячейка одного блока выглядит так (переносы строк
мои, в файле это одна строка):
<mxCell id="box7" value="Usage Analytics"
        style="rounded=0;whiteSpace=wrap;html=1;fillColor=#b3d4ff;strokeColor=#333333;
               strokeWidth=2;dashed=0;align=center;verticalAlign=middle;"
        vertex="1" parent="1">
  <mxGeometry x="55" y="339" width="123" height="62" as="geometry" />
</mxCell>
Цвет модель называет словом из списка в двенадцать названий, а экспортёр превращает слово в
конкретный пастельный оттенок. yellow превращается в #fffacc, cyan превращается в
#b3f0f0. Поэтому палитра на выходе похожа на исходную, но не совпадает с ней. Вот исходная
схема и её реконструкция:
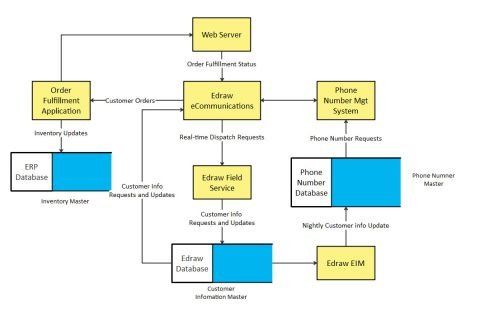
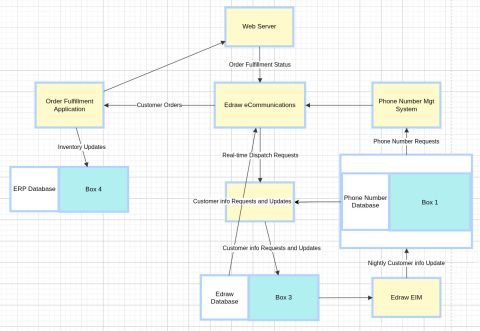
Подписи, стрелки и расположение восстановились, а иконки баз данных распались. Двухцветный значок — белая левая часть и голубая правая — даёт два отдельных контура, и правая половина остаётся прямоугольником без текста, то есть «Box 4» рядом с «ERP Database». Это тот самый случай, ради которого в SAM-ветке сделано вшивание фрагментов картинкой.
Второе типичное украшение — наложение подписей на рёбрах. Draw.io ставит подпись в середину ребра, и если два ребра идут рядом, две подписи оказываются в одной точке:
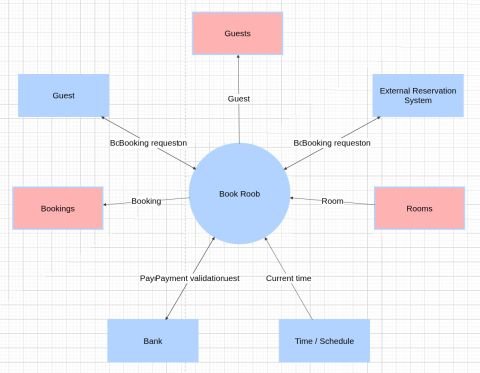
«BcBooking requeston» — это наложившиеся «Booking confirmation» и «Booking request». Лечится разведением точек крепления, и геометрия для этого опять-таки уже есть в линиях Хафа.
Грабли, на которые я наступил
Кэш с ключом по порядковому номеру. Результат OCR кладётся в файл
temp/<картинка>_box<N>_ocr.json, где N — номер блока в порядке обхода контуров. Порядок
зависит от детектора и от версии OpenCV. Когда я разложил монолит по модулям, нумерация
поехала, а кэш остался. Сегодня, пока писал статью, я это и увидел. В кропе diag1_box11.png
написано «On Web Browser», а в лежащем рядом diag1_box11_ocr.json — «Quick & Easy». Вся
разметка съехала на соседние блоки, и экспорт стал бессмыслицей, хотя и детектор, и модель
отработали правильно. Ключом должно быть содержимое кропа, скажем его хэш вместе с
координатами.
Кэширование ошибок. Если запрос упал, в кэш пишется {"text": ""}, и следующий прогон
берёт эту пустоту как готовый ответ. После проблем с ключом или сетью приходится вручную
удалять temp/*_ocr.json. Правильнее не писать кэш, когда поймано исключение.
Где взять
Репозиторий: github.com/raliev/diag-vectorizer.
Нужен Python 3.10+, OpenCV и ключ Google AI Studio в переменной GEMINI_API_KEY. Ветка с SAM
дополнительно требует torch, segment-anything и чекпойнт sam_vit_h_4b8939.pth на 2.5 ГБ,
который кладётся в корень проекта.
python -m venv .venv
.venv/bin/pip install -r requirements.txt
export GEMINI_API_KEY=...

# обычный прогон: контуры + модель
python diag.py input/diag1.png

# плюс геометрический поиск линий (пока только в отладочные картинки)
python diag.py input/diag1.png --enable-connections

# ветка SAM, с вшиванием нераспознанных фрагментов картинками
python diag.py input/diag1.png --algorithm sam \
    --sam-checkpoint sam_vit_h_4b8939.pth --embed-fragments
На выходе output/<имя>.mmd и output/<имя>.drawio, в temp/ — кропы, отладочные наложения
и кэш ответов модели. Первым делом стоит открыть temp/<имя>_overlay.png. По нему сразу
видно, что детектор нашёл, что пропустил и что выдумал, а это объясняет почти любую
странность в итоговом файле.
Что дальше
Ближайшее по пользе — свести геометрию и модель в одном месте. Линии Хафа подтверждают или опровергают каждую связь, которую назвала модель, и дают точки крепления; модель оставляет за собой направление, подпись и стиль.
Дальше — детектор, который ищет блоки по заливке. Это чинит пропавшие блоки с длинным текстом, пропавший внешний контейнер и заодно фантомные треугольники между линиями.
Потом — один запрос вместо двадцати трёх. Все кропы уходят в модель одним сообщением либо текст читается локальной OCR-моделью, а Gemini остаётся на стрелки и цвета.
И вложенность в экспорт: parent у mxCell в draw.io и subgraph в Mermaid. Дерево уже
посчитано, осталось его записать.
Что дальше, часть вторая. Фантазии
Раз вы дочитали до этого места, то уж поделюсь видением будущего «на полную катушку».
Вообще у меня была более обширная идея AI-инструмента для диаграмм, и всё, что описано выше, — только первый шаг к ней.
Идея в том, что мастер-документом для диаграммы — в Confluence или где угодно ещё — служит текст. Описание может быть (и должно быть) довольно подробным, чтобы диаграмма получалась именно такой, какой её представляет автор. Саму диаграмму при этом напрямую не редактируют, редактируют только описание. Точнее, подвигать кружочки можно, но после этого система должна обновить текст так, чтобы генерация из него давала ровно то, что надвигал пользователь.
Диаграмма должна соответствовать описанию настолько, насколько это возможно. Если соответствия добиться нельзя — условно, треугольник с тремя тупыми углами нарисовать не получится, — система делает максимум возможного и словами объясняет, что не вышло. Тогда пользователь меняет постановку задачи, пока результат его не устроит.
Но тут есть ловушка — автор мог попасть в удачный результат случайно, своим кривым текстом. Если перегенерировать, получится что-то другое, и не факт, что хорошее. Поэтому систему можно попросить составить по готовой диаграмме такое описание, из которого генератор воспроизведёт её в точности. Оно выйдет более многословным и многослойным, зато будет надёжно фиксировать результат. Какими словами и в каком объёме нужно описывать для воспроизводимости результата — непонятно, это одна из задач на ресерч.
С этого момента вы работаете уже не с диаграммой, а с текстом. Нужна диаграмма — компилируете текст и получаете то, что надо. Причём и текст вы правите не руками, а через LLM. Просите добавить блок — описание меняется, но так, чтобы внезапно не поменялось вообще всё.
На выходе диаграмма должна быть в объектной форме, из которой уже можно получить и растр (PNG), и вектор (SVG, EPS). Было бы здорово ещё и подавать на вход готовые диаграммы или шаблоны, чтобы система брала из них стили и принятые конвенции — что как изображать.
В общем, вот такие фантазии. Если у кого-то есть представление, как это реализовать, — давайте обсудим.
А тем, что уже готово, — пользуйтесь на здоровье, и, если можете сделать лучше, — делайте. Это приблизит нас к настоящему AI-редактору диаграмм.
Discussion
Powered by GitHub Discussions — sign in with a GitHub account to join the conversation.